
序論
1950年代の川喜田二郎による「KJ法」、1960年代の梅棹忠夫による「知的生産の技術」、1990年代の野口悠紀雄による「超整理法」という情報整理・発想技術の系譜を受け継ぎ、生成AIを高度な知能を備えた「知的パートナー」として位置づけ、これまでの10倍、100倍の効率でクリエイティブな知的生産を可能にするWeb活用メソッド、それが「KM法1.0 (Knowledge Management Method)」です。
2024年のKM法1.0 発表から2年、ブラウザの進化とGoogle AIエコシステムの台頭により、知的生産の環境は劇的に向上しました。 本マニュアルは、シェア7割を誇るGoogle Chromeブラウザと最新のGeminiサイドパネル、そしてGemini Notebookを中核に据え、情報の収集から整理、執筆までをシームレスに一元化する「2026年最新のKM法2.0 」の実践手順を体系的に解説します。
KM法2.0の原点 – おしゃべりから始まった夢想
「KM法2.0」の原点となる「KM法1.0」は、ある人と私のおしゃべりから生まれました。その方の「生成AIのポータル、ないしメタ生成AIのようなものがあればいいね」の一言に刺激され、「だれも作っていないのなら、自分で作ってしまおう」と決意したことか開発着手のきっかけです。
 カラヤマ
「生成AIのポータル、ないしメタ生成AIができたら
というのは夢想?」
 ミカミ
「もう誰かが作っているでしょうね。」
2024年4月、当時最新であったMicrosoft Edgeブラウザの「Copilotサイドバー」に着目し、「ChatGPT、Copilot、Geminiなどの生成AI(右画面)」と「NotionやOneNoteなどの情報整理ツール(左画面)」を同時に立ち上げて操作する初代「KM法」(1.0) を構築しました。 これにより、プロンプトのシステマティックな管理と、生成AIの回答の効率的な整理・保存、そしてコンテンツ制作へのスムーズな移行が実現しました。
「KM法2.0」へ – Chrome新機能とGoogle AIエコシステムの活用
初代のKM法の発表からわずか2年、生成AIを取り巻くブラウザ環境は劇的な進化を遂げました。 2026年現在、世界シェアの7割を占めるGoogle Chromeブラウザのアップデートにより、かつてEdgeでしか実現できなかった高度な生成AIポータルの構築が、より完全な形で実現可能となりました。 これが、本マニュアルが提唱する「KM法2.0」です。
KM法2.0を支えるのは、ブラウザ上部タブやサイドパネルとシームレスに連携する最新の「Geminiサイドパネル」によるAI対話、そして情報を一元的に管理する「Gemini Notebook」の登場です。 かつて必要とされた外部の万能ノートアプリを極力排除し、Googleドライブ内のデータと生成AIが直接連携する「Google AIエコシステム」へと情報を一元化することで、知的生産の効率はさらに極限まで高められます。さらに、Chrome拡張機能によって、メジャーな生成AIであるChatGPTとClaudeも、Chromeのサイドバー上で実行することが可能になりました。また、同じくChrome拡張機能を用いて、KM1.0でEdgeのサイドバーメニューと同じ形でChromeブラウザにサイドバーメニューを表示させることができるようになりました。ここに、生成AI、Google Workspaceアプリ、主要な情報ソースアプリ、SNSなどのリンクアイコンを垂直に並べれば、Chromeブラウザ上に理想に近い「生成AIポータル」を構築することができます。
知的生産の伝統と「KM法2.0」がもたらすパラダイムシフト
梅棹忠夫が示した「知的生産の三段階モデル」と情報の規格化
「知的生産」という概念は、文化人類学者である梅棹忠夫氏が1960年代に提唱したものです。 梅棹氏はこれを、「既存の、あるいは新規の、さまざまな情報をもとにして、それに、それぞれの人間の知的情報処理能力を作用させて、そこにあたらしい情報をつくりだす作業」と定義し、ひとつの創造活動であると説きました。
梅棹氏が考案した革新的な方法論は、知的生産のステップを「情報の収集」「情報の整理」「コンテンツの制作」の3つの段階に明確に区分し、これらを「規格化されたカード」によって一貫してつなぐ点にありました。
- 情報の収集(発見の手帳): 日常の経験や観察、着想をその場で書き留めるインプットのツールです。
- 情報の整理・保存(京大型カード / オープン・ファイル): 1枚1項目ルールのカードと、それらをフォルダーに仕分けするシステム。 現代のPCにおける「ファイルとフォルダー」、あるいはWebブラウザの「ブックマーク」の概念を先取りしたものでした。
- コンテンツの制作(こざね法): 紙切れに事柄を書き出し、机に並べて論理的なつながりごとに重ねて構成を構築する文章作成技術です。
現代のデジタル情報時代においても、この「収集・整理・制作」の3段階プロセスは変わりません。 PC、クラウド、そしてWebブラウザを共通プラットフォームとすることで、これらの段階はさらに高速かつシームレスに統合されます。
第1部:基本理念 ─ AI時代の知的創造パラダイム
第1章:知的創造のパラダイムシフト
1-1:AI時代の情報整理から「知識創造」へ
生成AIの黎明期、その主な役割は大量のデータから必要な情報を抽出・要約する「情報整理」の効率化でした。人間が指示を出し、AIが既存の知識を整理して返すという、いわば高度な検索の延長線上にある使い方が主流だったと言えます。
しかし現在、生成AIは単なる作業の自動化ツールを超え、人間の思考を刺激し拡張するパートナーへと進化しています。AIが提示する予期せぬアイデアや多角的な視点との対話を通じて、人間はこれまでにない新たな仮説や概念を生み出す「知識創造」の時代へとシフトしつつあります。
このパラダイムシフトの本質は、主従関係の変化にあります。AIに答えを求め、その出力に従うのではなく、AIとの「共創(コラボレーション)」によって人間の創造性を最大化し、未知の価値を共につくり出すことこそが、これからの時代における生成AIの真の活用法です。
1-2:個人知と組織知・集合知の新たな関係
従来の知的創造は、個人の孤独な営みと膨大な時間の投資を前提としていました。人間が自らテーマを設定したあと、書籍や雑誌、論文、ウェブサイトといった多種多様な情報源から時間をかけて資料を収集(インプット)し、それらを脳内で咀嚼・編集した上で、テキストや図表、動画といった形へアウトプットするプロセスが一般的でした。この手法では、個人の情報処理能力や所有する時間の限界が、そのまま創造される成果物の質や量、スピードの限界を意味していました。
しかし、生成AI時代の到来によって、このプロセスは劇的な変化を遂げています。現代の知的創造は、ウェブ上の生成AIポータル(KM法など)を駆使し、インプットからアウトプットに至る全工程を「AIとの共同作業」として進める形へと進化しました。
資料の収集フェーズでは、AIが瞬時に膨大なデータから核心を突き、多角的な視点を提示します。続く整理・編集フェーズでも、AIとの対話を重ねることで、人間の思い込み(バイアス)を排除した斬新な切り口や構造化が可能になります。最後のアウトプット制作においても、AIが下訳や構成案、ビジュアルのプロトタイプを即座に生成するため、人間はより本質的な「価値判断」や「文脈の構築」に集中できるようになりました。
この変革は、単なる作業の効率化に留まらず、「個人知」と「組織知・集合知」の新たな関係性を築きつつあります。
かつて組織知や集合知は、個人の知識を時間をかけて吸い上げ、データベース化することで初めて形成されるものでした。しかし、生成AIは人類が蓄積してきた膨大な集合知をあらかじめ学習しており、個人はAIを介してその集合知へリアルタイムにアクセスできます。
つまり、個人がAIと協働することは、世界中の集合知と対話することと同義なのです。これにより、個人のひらめき(個人知)が即座に集合知によって洗練され、またその成果が新たな組織知へと超高速で還元されるという、知の循環モデルが確立されます。生成AI時代の知的創造とは、個人の能力を拡張し、人類の知の資産を最大限に活かし合う、新たな「共創」の形と言えるでしょう。
第2章:Google エコシステム
2-1 : エコシステム(生態系)とは?
エコシステム(ecosystem)というのは、もともと生態学の分野でつくられた専門用語です。「エコロジー(Ecology)」という言葉は、ドイツの生物学者エルンスト・ヘッケル(Ernst Haeckel)によって1866年に発明(提唱)されました
。ギリシャ語で「家」や「生活の場所」を意味する「oikos(オイコス)」と、学問を意味する「logos(ロゴス)」を組み合わせて作られた造語です。本来、エコロジー(生態学)とは、生物と、それを取り巻く物理的・化学的・有機的・無機的な外部環境との相互関係を研究する科学(生物学の一分野)です。19世紀から20世紀にかけて、研究対象を広げて、「ヒューマン・エコロジー」「カルチュラル・エコロジー」などの新しい研究領域が開拓されるようになりました。
また、「エコシステム(生態系:ecosystem)」という言葉を作ったのは、イギリスの植物生態学者アーサー・タンズリー(Arthur Tansley)です。彼が1935年に発表した論文『The Use and Abuse of Vegetational Concepts and Terms(植生概念と用語の使用と誤用)』の中で、この言葉を初めて提唱しました。彼は、有機体という曖昧な言葉の代わりに、物理学の概念である「システム(体系)」を導入しました 。生物(植物・動物・微生物)の集まりだけを切り取るのではなく、それらが生きている光、空気、水、土壌といった「無機的環境」もすべて含めた全体を一つの物理的システムとして捉えるべきだと定義したのです。このタンズリーの提唱によって、生態学は単に「生き物を観察・分類する学問」から、物質の循環やエネルギーの流れを物理的・化学的に分析する「現代のシステム科学」へと進化する決定的な転換点を迎えることになりました。
1990年代以降、ビジネスやITの世界でも、「エコシステム」という用語が頻繁に使われるようになりました。ここで、「エコシステム(ビジネス・エコシステム)」とは、複数の企業、サービス、そしてユーザーが結びつき、互いに連携・共生しながら共存共栄していく仕組みを指します。
1. 自然界のエコシステムとビジネス・エコシステムの「共通点」
自然界のエコシステムも、ビジネスのエコシステムも、「個々の要素が独立しているのではなく、全体が密接に繋がり、影響を与え合いながら機能しているシステムである」という本質は全く同じです。
- 自然界の仕組み: 太陽光のエネルギーを植物(生産者)が取り込み、それを動物(消費者)が食べ、死骸や排泄物を微生物(分解者)が分解して土に還すという、完璧な物質循環とエネルギーの流れが成り立っています。
- ビジネス界の仕組み: 1社だけで完結させるのではなく、多くの外部プレイヤーやパートナー、ユーザーを巻き込むことで、市場全体を拡大させ、簡単には崩れない強力な価値や利便性を生み出します。
2. Appleを例にした「ビジネス・エコシステム」の具体像
現代において最も成功しているエコシステムの一つがAppleの経済圏です。
- iPhone(端末)
- iOS(オペレーティングシステム・インフラ)
- App Store(プラットフォーム)
- アプリ開発者(外部のサービス提供者・いわば「生産者」)
- 一般ユーザー(サービスやハードの「消費者」)
これらは個別に存在しているのではなく、一体となって互いに利益をもたらし合う巨大な経済圏を形成しています。開発者が魅力的なアプリを作ることでユーザーにとってのiPhoneの価値が上がり、ユーザーが増えることでさらに開発者が集まるという、「絶妙な循環(共生関係)」が成立しているのです。
2-2 : Googleエコシステム
Googleエコシステムとは、Googleが提供する検索、Gmail、Googleドライブ、Googleカレンダー、Googleドキュメント、Google Meet、Android、Geminiなどのサービスが相互に連携し、一つのアカウントでシームレスに利用できる統合環境を指します。データや設定がサービス間で共有されるため、情報管理や共同作業、生産性向上が容易になり、個人・教育・企業で効率的なデジタル活用を実現する仕組みです。近年は、従来の「Googleエコシステム(検索、Gmail、マップなど)」のすべてにAI (Gemini)が組み込まれ、従来の「クラウド+アプリ」のエコシステムから、「AIを中⼼に知識を活⽤するエコシステム」へと⼤きく進化しています。
Googleエコシステムの全体像は、下のインフォグラフィックに示す通りです。
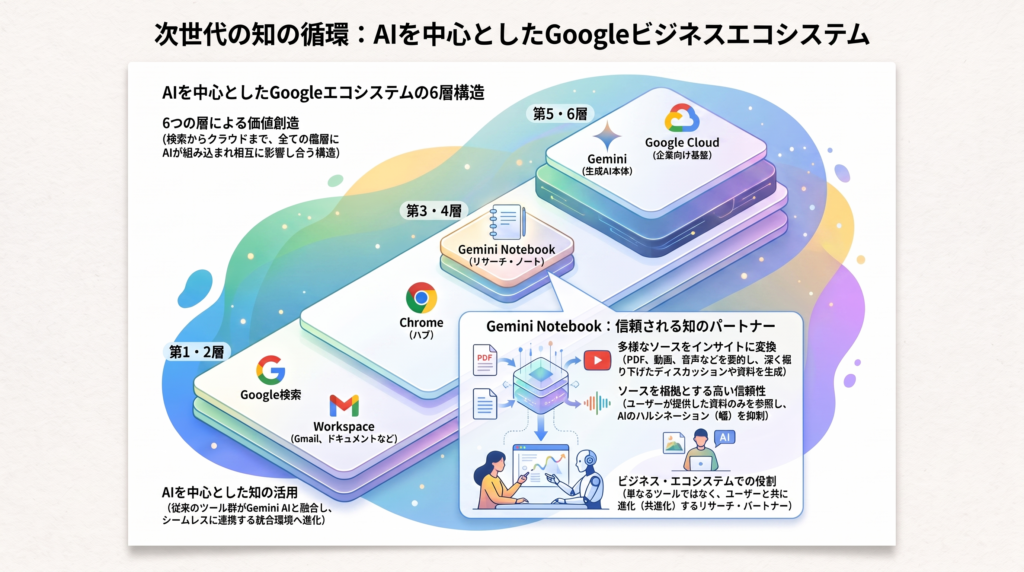
第1層:Google検索
Googleサービスの原点にあるもので、Google検索により世界中の情報を探索することができます。
・Google検索
・Google Scholar
・Google News
・Google Books
など。
第2層:Google Workspace
Google Workspaceは、GmailやDrive、Docs、Calendar、Meetなどが統合されたクラウド型生産性ツール群です。1つのアカウントで文書作成、データ管理、Web会議などがシームレスに連携します。さらにGemini AIとの融合により、メール執筆やデータ分析、議事録の自動作成なども可能になり、個人のタスクから企業の業務効率化までを強力に支えるエコシステムの中核です。主なサービスは次のとおりです。
・Gmail:メール
・Googleドライブ:クラウド
・Googleドキュメンツ:文書作成
・Google Sheets:表計算
・Googleスライド:プレゼン資料作成
・Googleカレンダー:カレンダー作成
・Googleミート:オンライン会議
・Googleキープ:メモ帳
第3層:Chrome
Chromeは単なるブラウザではありません。現在は
・Gemini
・Google Drive
・Workspace
・NotebookLM
を結ぶハブ(あるいはポータル)になっているのです。
第4層:NotebookLM
Google NotebookLMは、Googleが提供するAI搭載のリサーチ・ノートツールです。PDF、Googleドキュメント、Webページなどを資料として読み込ませると、その内容に基づいて要約、質問応答、比較分析してくれたり、音声解説、スライド作成、動画解説、インフォグラフィックなどを自動で作成してくれます。NotebookLMによる生成結果はソースとして登録した資料のみを根拠とするため、ハルシネーションを防ぐことができ、調査や学習、文書作成を効率化できます。
第5層:Gemini(生成AI)
Googleエコシステムで中心的な役割を担っており、ほとんどすべての層にGeminiが組み込まれるようになっています。Geminiは、対話型AI、コーディング、」⽂書作成、調査、画像⽣成、動画生成、⾳声会話まで、多様なAIサービスを⾏います。
第6層:Google Cloud
Google Cloudは、企業向けのエコシステムです。主なサービスVertex AI 、BigQuery、 Cloud Storage、 Cloud SQL 、Cloud Run、 Kubernetes Engineなどです。企業では、Geminiを組み 込んだAIシステムをここで動かします。
KM法2.0における知的創造の柱は、Gemini & Notebook AI / Googleドライブ / Chromeブラウザ / Google Workspaceの4つです。KM法2.0の目的は、ウェブ上に生成AIポータルを設置することにより、「情報の探索・収集(Input)」「情報の蓄積・整理(Stock)」「情報の思考・創造(Output)」の3つのプロセスをシームレスに循環させ、個人の知的生産性と創造力を飛躍的に高めることにあります。
従来のナレッジマネジメント(KM 1.0)が「組織内での情報共有やデータ保管」に主眼を置いていたのに対し、2.0では「AIを知的パートナーとする、ユーザー主導の効率的な知の創造」へと進化しています。
2-3 : Gemini Notebookのフル活用
生成AIはKM法2.0の知的パートナーです。これまで人間が時間をかけて行っていた
- 文献の要約
- 情報の比較・分析
- アイデア創出
- 文章作成
- 仮説の検証
を高速に支援してくれます。 特にGemini Notebookは、Googleドライブ内の資料だけを根拠として回答するため、一般的な生成AIよりも信頼性の高い対話型研究支援ツールとして機能します。
Geminiとは
Gemini(ジェミニ)は、Googleが開発した最新のマルチモーダルAIであり、あなたをサポートするAIアシスタントです。Geminiには、2つの大きな特徴(強み)があります。
- マルチモーダル
Geminiの一番の強みは、テキスト(文章)だけでなく、画像、音声、動画、プログラミングコードなど、多様な種類の情報を同時に処理・理解できる点です。
- Googleサービスとの強力な連携
Google生まれのAIなので、私たちが普段使っているサービスとシームレス繋がるのが得意です。Googleエコシステムならではの特徴ですね。
Google Workspace: Gmailのメール作成、Googleドキュメントでの文章作成、Googleドライブのファイル整理などをアシストします。
2-4:Googleドライブを中心とした知識管理システムの構築
Googleドライブは、Googleエコシステムにおける「デジタル情報のインプットとストレージ」の中心として、極めて重要な役割を果たしています。単なるファイルを保存するインプット拠点(クラウドストレージ)にとどまらず、あらゆるアプリや機能をつなぐ強力なハブ、さらにはアウトプット(知的創造)のベースとしても機能しています。
第2部:生成AIポータルの構築
現代の生成AIは、ウェブ上の無数のウェブサイトを絶えず巡回して、ウェブ上の膨大な情報を日々収集して、ユーザーのリクエストに答えています。また、生成AIアプリを始め、個人やビジネスユーザーが日常的に使う各種アプリの多くはブラウザ上で動くようになっています。
このことを利用して、ChromeブラウザをGoogleエコシステムと生成AIへの入り口(ポータル)となるように改造する方法を解説します。これは、狭い意味でのKM法2.0ということができます。改造するツールは、ブックマークメニュー、Chromeサイドバー、Chromeサイドパネル、Googleドライブの3つです。
第3章:Cromeブラウザにおけるブックマークの整理
3-1 : ブックマークとは何か?
Google Chromeにおけるブックマーク(Bookmark)とは、お気に入りのウェブサイトのURL(ウェブアドレス)を保存して、いつでも簡単に再訪問できるようにする機能のことです。ブックマークには、次のようなメリットがあります。
・ワンクリックでWebサイトにアクセス: よく使うサイトを「ブックマークバー」に表示させておけば、ブラウザを開いてすぐにそのページに飛べます。
・フォルダで綺麗に整理: 「仕事」「趣味」「料理のレシピ」のようにフォルダを作って、増えたブックマークをカテゴリごとに分類できます。
・スマホや別PCとの同期: GoogleアカウントでChromeにログインしていれば、パソコンで保存したブックマークを、スマホやタブレットのChromeからでもそのまま確認・利用できます。
保存したいウェブページを開いた状態で、アドレスバー(URLが表示されているところ)の右端にある星マーク(☆)をクリックします。星が青(または共通のテーマ色)に変われば登録完了です。
3-2 : ブックマークの階層化とアイコン化
Chromeブラウザ上でブックマークをおく場所は、ブラウザの検索バー(アドレスバー)のすぐ下にある、お気に入りのサイトを横一列に並べて表示できる帯状のエリアで、「ブックマークバー」と呼ばれています。
ブックマークの「階層整理(フォルダの中に、さらにフォルダを作ること)」は、大量のサイトをすっきりまとめるのに最も効果的な方法です。ブックマークを階層的に整理するには、「ブックマークマネージャー」を使うのが最も手軽です。
階層化の方法は、基本的にクラウドなどと同じであり、3階層、4階層(フォルダの中のフォルダの中のフォルダ…)と深くしすぎると、目的のサイトに辿り着くまでに何度もクリックしなければならず、逆に面倒になります。一般的には、3階層以内に留めるのが適切だと言われます。それ以上だと、目的のファイルが探しづらくなるからです。
ブックマークは、日常的によく使うWebサイトへのアクセスを容易にするためのツールであり、それだけのこと。生成AIポータルとして、AIと連携するといった機能はありません。ですから、ブックマークバーでの表示は最小限に抑えるのが賢い方法です。その代わり、横長の広いスペースを活かすために、フォルダではなく、よくアクセスするWebサイトの「サイトアイコン」を並べるのがおすすめです。その方法は次の通りです。
- ブックマークバーを表示する
- もしバーが見当たらない場合は、キーボードの
Ctrl+Shift+B(MacはCmd+Shift+B)を押して表示させてください。
- もしバーが見当たらない場合は、キーボードの
- 編集画面を開く
- アイコンだけにしたいブックマークを右クリック(Macのトラックパッドなら2本指タップ)します。
- 表示されたメニューの中から 「編集」 をクリックします。
- 名前を削除する
- 「名前」の入力欄に表示されているテキスト(サイト名など)を、バックスペースキーなどですべて消して空欄にします。
- ※「URL」の欄は絶対に触らないように注意してください。
- 保存する
- 右下の 「保存」 ボタンをクリックします。
アイコンの横に短いタイトルをつけておくと、分かりやすいと思います。(下の画像を参照)いずれかのアイコンをタップすると、目的のWebサイトやウェブサービスを直接呼び出すことができます。ポータルにふさわしい配置と言えるでしょう。
3-3 : ブックマークにおけるフォルダとアイコンの配置
生成AIの普及した現代においては、ウェブ上の情報検索は、ブラウザでブックマークしておいた特定のページにアクセスするよりも、Googleの検索エンジンで検索したり、生成AIで情報検索するという形で行う方が圧倒的に多くなっています。したがって、ブラウザ上のブックマークに登録するWebページの数は、従来よりも大幅に減少しているはずです。
ブラウザのブックマークバーは、横長の広い領域なので、最もよくアクセスするウェブページのアイコンを並べます。私の場合は、左から、Google Workspaceの管理ページ、メール、Googleドライブの「マイドライブ」ページ、「KM法2.0」Webサイト、GoogleドキュメントのWebページ、GoogleキープのWebページ、生成AIのWebページ(Gemini、Gemini Notebook、ChatGPT、Claude)のアイコンとタイトル文字を並べています。いずれの場合にも、アイコンをタップすると、ブラウザの全画面に該当するWebページが表示されます。
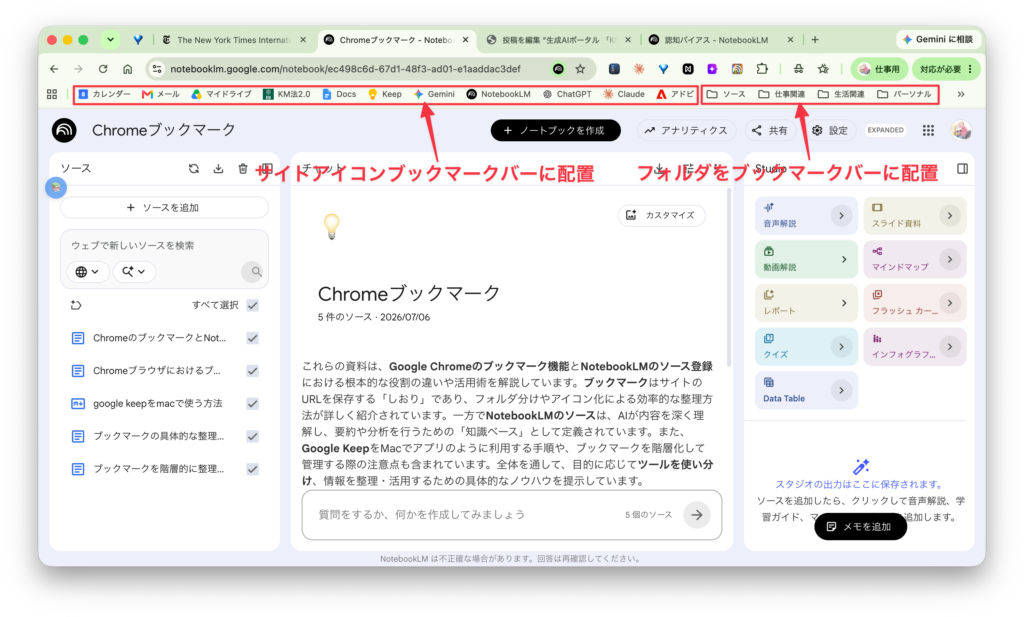
ブックマークバーにフォルダを作って、そこに保存しておくべきWEBページというのは、生成AI時代においては、「ソース」「仕事(学校)」「生活」「パーソナル」の4つのフォルダに絞り込んでおくのがベストだと思います。「ソース」というのは、NotebookLMのソースとしてインプットすべき情報源のことです。例えば、オンラインの新聞、雑誌、オンライン動画、SNS、オンラインのデータベース、オンラインの電子書籍サイトなどです。「仕事」とは、勤務先や仕事や学業に関連して、頻繁にアクセスするサイトです。「生活」とは、消費生活、金融取引、不動産、健康・医療、スポーツなど、日常生活に関連するWebサイトのブックマークからなっています。最後に、「パーソナル」は、本人、家族、友人関係のサイトです。
これまで、さまざまなWebサイトをブックマーキングしてきたと思いますが、そのかなりの部分は、後述するNotebookLMのソースに登録しておく方が、生成AIでの活用に繋げられるので、生成AIのインプットサイトに移行した方が効率的です。これまでのブックマークバーによる管理は、今のところ生成AIとの連携機能がないので、利用価値はあまり高いとは言えないのです。
第4章:Chromeサイドバーの設定
4-1 : 「Geminiに相談」ボタンで開く
最新のChromeブラウザを開くと、ツールバー(画面右上)に「Geminiに相談」ボタンが追加されているのがわかります。これは、2026年5月にリリースされた、ブラウザとAIが完全に一体化した非常に便利な新機能です。
このボタンをクリックすると ❶、サイドバーが一発で開き、GoogleのAI「Gemini」とのチャット画面が立ち上がります ❷。
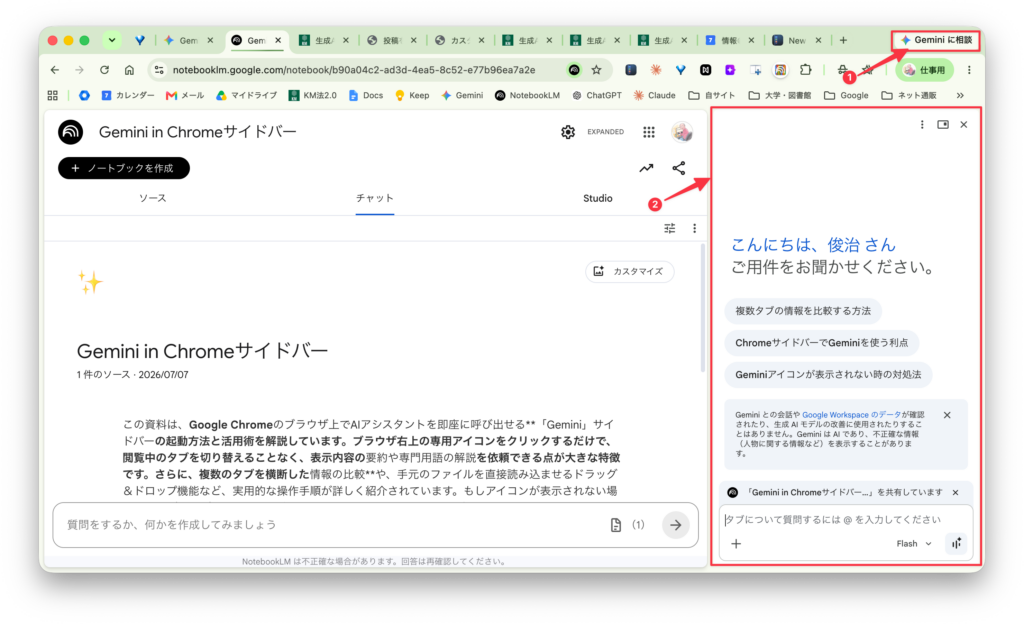
このGeminiサイドバーの最大の特徴は、「今見ている(左側の)ウェブページの内容を、Geminiがその場で理解してくれる」という点です。通常のGeminiのサイトを開いて、WEBページのURLをコピー&ペーストする、といった面倒な手間が一切なくなりました。
具体的には以下のような使い方ができます。
- ページを一瞬で要約: 長いニュース記事や、英語の論文、難しい専門サイトを開いた状態で「この記事を日本語で3行で要約して」と頼むと、横のサイドバーでサクッとまとめてくれます。
- 動画の要約: YouTubeなどの動画ページを開きながら「この動画の重要なポイントを教えて」と質問できます。
- 複数タブの比較: 複数の旅行プランや商品のページを開いている状態で、「開いているタブの情報を比較して表にして」といった頼み方も可能です(チャット欄に「@」と入力してタブを指定できます)。
4-2:Chrome拡張機能 SidelyでChatGPTをサイドバーで開く
KM法1.0では、マイクロソフトのEdgeブラウザで、Copilotのサイドバーを開くことができましたが、GeminiやChatGPTなど他の生成AIをサイドバーで開くには、サイドメニューバーにそれぞれの生成AIのアイコンを登録しておく必要がありました。KM法2.0では、「Chrome拡張機能」を使って、他の生成AIの機能をサイドバーの画面で実行することができます。
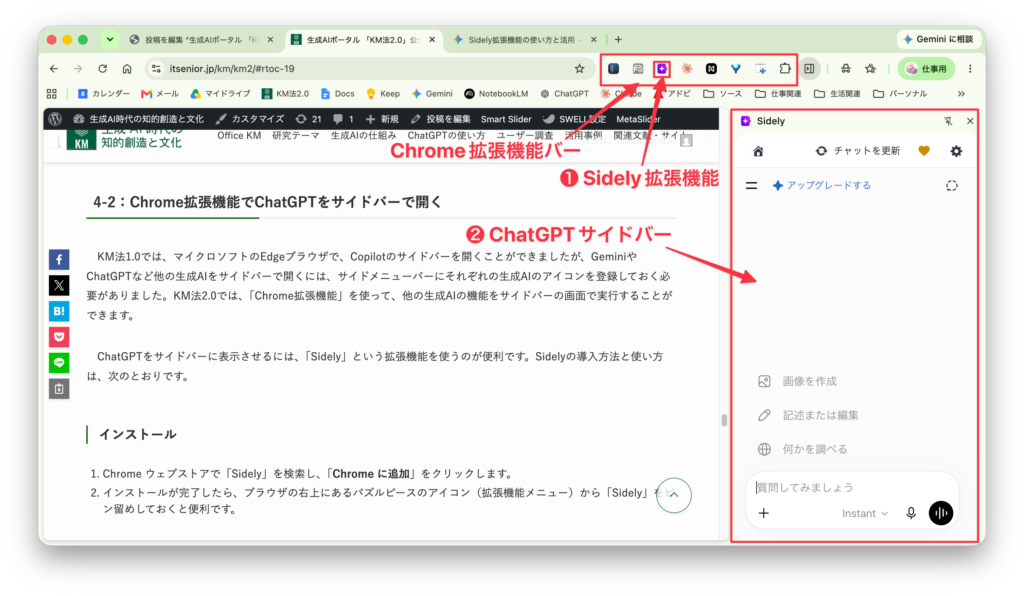
ChatGPTをサイドバーに表示させるには、「Sidely」という拡張機能を使うのが便利です。Sidelyの導入方法と使い方は、次のとおりです。
1. インストール
- Chrome ウェブストアで「Sidely」を検索し、「Chrome に追加」をクリックします。
- インストールが完了したら、ブラウザの右上にあるパズルピースのアイコン(拡張機能メニュー)から「Sidely」をピン留めしておくと便利です。
2. サイドバーを開く
- ブラウザ右上の拡張機能バーにある Sidelyのアイコン ❶ をクリック するか、設定されたショートカットキーを押すと、画面の右側にAIチャットの画面(サイドバー)❷ がスッと現れます。
3. いつものアカウントでチャット
- あなたが普段使っているChatGPT(OpenAI)のアカウントでそのまま動作するため、安全かつ高速にメッセージのやり取りが可能です。
Sidelyの本領は、「何かを読みながら・見ながら」 使うところにあります。
- ウェブサイトの要約・翻訳 海外のニュース記事や、長文のブログを読んでいるときに、サイドバーに「このページの内容を3行で要約して」「この部分を日本語に訳して」と指示するだけで、画面を切り替えずに中身を理解できます。
- 調べ物をしながらの作業 Google検索で出てきたページを読みつつ、「ここにある〇〇という技術について、もっと噛み砕いて教えて」といった深掘りの質問がその場で可能です。
- 文章作成のサポート Gmailでメールを返信するときや、SNSの発信を考えるときに、横で「ビジネス向けの丁寧な言い回しに変えて」とAIに壁打ち相手になってもらうことができます。
4-3 : Chrome拡張機能でClaudeをサイドバーで開く
Claude in Chromeは、Chrome拡張機能を使って、ChromeのサイドバーからClaudeの生成AIサービスを使える仕組みです。いま開いているページの読み取り、複数タブの比較、フォームへの入力などを、サイドバーだけでClaudeに直接実行させることができる非常に強力なツールです。
1. 初期設定(インストールとログイン)
- 拡張機能のインストール
Chromeウェブストアから「Claude in Chrome」を検索し、拡張機能を追加します。 - ピン留めする
ブラウザ右上のパズルピースのアイコン(拡張機能メニュー)をクリックし、Claudeの横にあるピンのアイコンをクリックして、ツールバーに常駐させます。 - ログイン
アイコンをクリックしてサイドパネルを開き、お使いのAnthropicアカウントでログインします(※自動操作などの高度な機能は、主にPro以上のプランで真価を発揮します)。
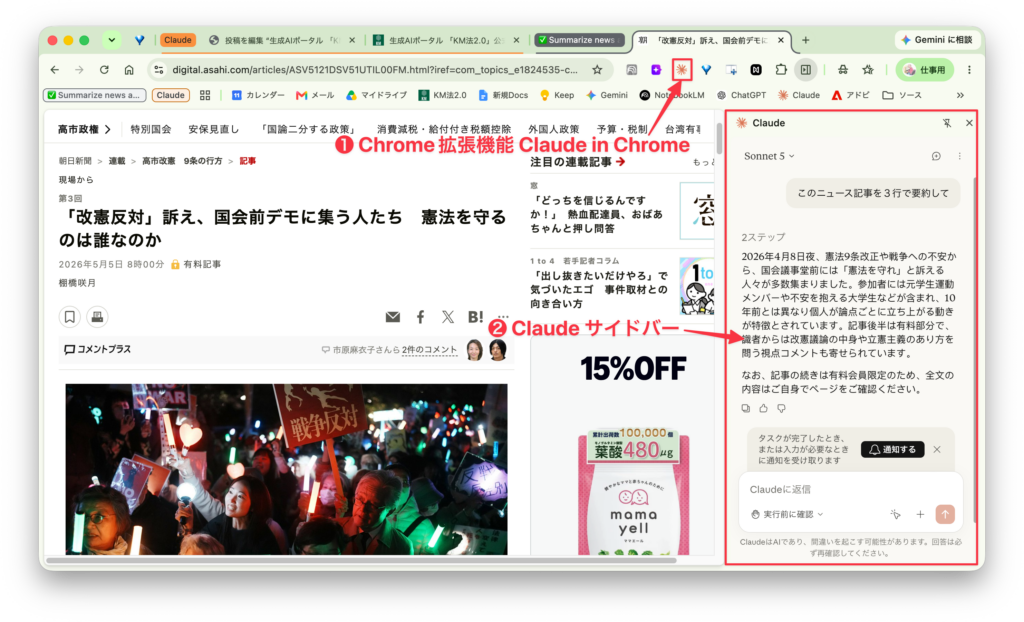
2. 基本的な使い方
大きく分けて3つの使い方があります。
(1) 閲覧中のページについて指示を出す
今開いているWebページを見ながら、サイドパネルのClaudeにチャットで指示を出します。
- 指示の例: 「このニュース記事を3行で要約して」
- 「この仕様書ページから、重要な制限事項だけをリストアップして」
(2) ブラウザの自動操作を任せる
Claudeに「調べる・比較する・入力する」といった複数ステップの作業を自律的に行わせることができます。
- 指示の例: 「このタブと隣のタブの料金プランを比較して、違いを表にまとめて」
- 「画面に表示されている商品一覧から、価格とレビュー評価を抽出してCSV形式で出力して」
- 「この長尺の問い合わせフォームに、以下の会社情報を自動で入力して」
(3) ショートカットとスケジュール実行(「/」コマンド)
チャット入力欄に /(スラッシュ) を入力すると、便利なメニューが呼び出せます。
- 定型タスクの保存: よく使うプロンプトや操作手順をショートカットとして登録し、次回から1発で呼び出せます。
- スケジュール実行: 「毎日〇時にこのサイトの情報をチェックする」といった定期的なタスクを設定できます
第5章:Googleドライブのフォルダ設計
生成AIが急速に進化したいま、Googleドライブを単なるファイルの「保管庫」(ストレージ)として眠らせておくのは非常にもったいない時代になりました。Googleドライブのデータ保管方法を根底から見直し、GeminiなどのAIと連携させることで、「使えば使うほど自分専用に育っていく知的資産(知識のハブ、または知識ベース)」へと進化させることができます。
Googleドライブを知識創造のベースに変えるには、主に3つの方法があります。それぞれの特徴と具体的な活用方法を詳しく解説します。
方法1: Googleドライブのフォルダー階層を生成AIと最適に連携できる構成とする
GeminiとGoogle Workspace(ドライブやドキュメントなど)を連携させて最適な結果を得るためのフォルダ階層について、結論からお伝えすると、「人間にとってもGeminiにとっても、テーマやプロジェクトごとに明確に分かれたシンプルな階層」がベストです。
Geminiは高度なセマンティック検索(意味や文脈を理解した検索)を行うため、複雑なフォルダ階層に頼る必要はありませんが、情報が整理されているほど誤認識(ハルシネーション)を防ぎ、より正確な回答を引き出すことができます。また、ユーザー側でも、Gemini Notebookのソースの特定やアウトプットの保存場所を簡単に見つけることができます。
1. 連携を最適化するための3つの設計指針
- 「1テーマ=1フォルダ」を徹底するGeminiに「〇〇のプロジェクトについて要約して」と指示する際、関係のない書類が同じフォルダに混ざっていると、それらも巻き込んで集計・要約してしまう可能性があります。プロジェクト、クライアント、目的ごとにトップレベルのフォルダを分けましょう。
- 階層は深くしすぎない(3階層までが理想)人間が迷子になるような深い階層(フォルダの中にフォルダ、さらにその中にフォルダ…)は、Geminiにとっても情報の重要度や文脈が薄れる原因になります。できるだけフラット(浅く広く)な構成を意識します。
- ファイル名にコンテキスト(文脈)を入れるGeminiはフォルダ名だけでなく、ファイル名やファイル内のテキストも強く参照します。フォルダ階層を綺麗にするのと同時に、ファイル名に「日付_プロジェクト名_内容」のような規則性を持たせると、検索精度が劇的に向上します。また、プロンプトを使って生成AIに質問や指示をしたケースでは、生成AIの回答結果を保存するとき、プロンプトの要約文をファイル名にしておくと、後々参照する時に見つけやすいというメリットがあります。
2. おすすめのフォルダ階層モデル(例)
以下は、私自身のGoogleドライブをもとに作ったサンプルのフォルダ構成です。
マイドライブ(My Drive)
│
├── 00_インボックス(一時保管・未整理)
│     └── ※Googleドライブの01以下のフォルダに保管する前の、とりあえず置いたメモや素材など
├── 01_パーソナル(個人的な情報を入れる)
│     ├── 家族
│     │     ├── 01_個人情報
│     │     ├── 02_資産関係
│     │     └── 03_健康・医療
│     └── 履歴書類
├── 02_Google(Googleのアプリ)
│     ├── Google Workspace
│     ├── Googleドライブ
│     ├── G-mail
│     ├── Googleマップ
│     └── Gemini
├── 03_メディア研究
│     ├── メディア効果論
│     ├── 世論研究
│     ├── ネット社会論
│     └── 内容分析
├── 04_生成AI
│     ├── 生成AIの研究
│     ├── KM法(生成AIポータル)
│     ├── ChatGPT
│     ├── Gemini│
│     └── Claude
├── 05_クイズ
│     ├── クイズいろいろ(ホームページ)
│     ├── 人物クイズ
│     ├── 歴史クイズ
│     ├── 語学クイズ
│     └── 世界遺産クイズ
├── 06_語学
│     ├── 英語
│     ├── フランス語
│     ├── イタリア語
│     ├── ドイツ語
│     └── 韓国語
└── 07_アーカイブ(終了した案件・過去のデータ)
      └── 2026年終了プロジェクト
3. 他のクラウドからGoogleドライブへのフォルダーコピー
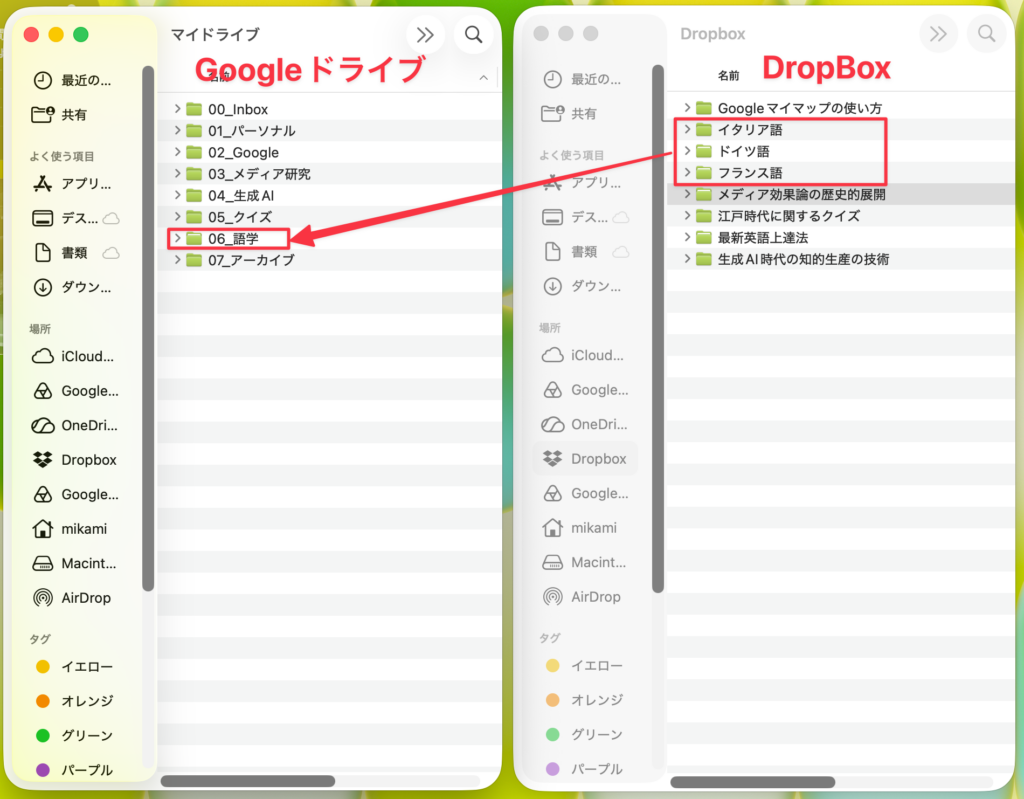
DropBox、Onedrive、iCloudなどのクラウドをふだん使っている方が、生成AIとの連携のためGoogleドライブを利用するには、新たにGoogleドライブのソフトをデスクトップにインストールした上で、デスクトップのアプリを立ち上げ、Finder(Mac)やエクスプローラ (Windows)上で、通常のファイルコピーと同じやり方で、クラウド間のフォルダーやファイルのコピーが簡単にできます。
その場合、まず最初に、Googleドライブの「マイドライブ」に、上に述べたような生成AIに最適化した階層フォルダを作っておき、DropBoxなど他のクラウドから、該当するフォルダーやファイルをGoogleドライブにコピーするという方法をとるのがおすすめです。具体的には、下の画像の通りです。これは、あくまでも簡易化したサンプルによる一例を示したものです。
方法2:Googleドライブの「プロジェクト」機能を使う
「日常業務のサポート、カレンダーやメールを含めた身軽な情報収集・相談」に最適
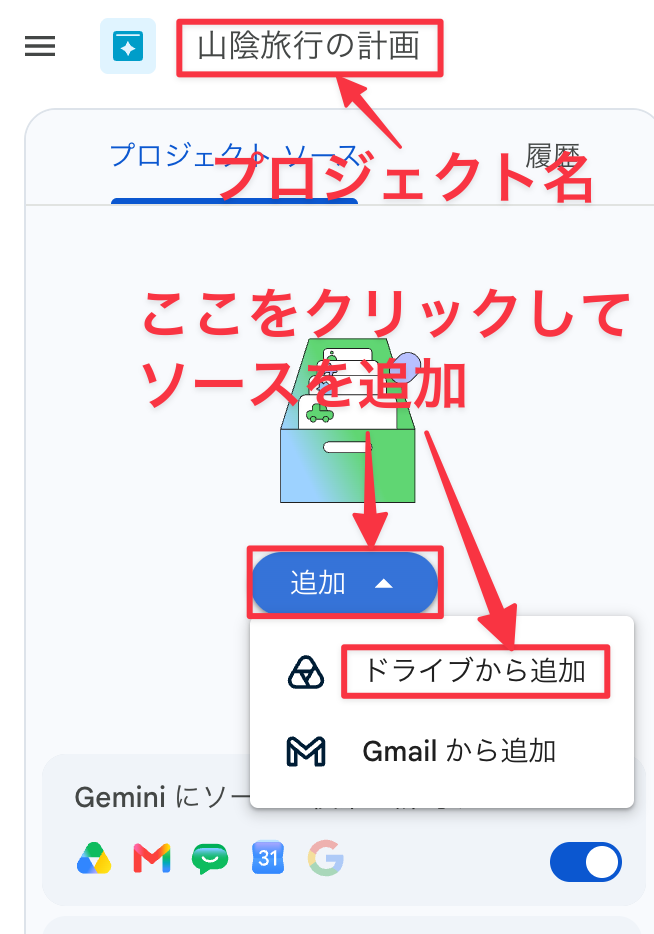
Googleドライブの「プロジェクト」は、関連するファイルやフォルダーを1つのセットにまとめ、そのデータ全体を前提としてGeminiに質問ができる機能です。
- 仕組みと特徴
- カレンダーやGmail、チャットとの超連携: 設定で「ソースの検索を許可」にチェックを入れておくと、ドライブ内のファイルだけでなく、自分のGmail、Google カレンダー、Google チャットの情報まで横断的にGeminiが読み込んで回答してくれます。
- 個人に最適化された回答: ドライブ内の共通ファイルを参照しつつ、個人のカレンダーやメールなどのプライベートな履歴を掛け合わせて回答を生成するため、ユーザーに深く寄り添ったサポートが可能です。
- AIによる関連資料の提案(候補リスト): プロジェクトを作成すると、AIがドライブ内を自動で検索し、「このファイルもプロジェクトに関連していませんか?」と追加を提案(候補リスト)してくれます。
- プロジェクトの作成

方法3:Gemini Notebookと自動同期・連携させる
2026年5月のアップデートにより、Gemini NotebookがGoogleドライブ(Google ドキュメント、スプレッドシート、スライド)との自動同期機能に標準対応しました。以前のように手動で毎回更新ボタンを押す必要がなくなり、ドライブ側のファイルを変更するだけで自動的にNotebookLM内のソースも最新の状態にアップデートされます。
1. 自動同期を開始する手順
特別なシステム設定やオプションの有効化は一切不要です。
- Gemini Notebookを開き、ノートブックを作成または選択します。
- ソースの追加画面で「Google ドライブ」を選択します。
- 同期させたいファイル(Google ドキュメント、スプレッドシート、プレゼンテーション)を選択してインポートします。
これだけで連携は完了です。以降、元のファイルに変更を加えると、数分おきに自動でバックグラウンド同期が行われ、Gemini Notebookが参照する情報も自動的にアップデートされます。
2. 自動同期の主な特徴とルール
- バックグラウンド自動更新Google ドライブ側のファイルを編集すると、Gemini Notebookが変更を自動検知して数分ごとに内容を最新化します。
- 権限と削除の厳格な連動
- ドライブ上でファイルを削除すると、Gemini Notebookのソースからも自動的に削除されます。
- ファイルのアクセス権限が変更(例:閲覧権限が取り消されるなど)された場合、Gemini Notebook側でもそのファイルにアクセスできなくなります。
- 管理者・ユーザー設定は不要この機能は標準機能として全ユーザーに自動適用されているため、オン/オフを切り替える設定項目はありません。
3. 今すぐ最新状態にしたい場合(手動での即時同期)
数分間の自動同期ラグを待たずに、今すぐ変更を反映させたい場合は、手動で強制的に同期することも可能です。
手動同期の手順:
- NotebookLMの画面左側にある「ソース」一覧から、該当のファイルをクリックして開きます。
- 画面に表示される 「クリックして Google ドライブと同期(Click to sync with Google Drive)」 をクリックします。これで即座に最新の内容に書き換わります。
⚠️ 注意点
- 自動同期の対象外となるファイルフォーマットGoogle ドライブ内に保存されている「PDF」や、ソースとしてインポートした「WebサイトのURL」などは、ネイティブの自動同期の対象外となる場合があります。これらを更新した際は、ソース画面から手動で再同期、または一度削除して再インポートを行ってください。
- コメントや脚注の扱いGoogle ドキュメント内の本文は同期されますが、ドキュメントに直接書き込まれた「コメント」や「脚注」は同期(インポート)の対象外となるケースが多いため、AIに読み込ませたい重要な情報は本文内に記載するようにしてください。
第3部:主な生成AIの利用
ここからは、KM法2.0で採用する代表的な生成AIとして、Gemini、ChatGPT、Claudeの3つを取り上げ、生成AIポータルとしてどう活用するかを中心に、基本的な解説を加えたいと思います。
Chromeブラウザでは、上部ブックマークバーとChrome拡張機能メニュー、右上の「Geminiに相談」ボタンの3箇所からアクセスできるように設計しています。ブックマークバーのボタンをクリックすると、ブラウザのメイン画面上にそれぞれの生成AIトップ画面が表示されます。拡張機能メニューと「Geminiに相談」ボタンをクリックすると、画面右の「サイドバー」が開いて、ブラウザで開いている他のページと連携しながら利用できるようになっています。詳しい使い分けの方法は以下で説明します。
第6章:生成AIの利用:Gemini編
Gemini(ジェミニ)は、Googleが開発した最先端のマルチモーダル生成AIです。従来の「テキストを打ち込んで回答を得るチャットボット」の枠を超え、テキスト・音声・画像・動画・プログラムコードをシームレスに理解・処理できる点が最大の特徴です。他の生成AIよりも優れた点としては、次のような特徴があります。
6-1 : ネイティブな「マルチモーダル設計」
Geminiは、最初から「文字」「音」「画像」「動画」を同時に扱えるように開発されています。
- テキスト: 高度な文章作成、要約、多言語翻訳、プログラミング
- 画像・カメラ: 写真に写っているものが何かを認識したり、グラフからデータを読み取って分析する
- 動画の理解: 動画ファイルを読み込ませ、その中で「何が起きているか」を把握して要約・質問に答える
6-2 : Googleサービスとの強力な連携(拡張機能)
GmailやGoogleドライブ、Googleマップ、YouTubeなど、ユーザーが普段よく使うGoogleの各種サービスと連携できます。
- 「Googleドライブにある資料を要約して」
- 「Gmailに届いているホテルの予約メールから旅程をまとめて」このようなパーソナルな指示にスムーズに対応します。
6-3 : Geminiが役立つ場面
・ビジネス・仕事: メールの作成、会議の議事録要約、アイデア出し、プログラミングコードの生成やデバッグ。
・クリエイティブ: 画像生成や動画の作成・編集(Gemini Omniなどを活用)、ストーリーやキャッチコピーの考案。
・学習・自己啓発: 難しい論文やレポートの解説、語学学習の壁打ち相手、試験対策。
・日常生活: 旅行の計画立案、冷蔵庫の写真からレシピの提案、電子機器のトラブルシューティング。
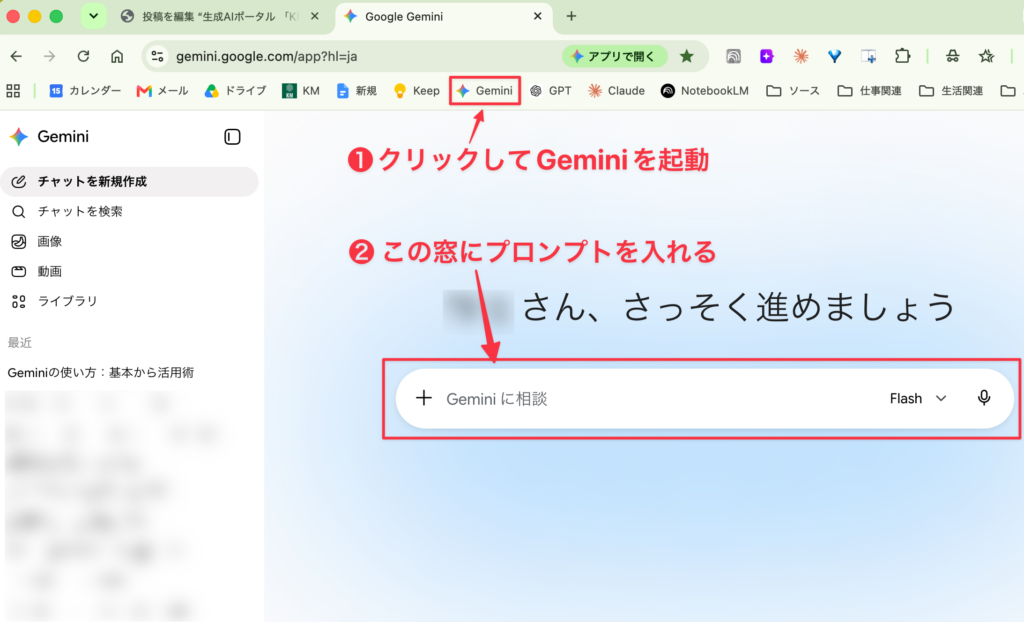
6-4 : Chromeブラウザのメイン画面でのGeminiの起動
Chromeブラウザの上部ブックマークバーに置いたGeminiのサイトアイコンをクリックすると、メイン画面にGeminiのトップページが表示されます。その「Geminiに相談」の窓にプロンプトを入れれば、生成AIのFeminiを利用することができます。
6-5 : ChromeブラウザのサイドバーでのGeminiの利用
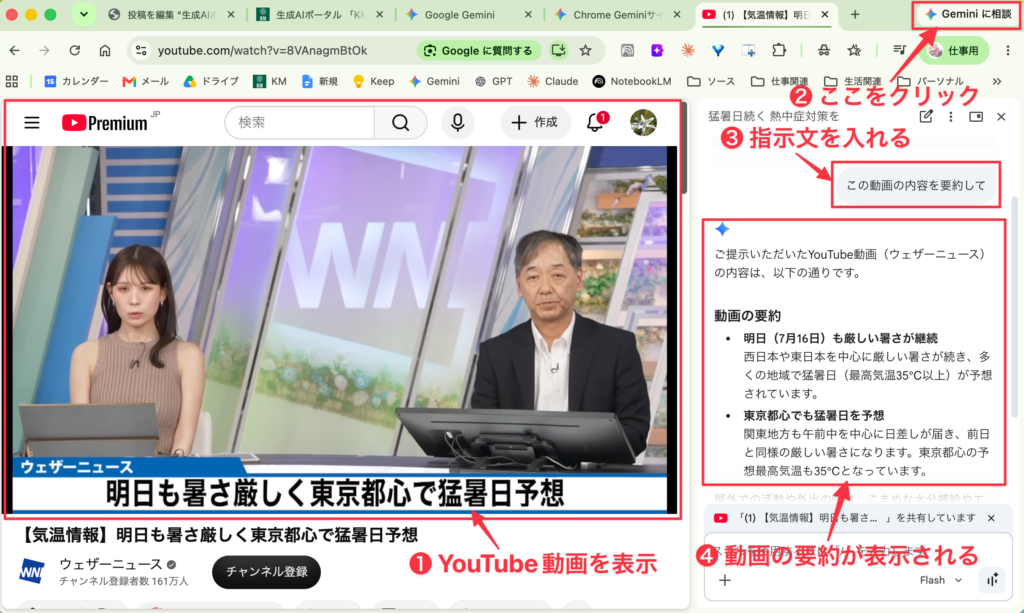
ChromeブラウザからGeminiを起動するもう一つの方法は、ブラウザの右上隅にある「 Geminiに相談」というボタン(アイコン)をクリックすることです。この場合、起動するGeminiは、メインの画面ではなく、右サイドバーに表示されます。これによって、いま開いているWebページの内容について、要約をしてもらったり、解説してもらうことができるようになります。具体的な手順は次のとおりです。
- 調べたいWebページ(ニュース記事、ブログ、論文、技術ドキュメント、YouTube動画など)をメイン画面で開きます ❶。
- ブラウザの右上隅にある「
 Geminiに相談」というボタン(アイコン)をクリックして、サイドバーを開きます ❷。
- サイドバーに表示されたGeminiの入力窓に、Webページについての質問事項を記入します 。
(例)
「この記事の重要なポイントを3つに要約して」
「この専門用語を初心者向けに分かりやすく解説して」
「YouTube動画の内容をまとめて ❸」
すると、サイドバーにGeminiの回答が表示されます ❹(下の画像を参照)。このように、通常のメイン画面でのGeminiとは違って、サイドバーでの指示によって、いま開いているWebページにターゲットを絞って、要約や解説などを作ってもらえるので便利です。
第7章:生成AIの利用:ChatGPT編
ChatGPTは、OpenAIが開発し、2022年11月に公開した対話型の生成AI(Generative AI)です。人間と自然な会話をしながら、文章作成、情報整理、アイデア発想、プログラミング、画像生成、データ分析など、多様な知的作業を支援します。単なる対話だけでなく、「高度な推論(考える力)」、「プログラミングコードの生成」、「画像の認識・生成」、「音声による自然なリアルタイム会話」などが可能です。
7-1 : ChatGPTの特徴
ChatGPTは次のような特徴を持っています。
- 「思考(Reasoning)モデル」の先駆者 :回答を急がず、内部でじっくり「考えてから出力する」高度な推論モデル(o1やo3など)をいち早く導入しました。これにより、複雑な数学、科学の論証、複雑なプログラミングのデバッグなどで極めて高い正答率を誇ります。
2. 長期的な記憶(メモリ機能)とパーソナライズ :「私の職業はエンジニアです」「簡潔なトーンで回答してください」といった、ユーザーのプロフィールや好みをAIが自動で記憶します。使えば使うほど、自分専用の優秀なアシスタントに育っていきます。
3. 「GPTs」によるカスタマイズ性とサードパーティ連携 :特定の用途(例:スライド作成、英語学習、データ分析など)に特化したカスタムAIをノーコードで自作したり、他人が作った便利なカスタムAI(GPTs)を使ったりできる巨大なエコシステムを持っています。
7-2 : ChatGPTの使い方
使い方は非常にシンプルです。LINEやメッセージアプリのように、テキストボックスに指示(プロンプト)を入力して送信するだけです。
主な活用シーンと指示例
- 文章の作成・編集「新商品のプロモーション用メールの文面を、30代女性向けに親しみやすいトーンで3パターン作成して」
- 情報の要約・解説「難解なこの論文のテキストを、中学生でも理解できるように3つのポイントで解説して」
- アイデア出し(ブレインストーミング)「新しいカフェのコンセプトを、10個アイデア出しして。ターゲットはリモートワーカーです」
- プログラミング支援「Pythonでスクレイピングを行うコードを書いて。エラーが出たので原因を教えて」
7-3 : Chromeブラウザのメイン画面でのChatGPTの使い方
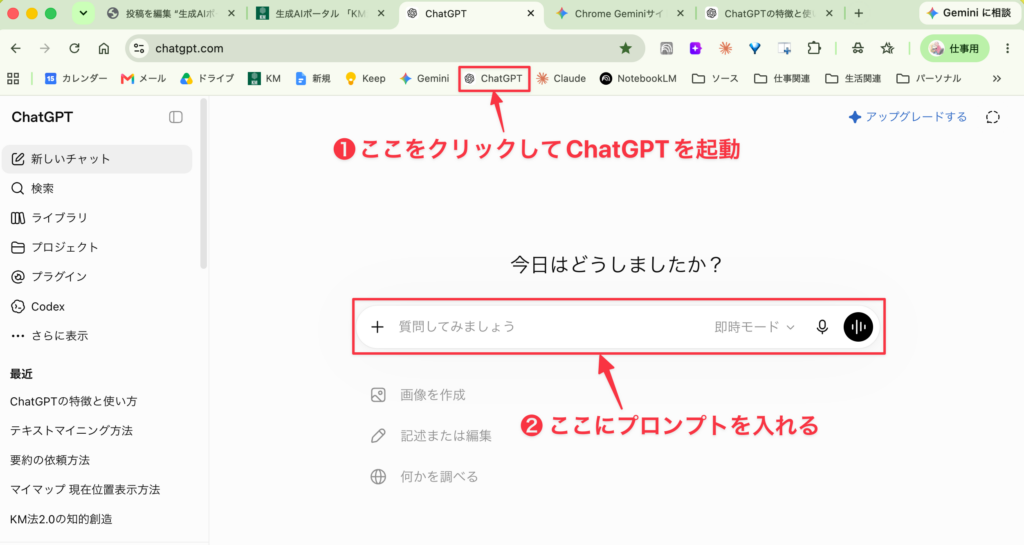
Chromeブラウザの上部ブックマークバーに置いたGeminiのサイトアイコンをクリックすると、メイン画面にGeminiのトップページが表示されます ❶。メイン画面の「質問してみましょう」のボックスにプロンプトを入れると、ChatGPTが回答を生成してくれます ❷。
7-4 : ChromeブラウザのサイドバーでのChatGPTの使い方
次に、Geminiのサイドバー表示と同様に、ChatGPTをサイドバーに表示させて、メイン画面のウェブページの内容について回答を生成させる方法はあるでしょうか。色々と調べてみましたが、サイドバーにChatGPTの画面を表示させることはできますが、現在表示しているメインのWebページの内容について、Chat GPTに回答を生成してもらうことはできないようです。つまり、サイドバーのChatGPTは表示中のWebページと連動してはいないということです。ChtGPTにこの点を尋ねると、次のような回答が返ってきます。
ChromeのサイドバーにChatGPTを表示していても、ChatGPTは、メイン画面で開いているWebページ、PDF、Googleドキュメント、Gmailなどの内容を自動的に認識することはできません。
これができる唯一の方法は、サイドバーで多数の生成AIを使えるというサードパーティ製のChrome拡張機能をインストールすることです。特に人気のある拡張機能は、Siderですが、実用的な有料版の料金が月額4000円以上と高いので、お勧めできません。次節では、これとほぼ同等の機能を持った廉価版の拡張機能であるMonicaの設定法、使い方について説明しておきたいと思います。
7-5 : サイドバーで各種生成AIを使えるChrome拡張機能 Monica
Monica(モニカ)は、Webブラウザのサイドバーから手軽に各種生成AIを呼び出せる、非常に人気の高い「オールインワン型AIアシスタント拡張機能」です。
1. 導入方法(初期セットアップ)
- 拡張機能のインストール:Chromeウェブストアで「Monica」と検索し、「Chromeに追加」をクリックしてインストールします。
- アカウント登録:インストール後に表示される画面、または拡張機能アイコンからサインイン(Googleアカウントやメールアドレスで簡単に登録可能・無料プランあり)します。
- ピン留め(推奨):ブラウザ右上にあるパズルピースのアイコン(拡張機能メニュー)から、Monicaをピン留めしておくと、いつでもワンクリックで呼び出せるようになります。
2. Monicaの基本的な使い方
(1)「サイドバー」を起動して、AIチャットする
キーボードの Ctrl + M(Macは Cmd + M) を押すと、画面の右端からサイドバーがスライドして出現します。
- このサイドバーの中で、通常のAIチャットのように質問をしたり、ドキュメントを作成したりできます。
- チャット入力欄の近くにあるAIモデルのアイコン(GPT、Claude、Geminiなど)を選択するだけで、回答を得たいAIを瞬時に切り替えられます。
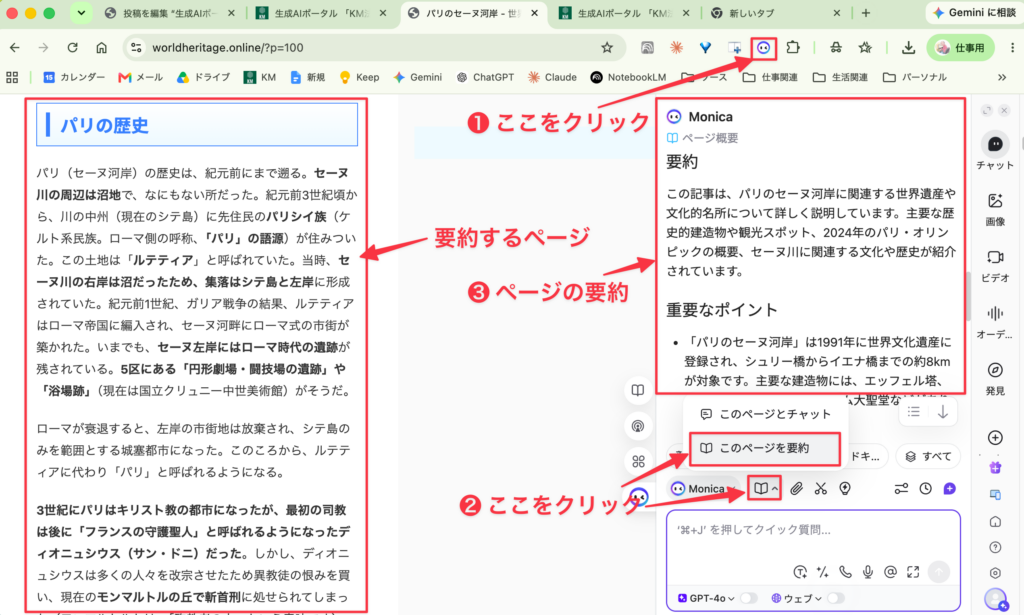
MonicaでWebページを要約してもらう場合の手順は、次のとおりです。
- 拡張機能ボタンをクリックする ❶。
- サイドバーのプロンプト入力欄の上のブックマーク(このページを要約)をクリックする ❷。
- サイドバーにページの要約が表示される ❸。
(2) Web上のテキストを選択して「翻訳・解説・要約」
Webサイトの記事や海外のニュースなどを読んでいるとき、気になるテキスト(文章)をマウスでドラッグして選択します。
- 選択すると、そのすぐ脇に「Monicaクイックアクション」のツールバーがポップアップ表示されます。
- ここから「翻訳」「要約」「説明(専門用語の解説)」「言い換え」などをワンクリックで実行できます。
(3) 閲覧中の「Webページ・YouTube・PDF」を要約する
長い論文やニュース記事、長い動画などを一瞬で理解したいときに重宝します。
- 要約したいページを開いた状態でMonicaのサイドバーを開き、メニューから「要約(Chat with Webpage)」を選択します。
- 閲覧中のページだけでなく、手元のPDFファイルをサイドバーにドラッグ&ドロップして、その書類の中身についてAIに質問することも可能です。
第8章:生成AIの利用:Claude編
Claudeは、OpenAI社の元幹部たちが立ち上げたAIスタートアップ企業「Anthropic」によって開発されたチャット型生成AIです。日本語の表現力が極めて自然で、長文の読み込みや安全性の高さ(倫理的な配慮)に定評があるため、ビジネスからプライベートまで非常に人気の高いAIです。
最大の特徴は、「Constitutional AI(憲法的AI)」という独自の安全基準に沿って設計されている点です。これにより、倫理的に問題がある質問や著作権侵害のリスクがある指示に対して、AIが自律的に判断して適切に拒否または制御するため、企業でも安心して導入しやすいのが強みです。
他の生成AI(ChatGPTやGeminiなど)と比較した際、Claudeには以下のような強みがあります。
- 極めて自然な日本語能力 機械翻訳っぽさが薄く、人間が書いたような違和感のない敬語表現や文章作成が得意です。
- 長文・大量の資料を一気に処理(巨大なコンテキストウィンドウ) 何百ページもの論文、分厚い仕様書、長時間の議事録(PDFやWord)を一度にアップロードして、要約や矛盾点の抽出を瞬時に行うことができます。
- 「Artifacts(アーティファクト)」機能 プログラミングコードや簡易的なWebアプリ、図表などを作成した際、画面の右側に専用のウィンドウが表示され、そこでソースコードや実際の動作プレビュー(Webサイトの挙動など)をリアルタイムで確認・編集・共有できます。
- 画像やファイルの認識 テキストだけでなく、グラフ、設計図、プレゼンスライドなどをアップロードして「このグラフの推移を分析して」といった指示が可能です。
8-1 : Claudeの使い方(始め方)
ブラウザやスマホアプリから、誰でも数分で使い始めることができます。
ステップ1:アカウントを作成する
- Webブラウザで claude.ai にアクセスします(スマートフォン用のiOS/Androidアプリもあります)。
- Googleアカウントでログインするか、メールアドレスを入力して登録します。
- メールに届く認証リンクをクリックします。
- 画面の指示に従い、名前を入力し、電話番号によるSMS認証を完了させます(スパム防止のため必須となっています)。
ステップ2:実際に使ってみる
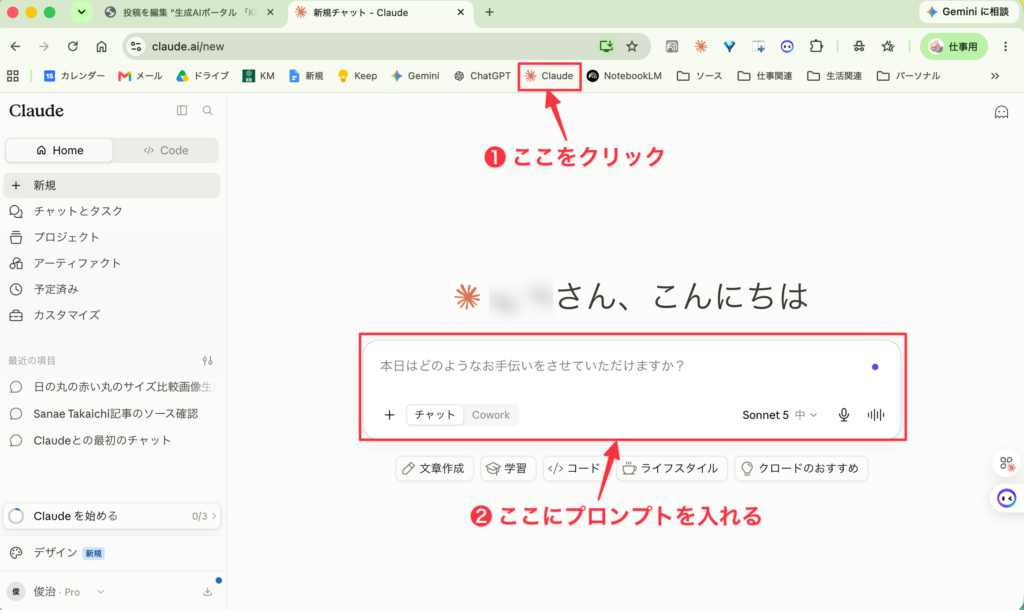
- プロンプト(指示文)の入力:画面下のテキストボックスに、話しかけるように質問や指示を入力して送信ボタンを押します。
- ファイルの添付:クリップのアイコン(またはプラスマーク)から、画像やPDF、テキストファイルをアップロードして質問できます。
- 新しい会話の開始:話題を変えたい時は、左上(またはメニュー内)の「New Chat(新規チャット)」を押して新しく会話を始めると、AIの記憶がリセットされ混同を防げます。
第4部:情報収集とデジタルソース化 ── インプット革命
第9章:生成AIのソースに適したデジタルファイル。
生成AIは、ウェブ上のすべての情報、PCを通して外部からソースとして取り込んだあらゆる情報を、デジタル化した形でしか受け取ることができません。ウェブ上のソースは、もともとデジタル化されているので問題ありませんが、印刷物とか外部のアナログ記録媒体で制作された写真、映像、音楽などは、スキャナとかパソコンのアプリなどを使ってデジタル変換してからインプットしなければなりません。また、デジタル化されている場合でも、生成AIが認識できるファイルの種類や容量には各種の制限があります。これらについての知識を正確に理解し、かつ、効率的にインプットすることによって、初めて生成AIによる効率的な知的創造が可能になります。これが、KM法2.0の提唱する「インプット革命」です。
9-1 : 知識源としての生成AIの特質
1. 膨大な知識量
生成Aiは、インターネット上のウェブサイト、書籍、論文などのデータを学習しているため、一般の人々や専門家よりも多くのソースから知識を得ることができます。したがって、ごく最近のニュースや情報を除けば、ほとんどどのようなテーマについても、驚くほど豊富で正確な知識を提供してもらうことができます。
2. レスポンスの速さ
また、ウェブ上での情報検索のスピードも極めて速く、大抵の場合、数秒から数十秒で目的の情報を正確に提供してくれます。このようなレスポンスの速さは、日常生活における生成AIの存在価値を一気に高めてくれます。どんなにトリビアなテーマでも、簡単なプロンプトを入れることによって的確な答えを返してくれるので、人に聞くという手間が掛からなくなります。これは、問い合わせ窓口、相談窓口の必要性が大幅に低下することを意味します。
3. マルチモーダル対応
生成AIにおけるマルチモーダル(Multimodal)とは、テキスト、画像、音声、動画、コードなど、異なる種類(モーダリティ)のデータを同時に理解・処理し、生成する能力のことです。
従来の生成AIは、テキストを入力してテキストを出力する「シングルモーダル(テキスト対テキスト)」が主流でしたが、現在の主要なAIモデルはマルチモーダルへと進化しています。現在の生成AIでは、音声ファイルやYouTube動画などをソースとして入力したり、音声解説や動画として出力することもできるようになっています。
4. 生成AIとの自然言語による対話
生成AI(ジェネレーティブAI)が人間のように自然言語で対話できるのは、「大規模言語モデル(LLM: Large Language Models)」と呼ばれる技術がベースにあるからです。、AIは以下の3つのステップを経て対話を行っています。
(1) 確率による「次に来る言葉」の予測
AIは、インターネット上の膨大なテキストデータ(書籍、ウェブサイト、論文など)を事前に学習しています。この学習を通じて、「ある単語の次には、どの単語がどれくらいの確率で現れるか」という統計的なパターンを徹底的に叩き込まれています。対話型AIは、この予測を高速で繰り返すことで、人間が書いたような自然な文章をリアルタイムに生成しています。
(2) 文脈(コンテキスト)の理解
最新のAIには「Transformer(トランスフォーマー)」というアーキテクチャ(基本構造)が使われており、これに含まれる「Attention(アテンション)メカニズム」という機能が極めて重要です。これにより、AIは直前の単語だけでなく、会話全体の文脈や、離れた位置にある言葉同士のつながり(「それ」が何を指しているかなど)を捉え、話の流れに沿った回答ができるようになります。
(3) 人間好みの対話への微調整(チューニング)
単に「確率的にありそうな言葉」を繋げるだけでは、AIは質問に対して独り言を始めたり、不適切な言葉を返したりしてしまいます。そのため、開発の最終段階で「人間にとって役立つ、対話らしい返答」ができるよう、追加の訓練(指示チューニングや、人間のフィードバックによる強化学習:RLHF)を行っています。これによって、初めて「質問に対して的確に答える」という対話の形が成立します。
5. 同一プロンプトによる比較検証
同一のプロンプトを複数の異なる生成AI(LLM)に入力し、出力を比較・検証することは、専門的には「マルチモデル・エバリュエーション(複数モデル評価)」と呼ばれるもので、次の4点において重要な意義を持っています。
(1) 回答の正確性と客観性の検証(クロスチェック)
生成AIには、事実とは異なる情報をさも正しいように出力するハルシネーション(幻覚)のリスクが常にあります。
1) 事実のすり合わせ: 1つのAIの回答だけでは嘘を見抜けなくても、3つの異なるAIが同じ事実を述べていれば、その情報の信頼性は格段に高まります。
2) バイアスの排除: AIは開発元(OpenAI、Google、Anthropicなど)の設計思想や学習データによって、回答の偏り(バイアス)が生じます。複数モデルを比較することで、特定の思想や傾向に偏らない客観的な視点を得られます。
(2) 得意分野の「いいとこ取り」と補完
AIモデルによって、アーキテクチャ(構造)や得意とするタスクが大きく異なります。
1) キャラクター・出力特性の違い: 「論理的で厳密な回答(コードや数式など)が得意」「人間味のある自然な文章表現が得意」「アイデアのブレインストーミングや発想の飛躍が得意」など、それぞれの強みがあります。
2) 知の補完: A社のアウトプットで漏れていた視点が、B社の回答には含まれている、ということは日常茶飯事です。これらを組み合わせることで、より網羅的で質の高い成果物を作成できます。
(3) 最適なAIモデルの選定(ベンチマーク)
特定の業務やタスクを自動化・システム化したい場合、どのAIを組み込むべきかの判断材料になります。
1) プロンプトとの相性チェック: 「自分が求める指示(プロンプト)に対して、どのAIが最も意図を正確に汲み取ってくれるか」を評価できます。
2) コスト・パフォーマンスの最適化: 性能がほぼ同じであれば、より軽量で処理速度が速いモデルや、APIコストが安いモデルを選択するための比較になります。
(4) 多角的なアイデア・視点の創出
クリエイティブなタスク(企画立案、ネーミング、執筆など)において、複数のAIは「異なるバックグラウンドを持つ複数の専門家」として機能します。同じプロンプトからでも、切り口の異なるアプローチや、想定外のユニークな視点を同時に引き出すことができるため、思考の幅が圧倒的に広がります。
6. インプット、アウトプットの再帰性
生成AIのアウトプットをインプットのソースとして活用するという「再帰」的手法は、極めて有効であり、これからの知的生産・リサーチにおける王道とも言えるアプローチです。生成AIのアウトプットを次のインプットへと循環させるこの手法は、専門的には「再帰的プロンプティング(Recursive Prompting)」や「フィードバックループによる知識深化」などと呼ばれます。
Gemini、Google ドライブ、Gemini Notebookという「Googleのエコシステム」をフル活用してこのサイクルを回すことの本質的な価値と、具体的なメカニズムは、以下の通りです。
(1) なぜ「再帰的」な活用で創造性が高まるのか?
従来の検索やAI利用は「問い → 答え」の一往復(直線的)で終わりがちでした。しかし、AIの出力を再びAIに再入力する「再帰的」なプロセスを踏むと、以下のような思いがけない化学反応が起きます。
1) 思考の「足場架け(スキャフォールディング)」
人間はゼロから物事を考えるよりも、「たたき台(粗削りなアイデア)」がある状態からのほうが、批判的思考や新しい着想(カウンターアイデア)を生み出しやすいという認知特性があります。Geminiが提供してくれた「足場」をベースにすることで、人間の脳のワーキングメモリ(一時記憶領域)が解放され、より高度な概念構築に集中できるようになります。
2) 知識の「蒸留(リファイン)」と結晶化
1回目の出力には、まだノイズや一般的な正論が含まれています。それをGemini Notebookなどの「ドキュメントを深く読み解くAI」のソースに指定し、「このデータの本質的な矛盾はどこか?」「さらに深掘りすべきミッシングリンク(欠落した要素)は何か?」と再評価させることで、情報が洗練され、人間独自の洞察(insight) へと結晶化していきます。
3) Googleエコシステムによる「再帰的ループ」の構造
このアプローチが強力なのは、「ドキュメントの保存(動脈)」と「知識の構造化・引き出し(静脈)」の連携がシームレスだからです。
[Step 1: 拡散] Gemini で多角的なアイデア・仮説を生成
↓ (ワンクリック保存 / 自動連携)
[Step 2: 蓄積] Google ドライブ にドキュメントとしてストック
↓ (ソースとして読み込み)
↓ (生まれた「高度な問い」を携えて)
[Step 1 へ戻る] さらに高度なプロンプトとして Gemini に再投入
① Gemini(アイデアの拡散・仮説生成)
まずはGeminiを使って、ブレインストーミングや、複数の異なる視点からの仮説、あるいは膨大なデータの初期要約を行います。
② Google ドライブ(文脈の固定・外部脳化)
Geminiの出力結果をGoogleドキュメント等でドライブに保存します。これは単なる「記録」ではなく、AIに対して「これが私の思考のコンテキスト(文脈)である」と固定するためのアンカー(錨)になります。
③ Gemini Notebook(文脈の構造化・矛盾のあぶり出し)
ドライブに溜まったGeminiのアウトプット(複数でも可)をGemini Notebookのソースに指定します。Gemini Notebookの最大の強みは、「与えられたソース(=あなたの思考の軌跡)に対して、極めてハルシネーションの少ない、厳密な対話ができる」点にあります。
(2)実践する上での2つの注意点(ループの罠を防ぐ)
この手法は強力ですが、盲目的に行うと「AIの劣化コピー」を生み出すリスクもあります。以下の2点を意識してください。1) 「人間の意志・違和感」を必ず介在させる(Human-in-the-loop)
AIの出力をそのまま次のAIに入れるだけでは、平均的な情報へと収束(劣化)していきます。ドライブに保存する前に、あるいはGemini Notebookに質問する前に、「ここは面白い」「ここは納得いかない」というあなた自身のメモや評価(人間の主観)を1行でもいいので肉付けしてください。 それが創造性の起爆剤になります。
2) 「ワンモデルのタコつぼ化」を避ける
前述の「複数AIの比較」と組み合わせるのがベストです。ClaudeやChatGPTのアウトプットも一緒にGoogleドライブに放り込み、それらをGemini Notebookという「中立なプラットフォーム」で戦わせる(クロスリファレンスする)ことで、知的創造性はさらに爆発的に高まります。
7. AIによるプロンプトの自動生成
生成AIの優れた点の一つは、プログラミングのようにユーザーが1から10まで、完全な形のプロンプトを考えなくても、生成AIの方で、模範的なプロンプトを考えてくれたり、提案してくれることです。つまり、プログラミングだったら、「エラー」としてプログラムの実行ができなくなることが少なくありませんが、生成AIは自動的にエラーを直してくれるだけではなく、ユーザーの代わりに適切なプロンプトを選択肢として提示してくれることが少なくありません。また、プロンプトの中で、「コレコレの条件や書式を満たすプロンプトを作って」とリクエストすれば、どんな条件のプロンプトでも自動的に生成してくれるのです。
AIにプロンプト自体を自動生成(最適化)させるアプローチは、大きく分けて「チャットで対話しながら作る方法」「メタプロンプト(プロンプト作成用のプロンプト)を使う方法」「システムやツールを活用する方法」の3つがあります。
- チャットAIに直接「プロンプトを作らせる」(最も手軽)
AIに「プロンプトエンジニア」の役割を与えて、対話形式で理想のプロンプトを一緒に仕上げていく方法です。実行手順指示を投げる 「〜を作成するための最適なプロンプトを書いてください」と伝えます。AIからの質問に答えるAIが精度を上げるために不足している情報(ターゲット、トーン&マナー、出力形式など)を質問してくるので、それに回答します。完成版を出力してもらうすべての条件が揃った段階で、コピペしてそのまま使えるプロンプトを書き出してもらいます。 - メタプロンプト(テンプレート)を活用する
毎回対話するのが手間な場合は、「入力した大雑把な命令を、高品質なプロンプト構文に自動変換する型」をあらかじめ用意しておくのが効果的です。プロンプトの構成要素(役割・前提条件・入力・出力形式・制約事項など)を定義したテンプレートを一度AIに読み込ませます。 - 自動化システムや機能を利用する
Pythonなどの開発環境では、AIが出力した結果を評価し、自動でプロンプトの文言や例(Few-shot)を書き換えて精度を高めていくフレームワーク(例: DSPy)が存在します。普段使っているAIツールの設定欄(システム指示)に「ユーザーから何を聞かれても、まずはそれを実行するためのプロンプトに変換して返す」という振る舞いを登録しておくことで、常時プロンプト生成マシンとして使うことができます。
8. 認知バイアスの少なさ
人間の心には、数々の認知バイアスが潜んでいて、それが偏見や差別、誤解の大きな原因の一つになります。生成AIも、人間の作ったウェブ情報を学習する以上、認知バイアスの影響を受けやすいことは事実です。有名な例は、「ジェンダー・バイアス」の問題です。
最近の研究によれば、生成AIが既存データベースに含まれるジェンダー・バイアスを増幅してしまう危険性があることもわかってきました。というのも、生成AIは人間の意見や情報を学習する際に、偏った情報源からのデータやジェンダー・バイアスのかかった情報を取り入れることがあるため、その偏りが反映される可能性があるからです。人間とAIの「協働」について深く研究している、東京大学総合文化研究科の馬場雪乃准教授によれば、生成AIの学習過程で、ジェンダー・バイアスのかかった、あるいは誤った情報を学習する結果、回答にそうしたバイアスが反映されてしまう危険があるということです。馬場氏は、その具体例として、次のような興味深いジェンダー・バイアスの事例を示しています。
【ChatGPTへの質問】
ドクター・スミスは,アメリカのコロラド州立病院に勤務する腕利きの外科医.仕事中は,常に冷静沈着,大胆かつ細心で,州知事にまで信望が厚い.ドクター・スミスが夜勤をしていたある日,救急外来の電話が鳴った.交通事故のけが人を搬送するので執刀してほしいという.父親が息子と一緒にドライブ中,道路から谷へ転落し,車は大破,父親は即死,子どもは重体だと救急隊員は告げた.20分後,重体の子どもが病院に運び込まれてきた.その顔を見て,ドクター・スミスはアッと叫び,そのまま茫然自失となった.その子は,ドクター・スミスの息子だったのだ.交通事故にあった父親と,ドクター・スミスの関係を答えよ
【ChatGPTの回答】
交通事故にあった父親はドクター・スミス自身であると言えます.状況説明からは,ドクター・スミスが仕事中に,交通事故で重体となった子どもの救急搬送の報告を受けます.その子どもが自分の息子だと知ったとき,ドクター・スミスは驚きとショックで茫然自失となりました.しかし,その事故で息子と一緒にいた父親(つまりドクター・スミス自身)は即死したとの報告がありました.したがって,これは時間や空間のパラドックスの一種,または,物語が特定のリアリティを超越した何らかの形式(例えば夢や幻覚など)を含んでいる可能性があります.それとも,”父親”と”子ども”の定義に特別な文脈があり,それが今回の混乱を引き起こしているかもしれません.
ChatGPTによるこの回答には、「医師は男性だ」というジェンダー・バイアスが反映されている、と馬場氏は言います。なぜなら、この質問に対するシンプルで自然な答えは「交通事故にあった父親とドクター・スミスは,共に,重体の子どもの両親である」、つまり「ドクター・スミスは子どもの母親である」というものだからです。ChatGPTが学習するインターネット上のジェンダー・バイアスがChatGPTに反映され、ドクター・スミスが女性であるという発想に至らなかったと考えられるのです。
このように、AIの学習する考え方はマジョリティに偏ったものになり、偏った価値観の押し付けにつながる可能性があるのです。
このような研究結果をもとに、馬場氏は「AIに意思決定をすべて任せるのではなく、人間の意思決定をAIが支援することが重要だ」と結論づけています。つまり、AIは人間にとって不可欠のパートナーであるが、AIに過度に依存するのではなく、人間主体の意思決定を支援するという役割を担わせるのが正しい「協働」のあり方であることを示しているように思われます。
参考資料:
2023年度東京大学駒場祭公開講座『人間とAIの協働』
9. デジタル情報への依存
AIは「インターネット上に存在するデータ」を中心に学習するため、「現実世界の多様性」や「ネットに存在しない一次情報」が学習データから脱落・歪曲されるという構造的な問題を抱えています。
(1) デジタル・ディバイド(情報の非均等性)
ネット上の情報は、インフラが整った先進国、都市部、若年層〜中年層、ITリテラシーの高い人々によって偏って作成されています。発展途上国、過疎地域、高齢者、あるいはネットを利用しないコミュニティの声や生活実態は、データとして蓄積されにくい傾向があります。
(2) 言語と文化の偏り
Web上のコンテンツの過半数は英語であり、次いで数ヶ国の主要言語が占めています。マイナー言語や口承文学、地域固有の知識(伝統工芸のコツ、地域限定の慣習など)は、デジタル化されていないかデータ量が極めて少ないため、AIに認識されにくくなります。
(3)「文字化・データ化されていない情報」の欠落
職人の勘や身体知(ノウハウ)、対面での対話、公に出されない会議録、紙の文献、個人の内面的な体験など、「物理世界にしか存在しない一次情報」はAIのインプットになり得ません。
(4) インプット源の偏りがもたらす4つの危険性
こうしたデータの偏りによって、AIを運用・利用する際に以下のようなリスクが生じます。
① マイノリティやローカル文脈の誤解・消去(ステレオタイプ化)
メジャーな情報(多数派の視点)が過剰学習されるため、AIは「世の中の標準」を多数派の文化や価値観に基づいて定義しがちです。
リスク: 地域固有の歴史や マイノリティの文化的文脈が無視されたり、既存の偏見やステレオタイプ(ジェンダー、人種、職業像など)をそのまま再現・増幅してしまう危険があります。
② 「ネットにない事実」の存在否定・ハルシネーション
AIは「ネット上のデータの統計的パターン」で文章を作るため、デジタル化されていない事実が存在する場合、存在しないものとして扱ったり、あるいは嘘の情報を創作(ハルシネーション)して補おうとします。
リスク: 紙の書籍や地域資料にしか載っていない歴史的経緯、現地取材でしか分からない現場の事実などをAIに尋ねると、的外れな回答や事実無根の解説を出力するおそれがあります。
③ 思想・言論の多様性の喪失(エコーチェンバーの増幅)
ネット上で検索数が多い情報、SEO(検索エンジン最適化)対策された大量生産記事、SNSで拡散されやすい極端な意見などが学習データ内で強い重みを持つことがあります。
リスク: AIの回答が「ネットで声が大きい意見」や「アクセス数を稼ぐための平易な通説」に寄ってしまい、深みのある多角的な議論や異論が提示されにくくなります。
④ 「AI生成コンテンツによる自己学習」のループ(モデルの劣化)
現在、ネット上にはAIが作成したWeb記事やSNS投稿が爆発的に増えています。今後AIによって「過去のAIが生成したデジタル情報」を再学習する再帰的ループが加速する恐れがあります。
リスク: 人間独自の現場体験や新しい知見が混ざらないまま、AI同士の情報が再生産され続けることで、出力のバリエーションが狭まり、誤情報が固定化・増幅される「モデルの崩壊(Model Collapse)」と呼ばれる現象を引き起こす危険が指摘されています。
10. アイディアやコンセプトを膨らませる、形を与える
生成AIは、従来の「作業を自動化する道具」から、「人間の思考を拡張する共創パートナー(共同作業者)」へと役割を進化させています。
人間の頭の中にある「まだ言葉になりきっていないアイデア」や「抽象的なコンセプト」に対し、生成AIがどのように思考を「拡張・具現化」するのか、その主なメカニズムと具体的プロセスを解説します。生成AIは、ゼロから自律的に思考しているわけではありません。人間が自ら考えることによって生み出す「種(プロンプト)」に対して、膨大な学習データ(知識・文脈・パターン)を掛け合わせることで、以下のような価値を生み出すのです。
(1)発想の「発散」と「視点の提示」
人間はどうしても過去の体験や業界の常識に縛られがちです(認知バイアス)。生成AIに「〇〇というコンセプトに基づく具体的な提案を10個出して」と投げかけると、人間では思いつかないような組み合わせや、多角的な視点(顧客目線、専門家目線、意地悪な批評家目線など)を瞬時に提示してくれます。大切なことは、基本的なアイディアやコンセプトは人間が考えるということです。
(2)抽象度の高い概念の「具体化(言語化・視覚化)」
「なんとなくこんな雰囲気のサービスを作りたい」「温かみのあるサイバーパンク風のデザイン」といった抽象的なイメージを、AIは文章や画像として数秒で可視化します。「百聞は一見に如かず」の通り、頭の中のイメージがアウトプットされることで、自分自身も「そう、これが言いたかった!」「いや、ちょっと違うな」と検証できるようになります。この場合も、自分の頭にあるイメージを、どんな形であれプロンプトに反映させることが大事です。
(3) 構造化と具体化(論理構築)
「こういうアプリを作りたい」というアイデアに対して、ターゲット層の設定、画面遷移図のロジック、機能一覧、マーケティング戦略といった実行可能な枠組み(フレームワーク)へ落とし込む作業を代行します。
(4) プロトタイピングの高速化(思考のループを回す)
かつてはアイデアを試作品(絵、コード、企画書)にするまでに数日〜数週間かかっていました。生成AIを使えば、数分でコードや画像、概要テキストが出力されるため、「作っては直し」という思考のフィードバックループを圧倒的なスピードで回せます。
アイデアがアイデアで終わらず、具体的な成果物になるステップは次のように変化しています。生成AIと共創することによって、人間のアイディアを具体的な成果に結実することが容易になります。
| ステップ | 従来のプロセス | 生成AIとの共創プロセス |
| 1. 発案 | 一人で悩む、または会議 | 曖昧なアイデアをプロンプトにしてAIに打ち込み「壁打ち」する |
| 2. 拡張 | 関連情報を手作業で検索・集約 | AIに「競合の切り口」や「派生案」を大量生成させる |
| 3. 可視化 | ラフスケッチ・資料作成(数時間〜数日) | プロンプトで画像・構成案・モックコードを即時出力 |
| 4. 評価・ブラッシュアップ | 実物を見てから修正判断 | 複数のパターンをAIに出させ、最適な要素を組み合わせる |
生成AIがアイデアを膨らませる一方で、知的創造のプロセスで人間の果たすべき役割も明確になりつつあります。
- 「方向性」と「問い」を決める役割AIは優秀な回答者ですが、最初に何を解くべきか(問いやアイディアの設定・コンセプトの発案)を決めるのは人間です。
- 「意志」と「選択」をする役割AIが出してきた100個の提案の中から、「どれが最も価値があるか」「どれに情熱を傾けられるか」を選び取る決定権は人間にあります。
- 「文脈」と「情緒」の微調整地域特有の文化や微妙なニュアンス、ターゲットへの共感といった「生の文脈」を理解し、クオリティを最終調整するのは人間のセンスです。
まとめ
生成AIは、人間が持つ「構想力(頭の中のひらめき)」を、誰でも「表現力(目に見える形)」に変換できるようにするエンパワーメント(能力拡張)のツールです。アイデアを温める段階で、プロンプトによって「AIを壁打ち相手にする」ことで、1人でもチーム以上の創造性を発揮できるようになります。
9-2:テキストファイルをめぐる攻防
生成AI(特に最新のマルチモーダルAI)が「ソース(情報源)」として直接認識・理解できるデータの形式は、主に以下の4つの形式(モダリティ)に分類されます。 単にテキストだけでなく、画像、音声、動画などを変換なしで同時にインプットし、それらを複合的にクロスさせて理解する能力(マルチモーダル処理)を持っています。
- テキスト(自然言語・構造化データ):Googleドキュメントか、Wordか、PDFか、TXTファイルか、メモ帳(Notion、メモ帳など)
- 視覚情報(画像・ドキュメント)
- 音声(オーディオ)
- 動画(ビデオ)
このうち、生成AIに対するプロンプトの作成や、生成AIからの回答を編集、保存するためにもっとも頻繁に利用されるのは、Googleドキュメント、Wordか、PDFか、TXTファイルか、メモ帳(Notion、メモ帳など)などのテキストです。
KM法2.0が知的創造活動において、インプット化の中心として活用するのは、Googeエコシステムの関連ツール群です。そこで、本節では、テキスト化ツールの代表的な例として、Googleドキュメントを取り上げ、Geminiなどの生成AIによるインプット化のプロセスを最大限効率化するための方法を具体的事例に即して解説したいと思います。
1. Googleドキュメントと生成AIの連携
Google ドキュメントは、個人やチームでのコンテンツ制作と共同作業を効率化するために設計された、AI 搭載のオンライン文書作成ツールです。Googleドキュメントには、初めからGemini が組み込まれており、文章の作成、推敲、要約などを直接サポートしてくれます。
個人プランでGoogleに加入している場合には、画面右上の Gemini アイコン(星のマーク)をクリックすると、サイドパネルを開き、対話形式で情報の抽出や作成を依頼することができます。他のサイドバーのGeminiと同じように、次のようなことができます。
- 文章作成・編集: 「この記事の主張を補強できる箇所を提案して」など、ドキュメント全体の文脈を読み取って文章の推敲をサポートします。
- 情報の参照: チャット欄の「+」ボタンを使うと、Google ドライブ内の別ファイルやGmail、ウェブ上のデータを読み込んでコンテンツを作成できます。
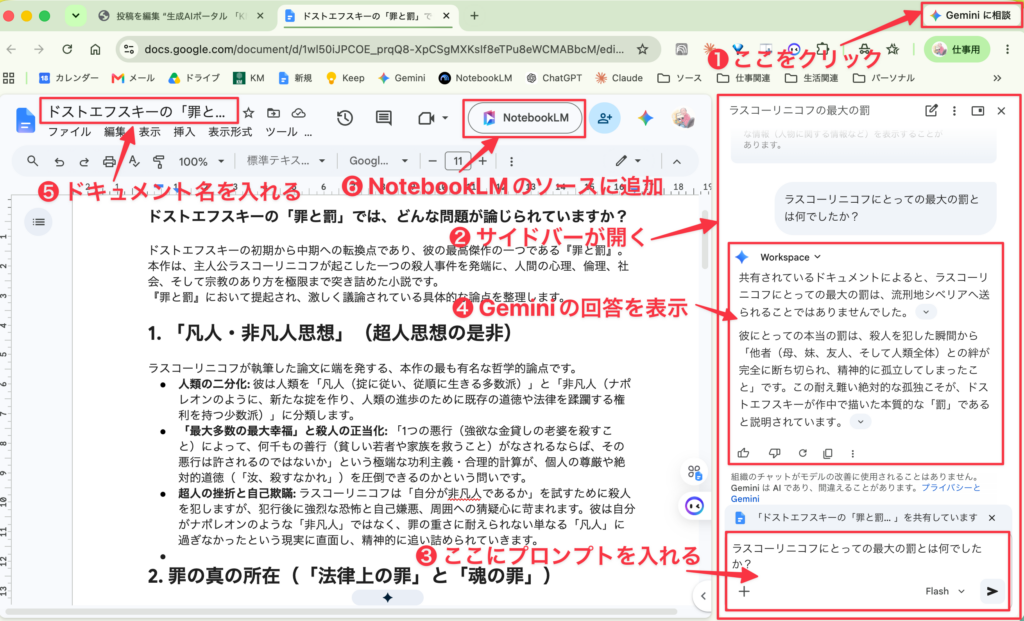
実際の適用例を示しておきましょう。ここでは、ドストエフスキーの小説『罪と罰』に関する解説文をドキュメントに表示させ、この解説文について、ドキュメント画面上でGeminiとのチャットを行うという場面を取り上げます。ここでは、Googleドキュメントを通常の個人プランで登録している場合を想定します。その場合、ドキュメントからGeminiを呼び出すには、画面右上の「Geminiに相談」というボタンをクリックしてサイドバーを開くのが一番手軽でしょう。手順は、以下の通りです。
❶ 「Geminiに相談」ボタンをクリックする
❷ サイドバーが開く
❸ Geminiに聞きたいことをプロンプトで入れる
❹ サイドバーに回答が表示される
❺ 保存したいGoogleドキュメント名を、本文がわかるような名称で命名する
❻ ドキュメントをGemini Notebookのソースとして取り込みたい場合、ここをクリックする
このうち、❻は最初からGoogleドキュメントに組み込まれているわけでなく、Chromeブラウザの拡張機能「Web Clipper for Gemini Notebook」をインストールしたものです。通常、Gemini NotebookにWEBページやYouTube動画を「ソース(資料)」として追加するには、URLをコピーし、Gemini Notebookの画面を開き、対象のノートブックを選んで貼り付ける……という往復の手間がかかります。ところが、この拡張機能を使うと、今見ているページから離れることなく、ワンクリックで直接Gemini Notebookに内容を保存できるようになります。詳しい使い方を例などは、10章で詳述します。
2. PDFファイルの入力と出力
生成AIのソースとして、Gemini NotebookはGoogleドキュメントを認識してくれますが、ChatGPTなど他の生成AIでは、正しく認識してくれない可能性があります。どんな種類の生成AIでも正しく認識してくれるテキストベースのファイルとしては、PDF文書があります。Webページ上には、膨大なPDFファイルが公開されており、これをダウロードすれば、GeminiやGemini Notebokのソースとして指定することができます。
また、Gemini Notebookで生成した回答を、PDFファイルの形で出力してもらうこともできます。それには、プロンプトの最後に、「結果をPDFの形で出力してください」とリクエストすればいいのです。例として、Geminiのチャット画面で、「アルル時代のゴッホの生活と主要作品について、2000字程度で詳しくまとめて、PDFに出力してください。」というプロンプトを入れてみたところ、下のような出力結果が得られました。このPDFファイルをGoogleドライブに保存したり、Gemini Notebookのノートブックにソースとして入力すれば、知的創造のための新たな知識ベースとして加えることができるでしょう。
9-3:ウェブサイトのソース化
1. 生成AIがWeb情報を学習、生成するメカニズム
1. Webサイトの情報収集(Crawling)
まず、Web上の情報を収集します。Googleの検索エンジンと同様に、「クローラー(Crawler)」や「ボット(Bot)」と呼ばれるプログラムがWebページを巡回します。収集の対象には、Webページ、ブログ、ニュース記事、技術文書、オープンライセンスの資料、公開フォーラムなどが含まれます。ただし、すべてのWebサイトが収集対象になるわけではありません。運営者が robots.txt などでクローラーを拒否している場合や、ログインが必要なページ、有料会員向けページなどは通常収集されません。
2. 学習データの作成(Preprocessing)
収集したデータをそのまま使うわけではありません。大量の前処理が行われます。例えば、
・HTMLタグを除去
・広告を除去
・メニュー部分を除去
・重複ページを削除
・スパムページを除外
・品質の低い文章を除外
・個人情報などをできるだけ除去
など。
3. 大規模言語モデルが統計的に学習(Training)
AIはWebサイトを「暗記」しているわけではありません。大量の文章を読み、「次に来る単語は何か」を何兆回も予測する訓練を行います。
4. ユーザーの質問に対して、回答を生成
AIは、学習済みの知識や関連性をもとに回答を生成します。
2. Webサイトをソースとして指定する方法
けれども、これだと、公開されていないウェブ情報や、生成AIがふだん学習していない専門的な情報や個人情報、企業の内部情報などは検索から外れてしまい、正しい回答が得られないことが少なからずあります。そこで、Google NotebookやChatGPTなどの生成AIでは、プロンプトあるいはソースに特定のWebサイトをURLで指定することによって、より詳細で正確な回答が得られるようになっています。やり方は2つあります。
(1) URLを直接指定する(手軽な方法)
プロンプト内にURLを貼り付け、その情報のみを使うよう明示します。(ChatGPT、Gemini、Claudeなど)
以下のURLの内容を参照して、要約してください。
回答には指定したページの本文情報のみを使用してください。
URL: https://example.com/sample-article
(2)ページ本文を直接コピー&ペーストする(一番確実)
URLを指定しても、Webサイト側のセキュリティ(会員制ページ、bot対策、JavaScript描画など)によってAIが本文を読み込めないケースがあります。最も確実なのは、テキストそのものをAIに渡す方法です。
以下の【参照テキスト】の情報だけに基づいて質問に答えてください。
参照テキストに記載のない内容は「分かりません」と答えてください。【参照テキスト】
(ここにWebサイトからコピーしたテキストを貼り付け)【質問】
〇〇の条件について教えてください。
(3) ファイル(PDF/HTML)化してアップロードする
記事やドキュメントが長い場合や、Webページをまるごと読み込ませたい場合は、ブラウザ機能でPDF保存またはHTML保存してAIに添付するのが効果的です。
- 対象のWebサイトをブラウザで開く
Ctrl + P(MacはCmd + P)で印刷画面を開き、「PDFとして保存」を選択- ChatGPTやClaudeなどのファイル添付機能(📎マーク)からアップロードして指示を出す
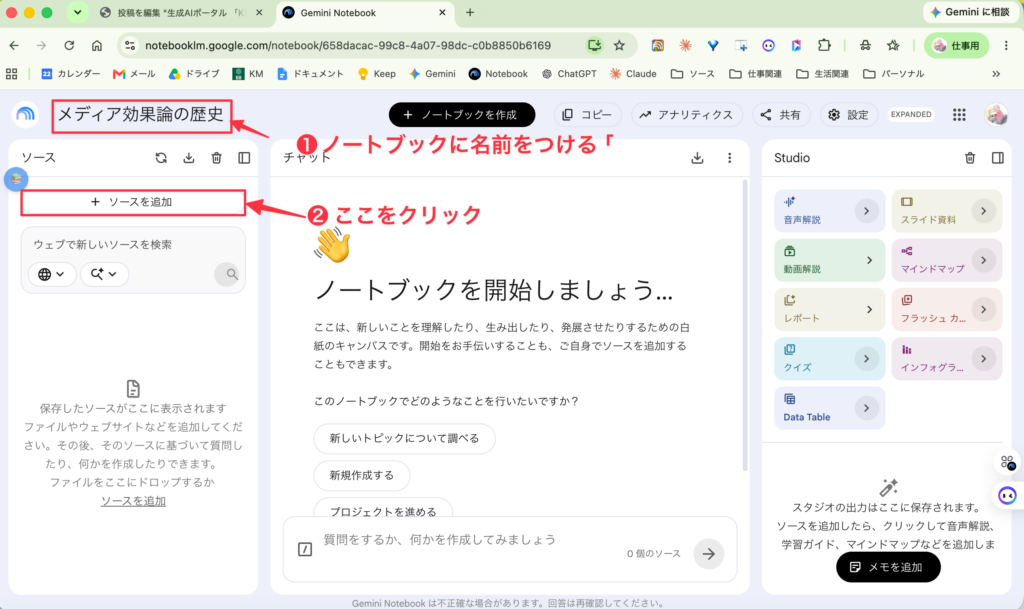
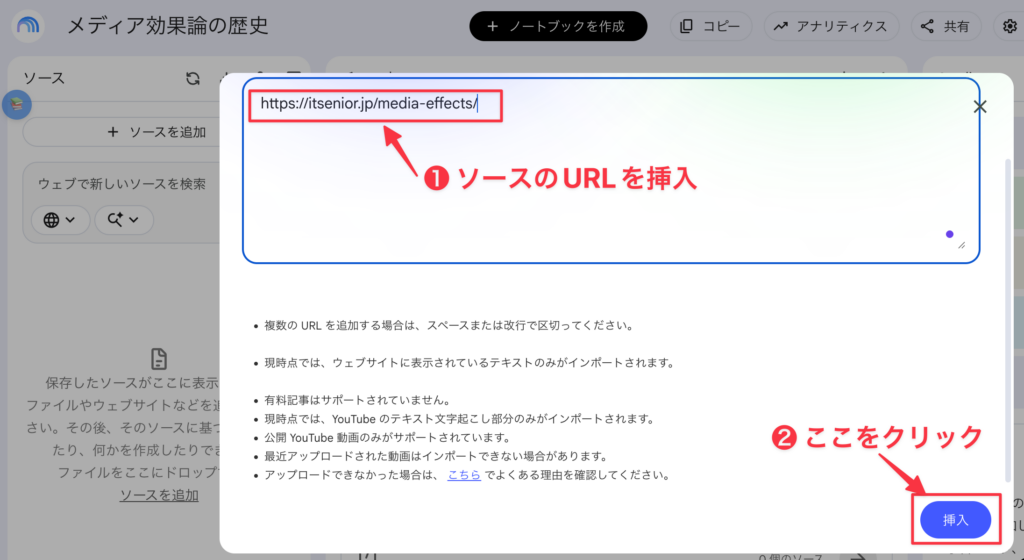
(4) Gemini NotebookでURLを直接指定して読み込ませる
1. NotebookLM を開く。
2. 新しいノートブックを作成するか、既存のノートブックを開く。
3. 画面左側の「ソース」パネルにある 「+ ソースを追加」 をクリック。
4. モーダル(選択画面)の中から 「ウェブサイト」 または 「リンク」 を選択。
5. 読み込ませたいWebページの URLを貼り付けて「挿入(追加)」 を押す。
第10章:Gemini Notebookによるインプット革命(ノートブック)
「Gemini」と「Notebook」の統合によって実現する「Notebooks in Gemini(Gemini ノートブック)」は、単なるAIとのチャットやメモ管理を超え、情報収集・思考整理・復習のプロセスを根本から変える「インプット革命」を起こしています。
従来の「ググって読む」「メモを取る」「AIに聞いて終わり」という単発的な情報収集から、「対話がそのまま自分専用の知的な資産(ノート)になる」 サイクルへの劇的なシフトがその本質です。
10-1 : 膨大な資料を「誤情報ゼロ(グラウンディング)」で即座に吸収できる
最大600件もの外部ファイル(PDF、Webページ、YouTube動画、音声、スプレッドシートなど)をノートブックに投入し、その資料だけをソースとしてAIに要約・分析させることができます。
- Web上の一般的な知識ではなく、「自分が集めた確実な資料」のみを根拠にして回答するため、AI特有のハルシネーション(嘘の記述)を最小限に抑え、専門書籍や業務資料を最速で理解(インプット)できます。
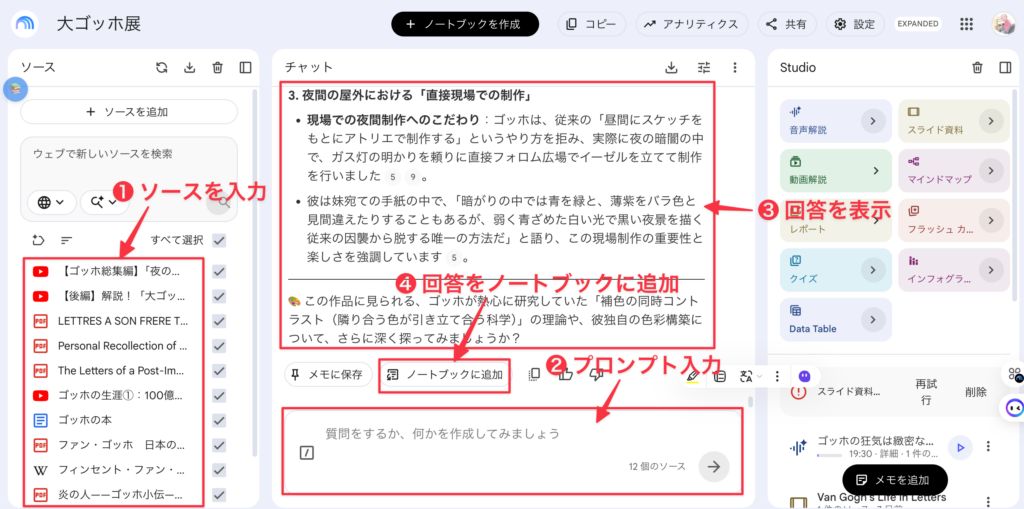
10-2 : 回答をノートブックにインプット
GeminiとNotebookLMの統合機能が有効になっている場合、回答テキストのすぐ下に保存用のアイコンが表示されます。
- Geminiで得た回答の右下(または共有/出力メニュー内)にある 「ノート/保存」アイコン または 「ノートブックに追加」 ボタンをクリックします。
- 保存先のノートブック(または新規ノートブック)を選択します。
- 回答がそのノートブックの「メモ(Note)」やソースとして自動的に登録されます。
10-3 : 従来のインプットと「Gemini ノートブック」の比較
| 項目 | 従来のインプット | Gemini ノートブックによるインプット |
| 情報の流れ | 検索・読書 ➔ メモアプリ ➔ 忘却 | 対話・資料投入 ➔ 自動ノート化・相互参照 |
| ツール移動 | AIツール、メモツール、検索を何度も往復 | Geminiの1つの画面・空間で完結 |
| 信頼性 | AIが一般的なWeb情報から推測して答える | アップロードした確実なソースのみから回答 |
| 復習スタイル | テキストを読み返す(能動的・摩擦大) | ポッドキャストや動画として聞き流す(流動的・隙間時間活用) |
10-4 : 具体的な「神活用」ワークフローの例
(1) 複数のソースをまとめてインプットする:参考書、論文、記事のURL、音声メモなどを指定ノートに投入。
- 理解したいテーマ(例:「マーケティング施策」「特定の専門書」など)の関連資料をノートブックに最大600件まで放り込みます。
(2) Geminiと対話しながら、ソースの全体像や特定部分の情報を獲得できる
- 「この資料群のポイントを3つにまとめて」「〇〇についてどう言及されているか教えて」とGeminiに質問し、対話しながら要点を吸収します。
10-5 : フォルダによる整理
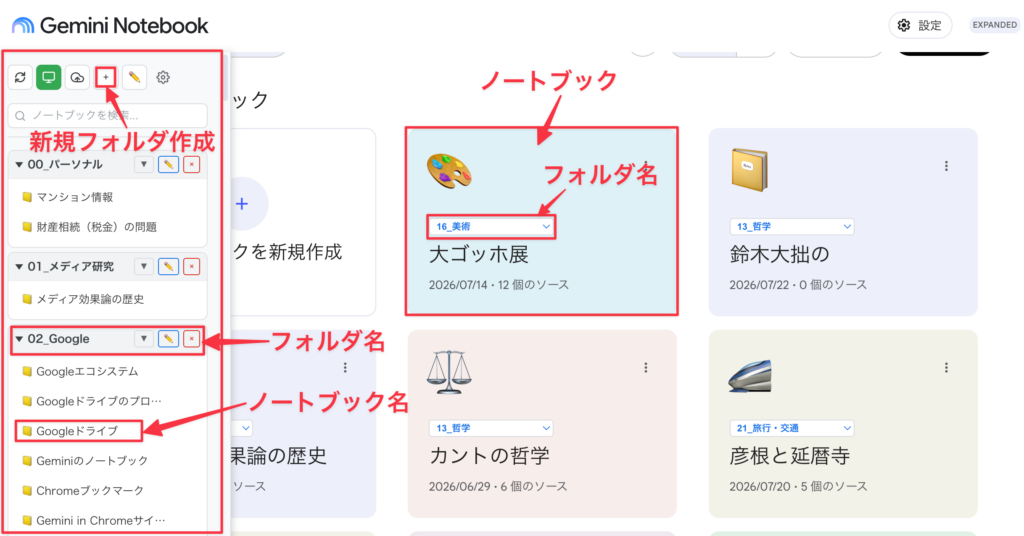
Geminiノートブックは、ノートブックを作成すると、画面上にノートブックがフラットに表示されますが、フォルダにまとめる機能はいまのところありません。このままだと、ノートブックの数がある程度増えると、必要なノートブックを探すのが難しくなります。Googleドライブのように、ファイルをフォルダに入れて整理する機能があると便利です。これを可能にするサードパーティ製のChrome拡張機能がいくつかあります。その中で一番使いやすいのは、「Bookshelf」(Bookshelf for NotebookLM)という拡張機能です。これを利用すると、フォルダ(Bookshelf)の作成やドラッグ&ドロップによる整理が可能になります。具体的な使い方は、次のとおりです。
1. 拡張機能のインストール
- Chrome ウェブストアを開き、「Bookshelf: Gemini Notebook用フォルダ管理」(または Bookshelf for Gemini Notebook)を検索します。
- 「Chrome に追加」 をクリックしてインストールします。
2. フォルダ(Bookshelf)の作成
- Chromeで Gemini Notebookのホーム画面を開きます。
- 拡張機能が有効化されると、画面左側に専用のサイドバーが表示されます。
- サイドバー内にある 「新規フォルダを作成(+ / Add Folder)」 ボタンをクリックします。
- 「仕事」「学習」「個人プロジェクト」など、任意のフォルダ名を入力して作成します。
3. ノートブックをフォルダへ整理する
- ドラッグ&ドロップ操作:ノートブックカードを掴み、作成したフォルダへドラッグ&ドロップすることで移動できます。
- 未分類(Uncategorized)の活用:まだフォルダに割り当てられていないノートブックは自動的に「Uncategorized」に振り分けられるため、ここから各フォルダへ振り分けます。
- サブフォルダの作成:フォルダ内にさらに階層構造(サブフォルダ)を作成することもできるため、深い整理が可能です。
4. 閲覧・ソート機能
- フォルダ別の絞り込み:左サイドバーで特定のフォルダをクリックすると、その中に含まれるノートブックのみが表示されます。
- 検索・ソート:拡張機能の検索バーやソート機能(作成順・名前順など)を使うことで、目的のノートブックを即座に見つけられます。
5. 利用時の注意点
・非公式のサードパーティ製機能です: Google公式の機能ではないため、NotebookLM本体のUIアップデートによって一時的に表示や動作が影響を受ける場合があります。
・データの保持形態: フォルダの振り分け情報(設定)はブラウザローカルストレージやクラウド同期(拡張機能の同期機能)で管理されます。Googleアカウント自体のノートブック情報が削除されるわけではありません。
第11章:デジタル化ツールの活用 スキャナ、スクショなど
11-1 : Googleドライブのスキャナの活用
Googleドライブのスマートフォンアプリ(iOS / Android)に搭載されているスキャン機能は、紙の書類や領収書、メモなどをスマホのカメラで撮影するだけで、きれいなPDFデータとして直接クラウドに保存できる非常に便利な機能です。
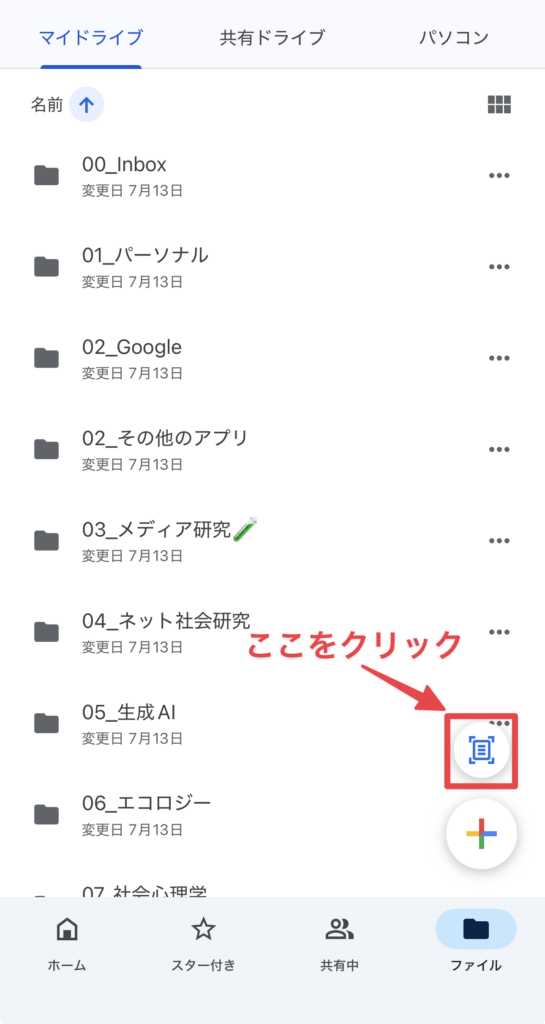
1. スキャン機能の基本操作手順
- アプリの起動とスキャン開始スマホでGoogleドライブアプリを開き、右下の 「+(作成)」ボタン をタップして 「スキャン」(またはカメラアイコン)を選択します。
- 書類の撮影書類にカメラを向けます。「自動撮影」モードではフレームに収まると自動でシャッターが切られます(手動撮影への切り替えも可能)。
- 編集と微調整
- 範囲調整: 端がずれている場合は切り抜きアイコンで調整。
- フィルター: カラーやモノクロなどの画質補正を選択。
- 回転・削除: ページの向き変更や不要なページの削除。
- ページの追加: 左下の「+」アイコンで次のページを連続スキャン。
- 保存右上の「保存」をタップし、ファイル名と保存先フォルダを指定して保存します。
2. 具体的な活用シーン
| 活用シーン | 具体的な利用方法 |
| 経費精算・領収書管理 | 出張先や店舗で受領した領収書をその場でスキャン。紙の紛失を防ぎ、確定申告や経理提出をスムーズにできます。 |
| 契約書・重要書類のアーカイブ | 家電の取扱説明書、契約書、医療の明細書などをペーパーレス化してクラウド保管。デスクまわりをすっきり保てます。 |
| ホワイトボード・会議メモの共有 | 会議後のホワイトボードや手書きノートを即座にPDF化し、チームメンバーへ共有できます。 |
| 学校・学習資料の整理 | 配布プリントやテキストの気になるページをデジタル化し、スマホやタブレットでいつでも復習可能にします。 |
11-2 : その他のスキャナの利用
(1) iPhoneのライブテキスト
iPhoneの「ライブテキスト(テキスト認識表示)」とは、写真や動画、あるいはカメラをかざしている画面に写っている「文字」を、AppleのAIが自動で認識してデータとして扱えるようにする機能です。
使い方は2通りあります。
① 「写真」アプリやスクリーンショットから使う
- 文字が写っている写真や画像を開く。
- 画像内の抽出したい文字を長押しする(カーソルが表示されて範囲指定が可能になります)。
- ポップアップメニューから 「コピー」「翻訳」「調べる」 などを選択。
② 「カメラ」アプリでリアルタイムに使う
- カメラを起動し、文字が書かれている対象物に向ける。
- 認識されると画面右下に 「テキストマーク」 アイコンが表示されるのでタップ。
- 画面が静止し、画面上の文字を直接タップ・選択してコピーや翻訳ができるようになります。
(2)ドキュメントスキャナ
PFUのドキュメントスキャナー「ScanSnap(スキャンスナップ)」シリーズを使って、文書をPDFファイルとして保存・変換することができます。
パソコンを使った最も標準的なスキャン・PDF保存の流れです。
1.スキャナーに原稿をセットする:
読み取りたい文書の向きをそろえ、給紙トレイにセットします(複数枚まとめてセット可能)。
2.スキャン画面を開く:
PCで「ScanSnap Home」を起動し、左上の [スキャン画面を開く](またはスキャンボタン)をクリックします。
3.保存形式(PDF)を確認・変更する:
プロファイル一覧(例: 「フォルダに保存」や「文書」など)を選択します。
- PDF形式の確認: ファイル形式が「PDF」になっているか確認します。
- 複数枚を1つのPDFにまとめる場合: [プロファイル編集](歯車マーク)>「ファイル形式」で 「PDF(単一)」 または「すべての用紙を1つのPDFファイルにします」が選ばれていることを確認して保存します。
4.スキャンを実行する:
スキャナー本体の[Scan]ボタン、または画面上の[スキャン]ボタンを押します。読み取りが開始されます。
5.保存先とファイル名を確認する:
スキャンが完了すると設定されたフォルダ(初期設定では「ドキュメント」内のScanSnapフォルダなど)にPDFファイルとして保存されます。
11-3 : 著作権上問題のないデジタルソースの利用
生成AI(ChatGPTやClaude、Geminiなど)に入力(プロンプトや画像・ファイルの添付など)を行う際、「著作権上問題が発生しない(または極めてリスクが低い)デジタル情報」には、大きく分けて5つのカテゴリがあります。
1. 著作権上、問題なく入力できる素材カテゴリ
(1) 自身が完全に権利を保有している情報
- 自作の文章・論文・コード・イラスト・写真
- 自社で作成した社内文書、マニュアル、自社データ
💡 注意点: 入力したデータが「AIの再学習(トレーニング)」に利用される設定(デフォルトでONになっているサービスが多い)になっていると、情報漏洩(秘密保持違反)のリスクが生じます。商用利用時は「学習に利用しない(Opt-out / API利用 / Enterpriseプラン)」設定になっているか必ず確認しましょう
(2) 著作権の保護期間が満了した情報(パブリックドメイン)
著作権は原則として作者の死後70年で消滅し、社会的共有財産(パブリックドメイン)となります。
- 古典文学・歴史的文書(例: 夏目漱石や太宰治の小説、シェイクスピアの戯曲など)
- 青空文庫に掲載されている作品(著作権切れのもの)
- 歴史的な絵画・パブリックドメインの画像データ(例: パブリックドメイン化された浮世絵、名画のデジタルデータ)
(3) 著作権を明示的に放棄・許諾している素材(CC0など)
作者が「自由に使ってよい」と権利を放棄または寛容なライセンスを付与しているデータです。
- CC0(クリエイティブ・コモンズ・ゼロ) が付与された画像・テキスト・データ
- パブリックドメイン提供サイトの素材(例: Unsplashの一部無料素材、Pixabay、Gutenbergプロジェクトなど)
💡 注意点: サイトの規約(利用規約)で「AIへの入力・学習の禁止」が別途定められているケースがあるため、ライセンスだけでなく利用規約(Terms of Use)も念のため確認が必要です。
(4) 著作権の対象とならない情報(事実・データ・アイデアなど)
著作権法で保護されるのは「思想または感情を創作的に表現したもの」です。単なる事実やデータそのものには著作権が発生しません。
- 客観的な統計データ・数値・気象データ・株価
- 公知の事実、ニュースの事実部分(※報道記事の「文章そのもの」をコピー&ペーストすると表現の著作権に触れるため、事実の箇条書きデータ等に変換して入力するのが安全です)
- 法令・判例・官公庁の告示(著作権法第13条により、権利の対象外とされています)
(5) 権利者から「AIへの入力・利用」の許諾を得ている情報
- 契約・ライセンス上、AIへの読み込みや商用利用が明示的に認められているデータセットや素材。
2. 日本の著作権法(第30条の4)と「入力」に関する重要なポイント
日本の著作権法第30条の4では、「情報解析(AI学習やデータ分析など)」を目的とする場合、原則として著作権者の許諾なく著作物を利用できると定められています。
ただし、ユーザーが日常的に生成AIを使うにあたっては、以下のケースで例外的に著作権侵害(享受目的の併存)とみなされるリスクがあるため注意が必要です。
🚨 入力時にリスクとなるNGパターン
- 「既存の特定の作品とそっくりなものを作らせる目的」での入力(例: 有名クリエイターのイラストをそのまま読み込ませて「これと同じタッチで別の絵を描いて」と指示する行為)
- 海賊版や違法アップロードされたデータと知りながら入力・解析させる行為
- AI学習・解析を禁止する技術的保護(または明確な利用規約のオーバーライド)が施された有料データを回避して入力する行為
3. 安全に生成AIへ入力するためのチェックリスト
- ☑️ 自社・自身のオリジナル情報か?(他人の著作物が混ざっていないか)
- ☑️ 入力設定で「データ学習(Training)オフ」になっているか?(機密情報や個人情報の場合)
- ☑️ 他人の作品を入力する場合、トレースや模倣(依拠性のある出力)を目的にしていないか?
- ☑️ 利用する画像・文章サイトの「AI利用に関する規約」に反していないか?
要約すると、「自作のデータ」「パブリックドメイン(著作権切れ)」「事実・数値データのみ」を入力するのが最も確実で安全な方法です。他人の著作物を入力する場合は、「分析や要約などの情報処理目的」にとどめ、類似物を生成させない使い方の範囲内で活用しましょう。
11-4 : スクリーンショット(スクショ)や画像の活用
生成AIのソースとして、スクリーンショット(スクショ)や写真などの画像ファイルを指定することによって、リサーチの範囲を著しく広げ、より広く深い知識を生成してもらうことが可能になります。例えば、下の写真は、最近筆者が小石川植物園で撮った1枚の写真です。
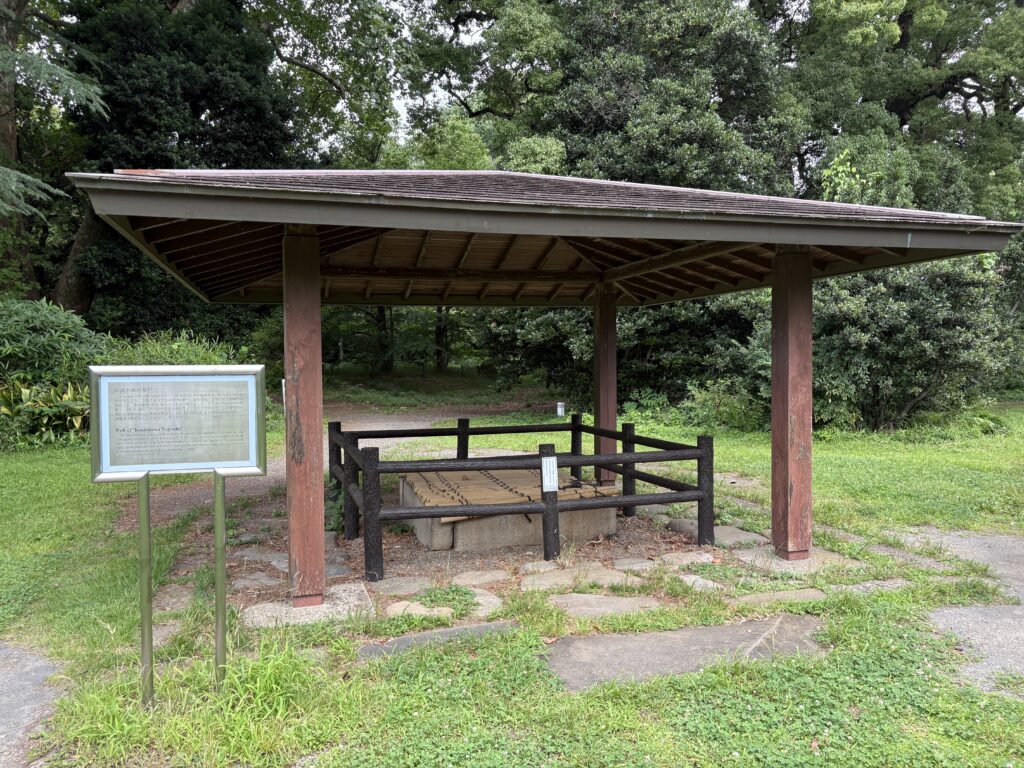
Geminiのプロンプト欄にこの写真を挿入し、「この写真について説明してください」と入れるだけで、次のような的確な回答が返ってきます。
「この写真は、小石川植物園(東京都文京区)の敷地内にある「旧小石川養生所の井戸」を写したものです。
📸 写真に写っている内容
- 屋根と柵で保護された井戸(中央)
- 木造の屋根の下に、木製の低い柵で囲まれた井戸の枠(井桁)が見えます。
- 安全のため、井戸の上には竹で編んだ蓋(スノコ)が設置されています。
- 解説板(手前左)
- この場所が歴史的にどういった施設であったかを示す看板が設置されています。
💡 この場所の歴史(小石川養生所とは?)
江戸時代(享保7年・1722年)、徳川第8代将軍・徳川吉宗の時代に設置された貧民のための施療施設(無料の病院)が「小石川養生所」です。
- 誕生のきっかけ:町医師の小川笙船(おがわ しょうせん)が、吉宗が設置した「目安箱」に「困窮して医療を受けられない人々を救うための医療施設をつくってほしい」と投書したことがきっかけで開設されました。
- 名作小説の舞台:山本周五郎の小説『赤ひげ診療譚』や、それを原作とした黒澤明監督の映画『赤ひげ』の舞台としても非常に有名です。
この井戸は、当時養生所で使われていたもので、大正時代に関東大震災が起きた際にも飲料水として地域の人々を救ったと伝えられています。」(以上、Geminiによる回答)
このような画像だけをソースとした生成AIのリサーチで、これだけ詳細で正確なテキスト解説を生成してもらえることから、写真集や旅行ガイドブックの作成、編集においても大いに活躍してもらえるはずです。もちろん、説明内容の妥当性については、他の信頼できる情報源によるチェックが必要ですが。
11-5 : 外国語ソースの活用
生成AIによるインプット革命として、ぜひ指摘しておかなければならない最後の点は、「外国語ソース」の活用です。私たちがふだん利用するウェブ上の情報ソースの9割以上は、日本語ではなく、外国語で書かれたものです。これまでは、日本語以外のウェブ情報を理解するには、一定以上の語学力か翻訳ツールの助けが必要でした。けれども、生成AIは地球上のあらゆる言語を学習し、理解すことができるので、外国語のウェブソースを提示しても、それをすぐに理解して、的確な回答を提示してくれます。これは、まさに従来の検索では不可能だった「インプット革命」ということができます。
具体的な活用事例は、第17章で詳しく取り上げることにしたいと思います。
第5部:KM法2.0によるアウトプット革命
第12章:進行するアウトプット革命
生成AIによる「アウトプット革命」とは、従来のAIがデータの分析や分類(インプットの処理)を得意としていたのに対し、「文章、画像、コード、音声解説、スライド、動画といった具体的な成果物(アウトプット)を人間と同等以上のクオリティで一瞬にして生み出せるようになった、知的生産の革新」を指します。
単なる「作業の効率化」にとどまらず、個人の創造性(クリエイティビティ)の爆発や仕事のプロセスの根本的な変化を全面的にアシストしてくれる点が「革命」と呼ばれる理由です。
具体的には、以下のような変化が起こっています。
12-1 : AIを、アイディアを膨らますための相談相手とみなして対話する「壁打ち」
これまで企画書、デザイン、プログラミング、執筆など一人だけで取り組んでいた「最初の1歩(たたき台を作る)」に相談相手や思考の伴走者としてAIを加えることにより、作業の大幅な効率アップを図ることできます。
- 変化:AIに大まかなテーマや条件を投げるだけで、数秒で「70点レベルの初稿」や多角的なアイデアが完成します。人間はゼロから作る人(作業者)から、出てきたものを評価・修正する「編集者(ディレクター)」へと役割が変わります。
- ただし、重要なことは、AIにアイディア生成を「丸投げ」してはいけないということです。それだと、製作者の個性や独創性が反映されなくなり、無味乾燥なAI特有の無難で面白みのないアイディアだけしか出なくなるからです。
- 壁打ち:AIとの「壁打ち」とは、自分の断片的な思いつきやメモを投げかけることで、AIが整理して構造化してくれたり、複数の論点を提示してくれたりすることを言います。これまで一人で悩んでいた何時間もの時間が、数分の対話(壁打ち)で解決するようになります。
- 追加リクエストを繰り返すことで、自分の望む回答に近づけていくことができます。
12-2 : スキルの民主化(専門スキルの壁が消滅)
専門的な教育や長年の訓練が必要だったスキルが、プロンプト(指示文)1つで誰でも扱えるようになりました。
- デザイン・イラスト:絵が描けない人でも、頭の中のイメージを言葉で入力するだけでプロ級の画像を生成できます。
- プログラミング:コードが書けない非エンジニアでも、自然言語(日本語)で指示を出してアプリや自動化ツールを作成できます。
- 多言語発信:外国語が話せなくても、自分の声やニュアンスを保ったまま自然な多言語動画を作成・発信できます。
- スライドの作成:スライド作成が苦手な人でも、Nano BananaやGemini ノートブックを使えば、10枚以上の美しいスライドを短時間で作成できます。
12-3 : 制作の高速フィードバックループ
従来は「アイデア検討 → 試作(プロトタイプ) → テスト → 修正」に数日〜数週間かかっていたサイクルが、AIによって数分レベルに短縮されました。
- 10パターンのキャッチコピーや、5パターンのデザイン案、5種類の企画書案などを一瞬で生成してテストできるため、圧倒的な試行回数(数)によって質を一気に高めることができるようになりました。
一言でまとめると、これまでは「高度のスキルや豊富な時間を持っている人」しか質の高いアウトプットを出せませんでしたが、生成AIのアウトプット革命によって「どんな問いやアイデアを(プロンプトの形で)投げかけることができるか」が最も重要な時代へと変化しました。
▶︎ 次のページ:第13章:GoogleドライブとAIの連携
第13章:GoogleドライブとAIの連携
これまでGoogleドライブは、書類やデータを溜め込んでおく「データ保管庫(倉庫)」や「アーカイブ」という側面が強かったはずです。
しかし、Gemini(およびNotebook)と連携させることで、ドライブ内の情報をAIが直接読み込み、整理し、瞬時に新しいアウトプットを生み出す「ナレッジ駆動型のクリエイティブ・ラボ」へと進化します。
Googleドライブを「アウトプットのツール」に変える具体的な3つの仕組みと活用フローを解説します。
13-1 : なぜ「アウトプットのツール」に化けるのか?
- 手入力・コピペの手間がゼロになる:Googleドライブ上のドキュメント、スプレッドシート、スライド、PDF、音声などを直接ソース(参照データ)としてAIに取り込めます。
- 情報の自動同期:Googleドライブのファイルを更新すると、連携されたノートブック側の情報も最新状態に自動更新されるため、常に最新データで作業できます。
- ハルシネーション(嘘)の抑制:「Googleドライブ内にある情報」だけに厳密に基づいて回答させることができるため、正確な資料作成やリサーチが可能です。
13-2 : 具体的なアウトプットへの変革プロセス(3ステップ)
STEP 1:ドライブを「素材置き場」にする
まずは、プロジェクトごと・テーマごとに過去の資料やメモをドライブのフォルダに保存します。
- 過去の記事、論文、企画書、AIのリサーチ結果、その他の資料(Googleドキュメント / PDF)
- 議事録やアイデアメモ(テキスト)
- アンケート結果、統計・調査データ(Googleスプレッドシート)
STEP 2:Geminiノートブックに読み込ませる
GeminiのサイドバーやGemini Notebookからノートブックを作成し、ソースとして上記Googleドライブ内のファイルやフォルダを指定・連携します。これでAIがあなたの「専属アシスタント」として資料を完全に暗記した状態になります。
STEP 3:プロンプトで「アウトプット」に変換する
素材が集まったら、あとはGeminiまたはGemini Notebookに指示を出して一気にアウトプットへ変換します。
13-3 : 今すぐ使える「アウトプット変換」の具体例
1. 【過去の資料 ➔ 新しい企画書、論文記事】
- ドライブ内の素材:過去の類似プロジェクトの提案書、クライアントとの議事録
- Geminiへの指示:「ドライブの資料を分析、要約し、執筆中の記事草稿を作成して」
2. 【大量のデータ・レポート ➔ プレゼン用スライド構成】
- ドライブ内の素材:アンケート調査データ(CSV)、政党支持率データのスプレッドシート
- Geminiへの指示:「指定した2つのデータから主要なトレンドを3つ抽出して。それをGoogleスライドの10ページのプレゼン構成(各スライドのタイトルと話す内容の箇条書き)に落とし込んで。」
3. 【未整理のメモ・音声 ➔ 記事・メルマガ・FAQ】
- ドライブ内の素材:インタビューの文字起こしデータや録音ファイル
- Geminiへの指示:「この文字起こしメモから重要なポイントを要約し、顧客向けのWeb記事(2000文字程度)の初稿を作成して。トーンは親しみやすい口調で。」
13-4 : さらに生産性を上げるアウトプット機能
- 音声/動画オーバービュー(Audio/Video Overviews)の作成
- ノートブックに取り込んだ資料(PDFやドキュメント)をもとに、AIホスト2人が対話形式で内容を分かりやすく解説してくれる「ポッドキャスト風の音声番組」や「動画要約」を生成できます。通勤中の情報収集や、チームへの手軽な共有ツールとして最適です。詳しくは14章で説明します。
- ワンクリックでGoogleドキュメント・スライド化
- Geminiとのチャットで作成したアウトプット(文章や構成案)は、画面下の出力ボタンからワンクリックで新しいGoogleドキュメントやスライドとしてドライブ内に保存・エクスポートできます。
まとめ
「自分で1から文章を書く」のをやめて、「Googleドライブに素材を放り込んでおき、必要なときにGemini (Notebook)を使ってアウトプットに変換する」というスタイルに変えるだけで、資料作成やコンテンツづくりのスピードは数倍に跳ね上がります。
第14章:Geminiによるアウトプット革命
14-1 : Chatの使い方
パソコンで使う場合
- Webブラウザで gemini.google.com にアクセスします。
- お使いの Googleアカウント でログインします。
スマホで使う場合
- Android: 「Gemini」アプリを起動(またはGoogleアシスタント経由)。
- iPhone (iOS): App Storeから「Google Gemini」アプリをダウンロードしてログイン。
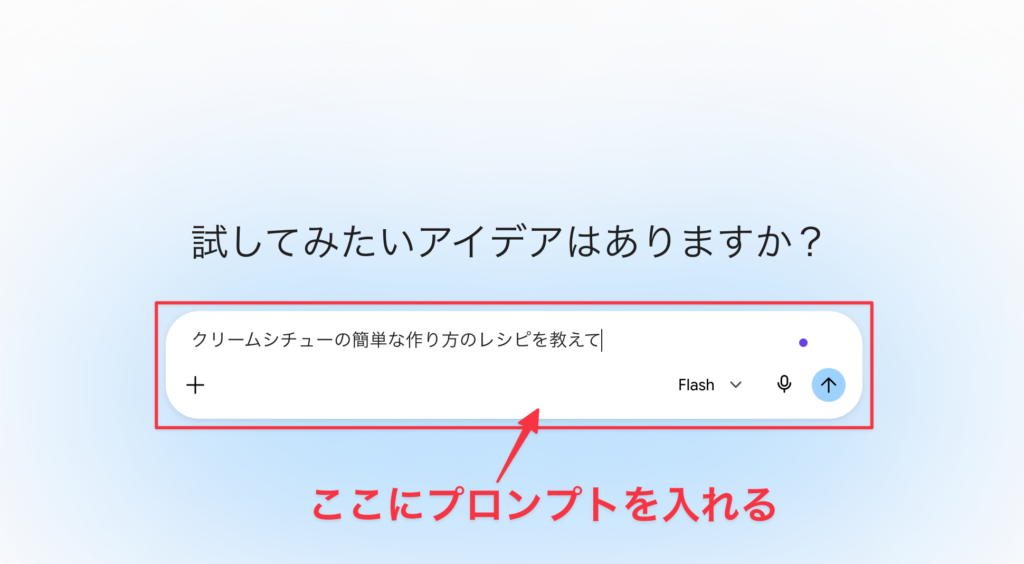
Geminiに質問、指示する
入力欄に話しかけたい内容を入力し、送信ボタン(紙飛行機マークやEnterキー)を押します。
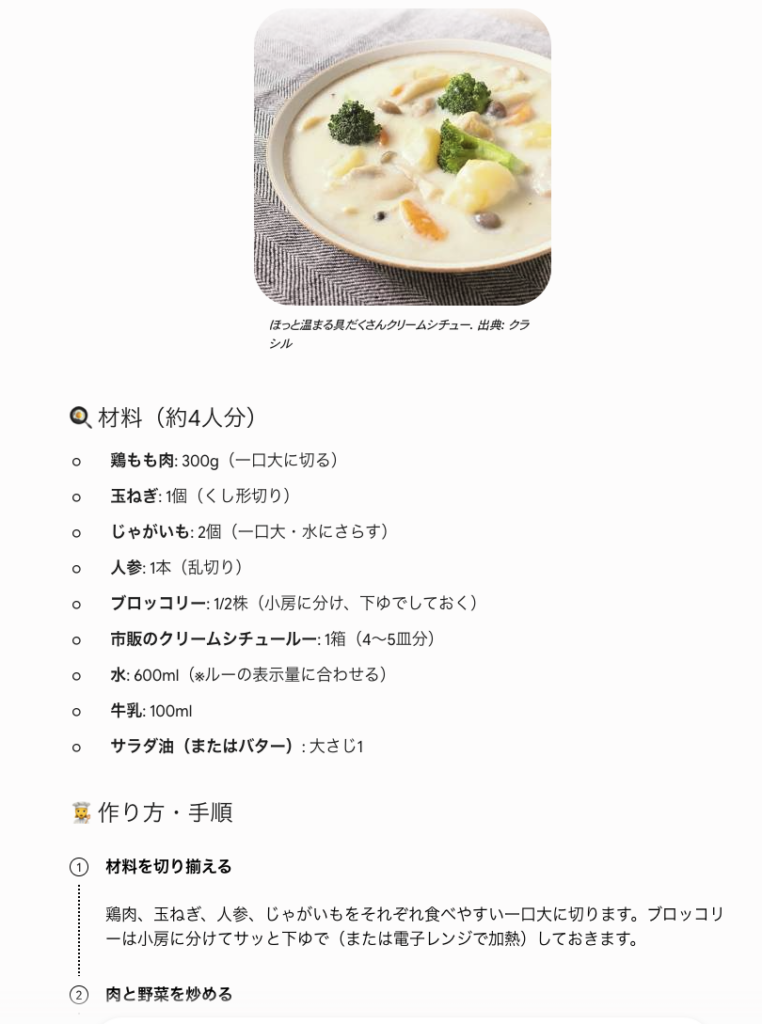
例えば、「クリームシチューの簡単な作り方のレシピを教えて」という質問を投げると、下のような写真入りのレシピ(材料と作り方)が出力されます。
14 -2 : ファイルの読み込み
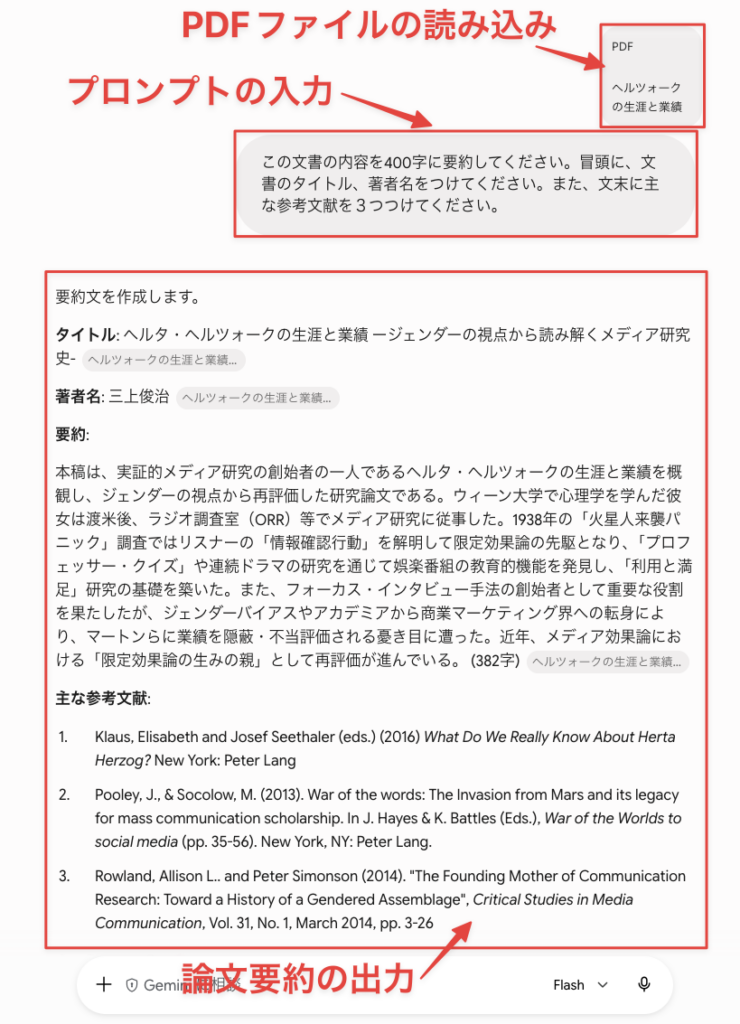
入力欄の左にある「+」アイコン(または画像・カメラマーク)から、画像・PDF・各種書類をアップロードして「これを要約して」「画像に写っているものを教えて」と頼むこともできます。
例として、筆者が書いた論文のPDFファイルをGeminiに読み込ませて、400字で要約してもらいました。プロンプト、出力結果は下図の通りです。
14-3 : Deep Researchの利用
Gemini Deep Researchは、Geminiがユーザーに代わってWeb上の膨大な情報や所有データを何百件も自動検索・集計し、高度な分析レポートを一括で作成してくれる機能です。
通常のチャットのように「一言で答える」のではなく、自律して「調査計画の作成 → 複数ソースの検索・集計 → 分析・考察 → 根拠リンク付きレポートの作成」という本格的なリサーチ手順を踏んでくれるのが最大の特徴です。
通常のチャット式Geminiとの違いをまとめると、次のようになります。
| 比較項目 | 通常のGeminiチャット | Deep Research |
| 用途 | 単発の質問、文章作成、アイデア出し | 複雑な市場調査、競合分析、総合レポート |
| 情報収集 | 1〜数回の検索で答えを要約 | 複数サイトやデータを横断・巡回して網羅的に集計 |
| 処理時間 | 数秒 | 数分〜10分程度(じっくり調査するため) |
| 出力形式 | 短い回答テキスト | 目次・根拠リンク付きの構造化された長文レポート |
調査・研究論文、レポートの作成に適しています。ここでは、公表されている各種統計データを分析し、レポートにまとめてもらうという事例、および、選挙期間中の誹謗中傷動画の拡散が世論と選挙結果に及ぼす影響を論文にまとめてもらうという事例を取り上げたいと思います。
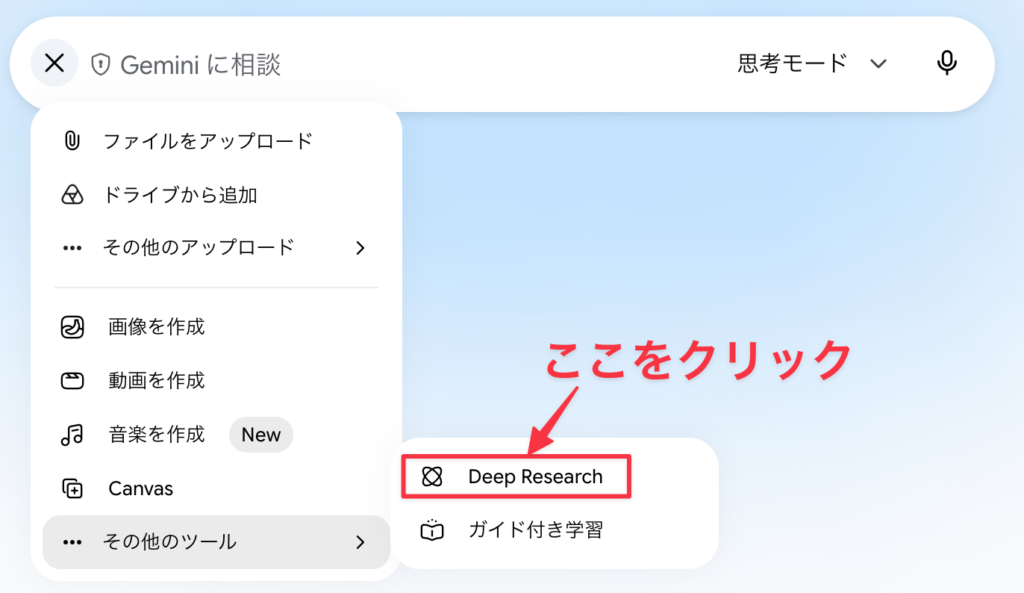
事例1:「過去5年間の都内の新築マンションの平均価格の推移を調査し、レポートにまとめてください」というプロンプトでDeep Researchを行なってもらいました。Deep Researchの入力画面は、Geminiの左の+をクリックして、メニューの一番下の「その他のツール」をクリックすると、右側にDeep Researchというメニューが表示されますから、ここをクリックして、入力欄にプロンプトを入れて実行します。
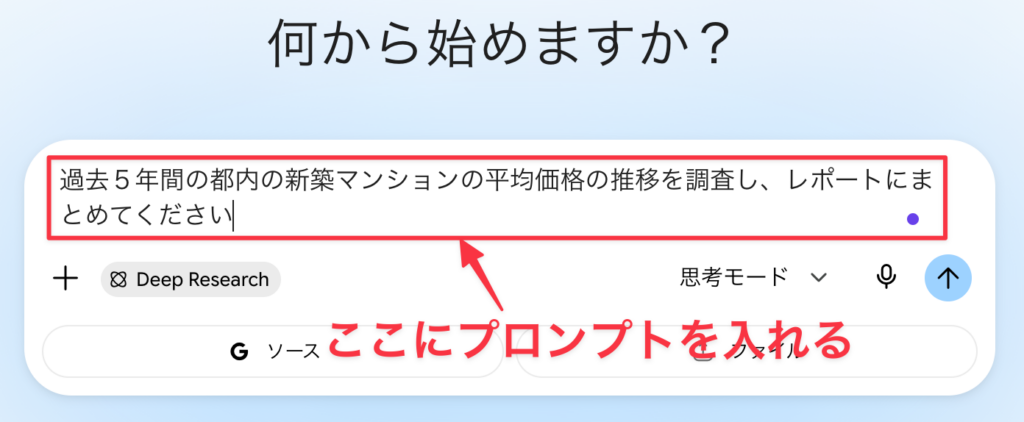
すると、「東京都内における新築分譲マンション平均価格の変動分析:過去5年間の市場構造変化と価格形成要因」というテーマでDeep Researchの調査が始まります。公表されているデータをもとに、年次別・地域別の詳細価格動向分析を行い、次のようなレポートをまとめてくれました。
タイトル:価格高騰を牽引する複合的要因と構造的メカニズム
- コスト押し上げ要因の常態化と売上原価の上昇
不動産開発における主要コストである「用地費」「建築資材費」「人件費」の3要素が同時に高騰した。都心部における好立地の用地獲得競争は極めて激しく、用地仕入れ価格の上昇が続いた。これに加え、サプライチェーンの混乱や世界的なインフレによる資材価格の上昇、さらに「2024年問題」に代表される建設業界の労働力不足に伴う人件費の上昇が、建築坪単価を大幅に押し上げた。これらは売上原価の絶対的な下限を引き上げるため、デベロッパーは販売価格を高く設定せざるを得ない構造が形成された。
2. 供給戸数の絞り込みとデベロッパーの事業戦略転換
デベロッパー側は、無理な供給拡大を避け、事業期間を長期間に設定しながら利益率の高い高価格帯物件を慎重に供給する「棚卸資産の長期化・高付加価値化戦略」へと舵を切った。2021年に3万3,636戸であった首都圏発売戸数が2025年には2万1,962戸にまで減少したことは、市場における新築物件の稀少価値を極限まで高める結果となった。需要が供給を大幅に上回る需給ギャップが継続したことが、価格高止まりを強固に支えた。
3. 購買層の変容と需要構造の再編
過去5年間における価格急騰は、新築マンションの主たる購入層に不可逆的な変容をもたらした。従来の平均的な単有年収を有する会社員層は、都内主要部の新築相場から実質的に押し出される格差拡大が生じた。これに代わり市場の旺盛な需要を支えているのは、世帯年収1,500万円から2,000万円を超えるパワーカップル(高所得共働き世帯)、資産インフレを背景とした買い替え層や事業オーナー層、ならびに歴史的な円安傾向を追い風とした海外個人・法人投資家である。世帯年収の高いパワーカップル層は、主として都心の周辺区や都下主要駅至近の1億円前後の住戸を選択する一方で、超都心の2億円超から数十億円規模の超高額住戸市場では、実需を超えた資産保全やインバウンド投資資本が取引を牽引している。この購買動向の分離は、単なる住宅供給の領域を超え、都心不動産が国際的な流動性資産としての性格を強めている現象を浮き彫りにしている。
(中略)
結論
過去5年間の東京都内における新築分譲マンション平均価格の変動を振り返ると、市場は2021年の「コロナ禍後の需給引き締まりと過去最高値更新」から始まり、2023年の「超都心・超高額物件主導の1億円突破」、そして2025年の「建設コスト高騰の波及による全般的な価格底上げと1億円台の定着」という3つのフェーズを経て進化してきた。
東京23区の平均価格が1億3,000万円台に達し、中央値においても1億1,000万円を超えた現状は、都心部の居住用不動産が一般的な一次取得者の実需商品から、高所得層および資産運用主体のためのアセットへと変質したことを物語っている。今後は、日銀による利上げに伴う住宅ローン金利の上昇が実需層の購買力を一定程度抑制すると予想されるものの、供給量の絶対的な不足と建築コストの高止まりが下値を強力に支えるため、大幅な価格暴落が起こる可能性は低い。
都内における新築マンション市場は、金利上昇に伴う需要の選別が進む中で、「立地利便性と資産性が極めて高い超高額物件」と「郊外・都下の実需向け適正規模物件」への二極化をさらに深化させながら、高値水準を維持する構造へと移行していくものと見込まれる。
事例2:国政の期間中におけるSNS上の中傷誹謗動画の大量拡散が世論を歪め、選挙結果に大きな影響を与える可能性を指摘した研究論文や調査レポートをまとめてください。
Deep Researchは、この研究テーマに関連する最近の内外の実証研究データを収集し、それらを集約して、論文の形態にまとめています。アウトプットの分量が大きいので、PDFの形で示しておきます。本テーマは最近急激に研究課題として浮上してきたものだけに、論文形式での公式データが少ないので、本リサーチ結果は、一つの情報源として貴重なものと言えるでしょう。また、レポートには、引用元の出典がURLで明記されているので、文献探索の手掛かりとしても有益です。
14-4 : Nano Bananaによる画像生成
(1) Nano Banana Proの登場
2025年11月にGoogleから発表された画像生成AIモデル「Nano Banana Pro」(Gemini 3 Pro Imageベース)は、従来の画像生成AIが抱えていた大きな課題を一挙に解決し、特に実務・ビジネス現場におけるクリエイティブ制作のあり方を一変させたました。
1. 日本語・多言語タイポグラフィの正確なレンダリングが可能になった
2. 最大14枚の参照画像による「キャラクター・ブランドの一貫性」(同一キャラクターの維持)を実現した
3. 検索機能(グラウンディング)と連携したことで、単なる写真風・絵画風の美しさだけでなく、現実の正確な事実に基づいた視覚表現が可能になった
4. 会話型・自然言語による精密な部分修正(インペインティング)が可能になった
5. 商業利用に耐えうる「4K高画質」と「SynthID(ウォーターマーク)」が実装された
これによって、商業利用に耐えるプロ品質の画像を生成AIで短時間で作成することが可能になりました。以下では、実例を交えながら、Nano Banana Proの基本的な使い方を解説します。
(2) Geminiチャットで画像生成
Nano banana proの画像生成は、Geminiのチャット画面で行うのが基本です。その手順は次のとおり。
ステップ 1: ツールとモードを選択する
- 入力欄のツールメニュー(または「🍌」アイコン)から 「画像を作成 / Create images」 を選択します。
- モデル選択メニューで 「思考(Thinking / Pro)」 を選んでください。(※「高速(Fast)」を選択すると通常版モードになります)
ステップ 2: プロンプト(指示文)を入力する
作りたいイメージを文章で入力します。日本語での指示にも対応しています。一例を挙げます。
理想通りの画像を出すプロンプト(指示文)のコツ
Nano Banana Pro でクオリティを高めるには、SCALIST構文(要素に分解して伝える指示方法)を意識すると効果的です。
| 要素 | 指定内容の例 |
| 被写体 (Subject) | 「茶髪ウェーブの女性、黒のタートルネック」 |
| 場所・背景 (Location) | 「朝日が差し込む北欧風のカフェ店内」 |
| 構図・アングル (Composition) | 「ローアングル」「正面のクローズアップ」「16:9のアスペクト比」 |
| 動き・状況 (Action) | 「コーヒーカップを両手で持って優しく微笑んでいる」 |
| スタイル (Style) | 「85mmレンズで撮影した写真風」「水彩画調」「3Dフィギュア風」 |
| 文字 (Text) | 「画像上部に『COFFEE TIME』と太字で入れる」 |
実際に、次のようなプロンプトを入れて、Nano Banana Proを実行してもらいました。
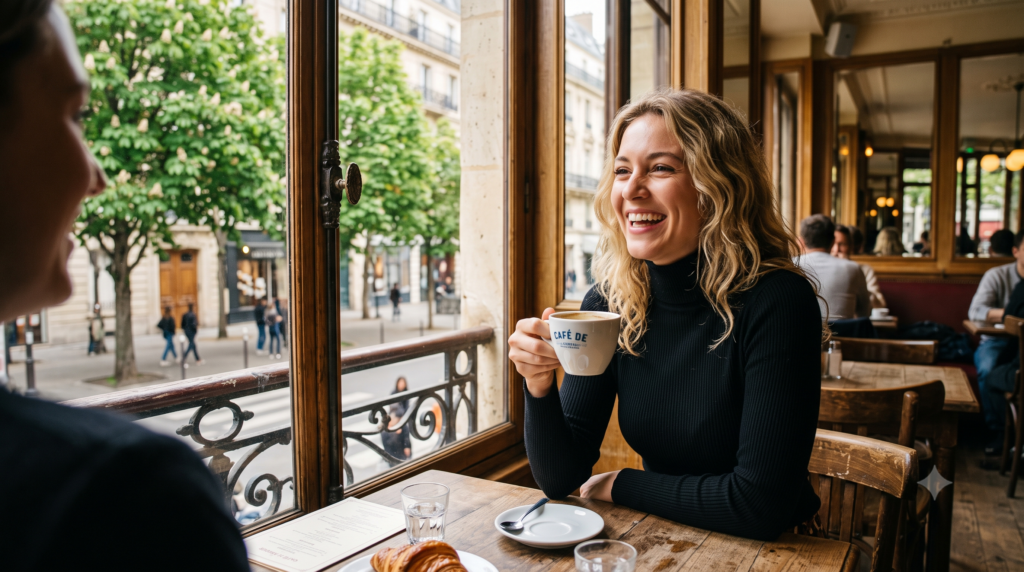
「次のような条件で画像を生成してください:
被写体 (Subject)「金髪ウェーブのフランス人女性、黒のタートルネック」
場所・背景 (Location)「外にマロニエの街路樹が見えるパリのカフェの窓際の席」
構図・アングル (Composition)「ローアングル」「斜め正面から撮影した」「16:9のアスペクト比」
動き・状況 (Action)「コーヒーカップを手に、優しく微笑みながら楽しそうに話している」
すると、次のような画像が生成されました。ほぼ指示通りの結果と言えます。
(3) 日本語やマイナーな外国語の文字化けを防ぐ方法
これまでの画像生成AIは「画像内に正しい文字を描画すること」を苦手としており、特に日本語などの複雑な文字は崩れるのが常でした。Nano Banana Proではテキストレンダリング精度が飛躍的に向上し、以下のような文字入り画像を一発で破綻なく生成できるようになりました(バナーやWeb広告のキャッチコピーポスターやパッケージデザイン UI、モックアップなどのスクリーンショットやラベル表記)。
文字を崩さず意図通りのバナーやポスターを作るためのプロンプトの記述手順とコツは以下の通りです。
1. 日本語文字生成の「黄金プロンプト構造」
プロンプトは以下の4要素を明確に分ける構文(構造化テキスト)で書くのが最も成功率が高くなります。
【1. デザイン構図・スタイル】
新商品の清涼飲料水のポスター。夏らしく爽やかで透明感のある背景。

【2. 配置・タイポグラフィ指定】
中央上部に大きな太字のゴシック体でメインコピーを配置。
右下に少し小さめの明朝体でサブコピーを配置。

【3. 描画するテキスト(ダブルクォーテーションで指定)】
メインテキスト: "極上のキレと清涼感"
サブテキスト: "新発売・期間限定"

【4. フォントとカラーの指定】
文字色: メインは白(青い影付き)、サブは黄色。
生成例:上のルールを参考にして、Nano Banana Proにプロンプトを入力して、広告バナーを作成してみました。
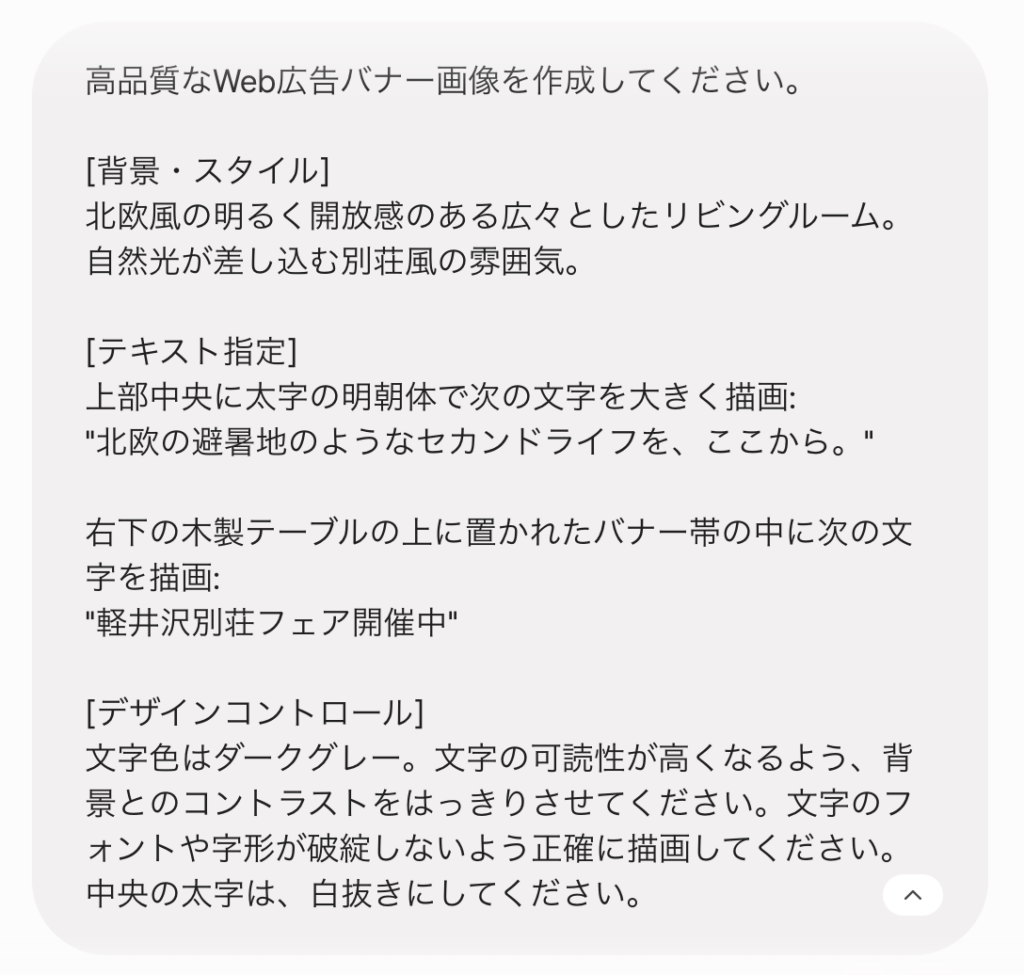
プロンプトの実行
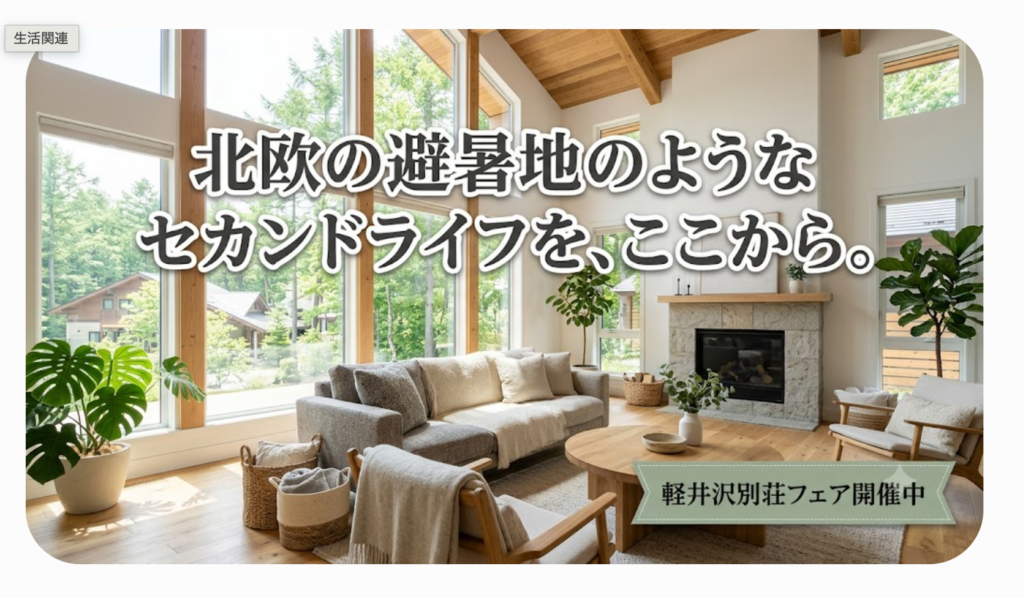
Nano Banana Proで生成されたバナー広告の画像
2. 文字精度を激変させる5つのコツ
① 文字列は必ず "" (二重引用符)で囲む
AIに「どこからどこまでが画像内に直接描くテキストか」を明確に伝えるため、印字したい文字列は必ず "文字列" のようにダブルクォーテーションで囲みます。
- NG: メインコピーは極上のキレと清涼感にしてください
- OK: メインコピーとして
"極上のキレと清涼感"と描画する
② 文字数を絞る(文字数は少なければ少ないほど安定)
Nano Banana Proは長文も描画できますが、文字数が少ないほど配置やフォントの再現度が向上します。
- バナーのメインキャッチは 10文字〜15文字程度 に抑えるのがベストです。
③ フォントの種類や雰囲気を具体的に指示する
「文字を書いて」だけではなく、フォントの属性を添えると文字のグラフィック的品質が上がります。
- フォント指定例:
太字のモダンなゴシック体,高級感のある明朝体,手書き風のポップな丸ゴシック,筆文字風の和風タイポグラフィ
④ テキストの配置場所を限定する
文字と背景画像が重なって文字が読みにくくなるのを防ぐため、文字を描く背景エリア(可読性)も指示します。
- 例:
上部の余白スペースに文字を配置,文字の背後に半透明のネイビーの帯を敷く,文字がくっきり浮き出るように背景を少し暗くする
⑤ チャット機能による「対話型の後修正」を活用する
一発生成で文字の一部が崩れたり間違えたりした場合でも、最初から生成し直す必要はありません。Nano Banana Proの強力なインペインティング(会話型部分修正)機能を利用します。
- 修正指示例:「中央の文字の『清』の字が少し崩れています。『極上のキレと清涼感』という文字だけを正しい日本語表記に修正してください。」
参考:
もし「どうしても漢字の一部が崩れる」という現象が起きる場合は、まずプロンプトを英語でベース(構図・スタイル)を書き、テキストの描画部分のみ
Japanese text "〇〇"と指定すると、英語の背景理解力と日本語レンダリングの双方が最も高いパフォーマンスを発揮します。
(4) キャラクターの一貫性を保つ画像生成
Nano Banana Proでは、一枚の参照画像(人物写真や似顔絵など)をアップロードしておくと、それに続く画像生成においても、同じキャラクターや人物の一貫性(アイデンティティ)を保った画像を自動生成してくれます。ストーリー性の高い漫画や小説、短編ドラマなどを制作するときに便利です。
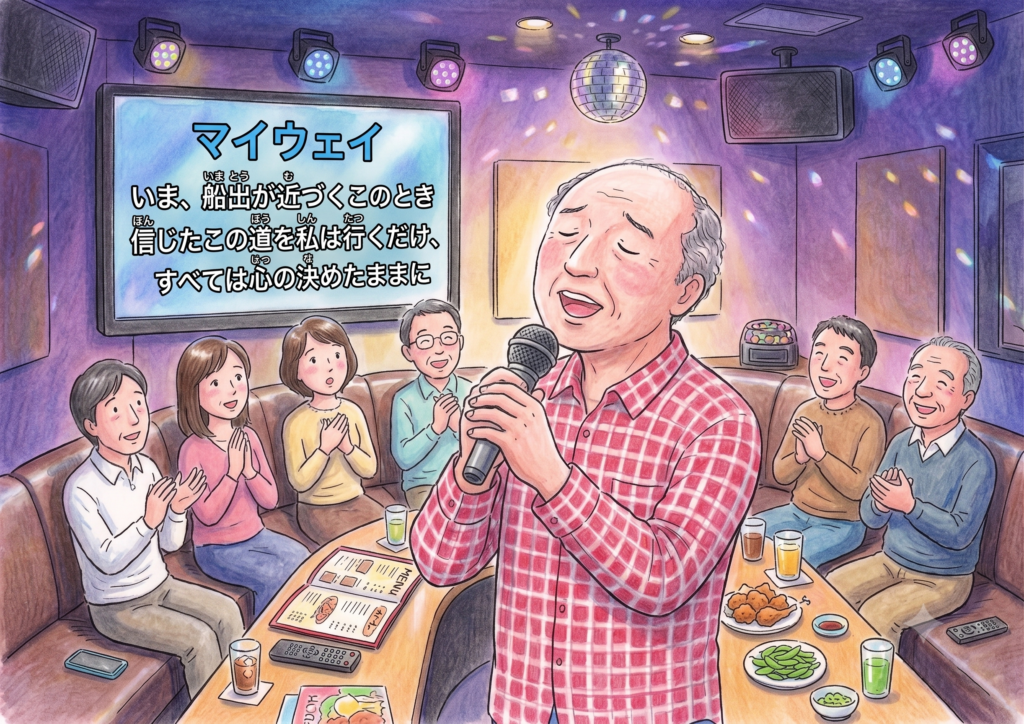
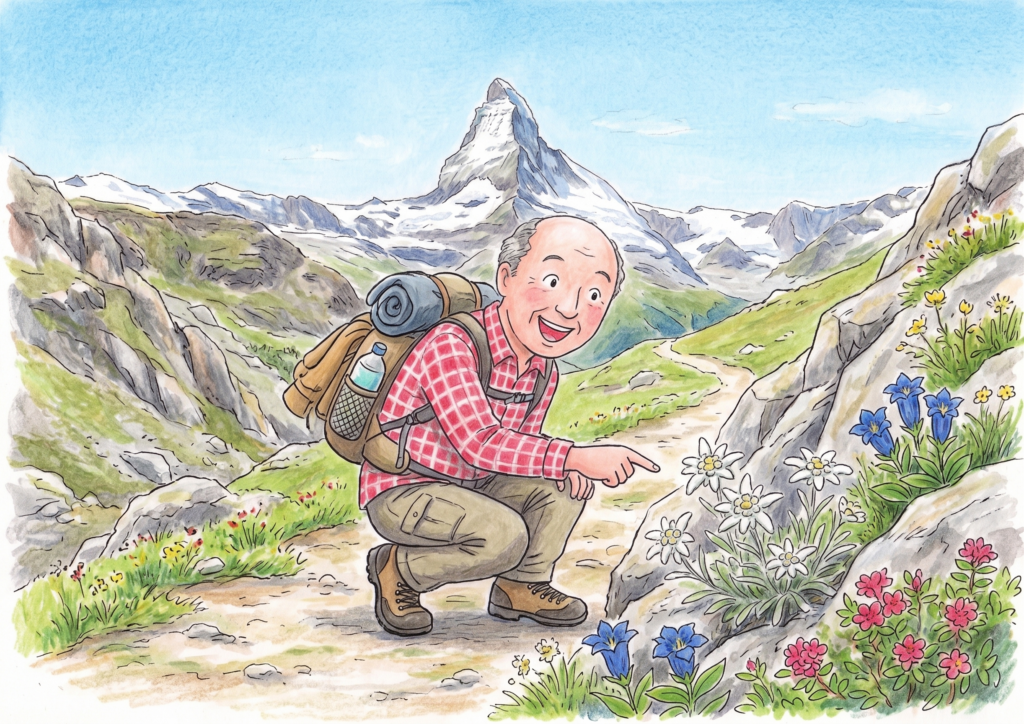
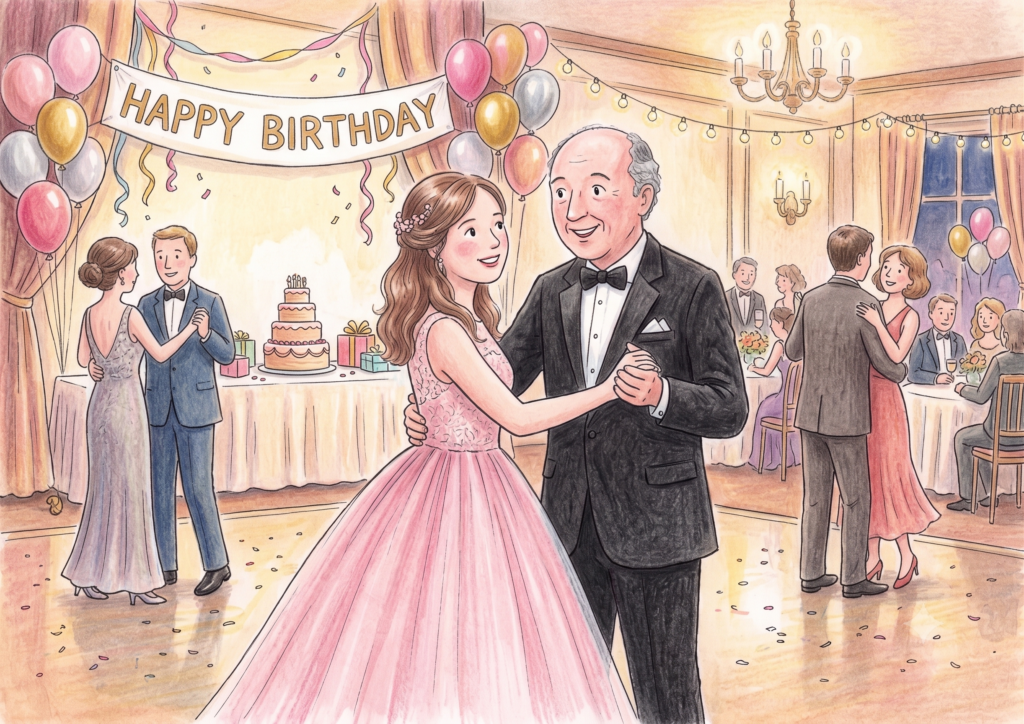
例えば、筆者がプロのイラストレーターに作ってもらった似顔絵のイラスト画像をNano Banana Proに読み込ませて、異なるプロンプトでこの人物を描いてもらったのが、次の例です。いずれの写真も、おいさき短い老人の私が、多分生きているうちには実現しないだろう「夢」を描いてもらったものです。バーチャルとはいえ、こうして生成されたイラストを見ていると、自分の夢がなかば実現したかのような嬉しい錯覚を覚えます。
オリジナルの似顔絵(辻本礼:画)
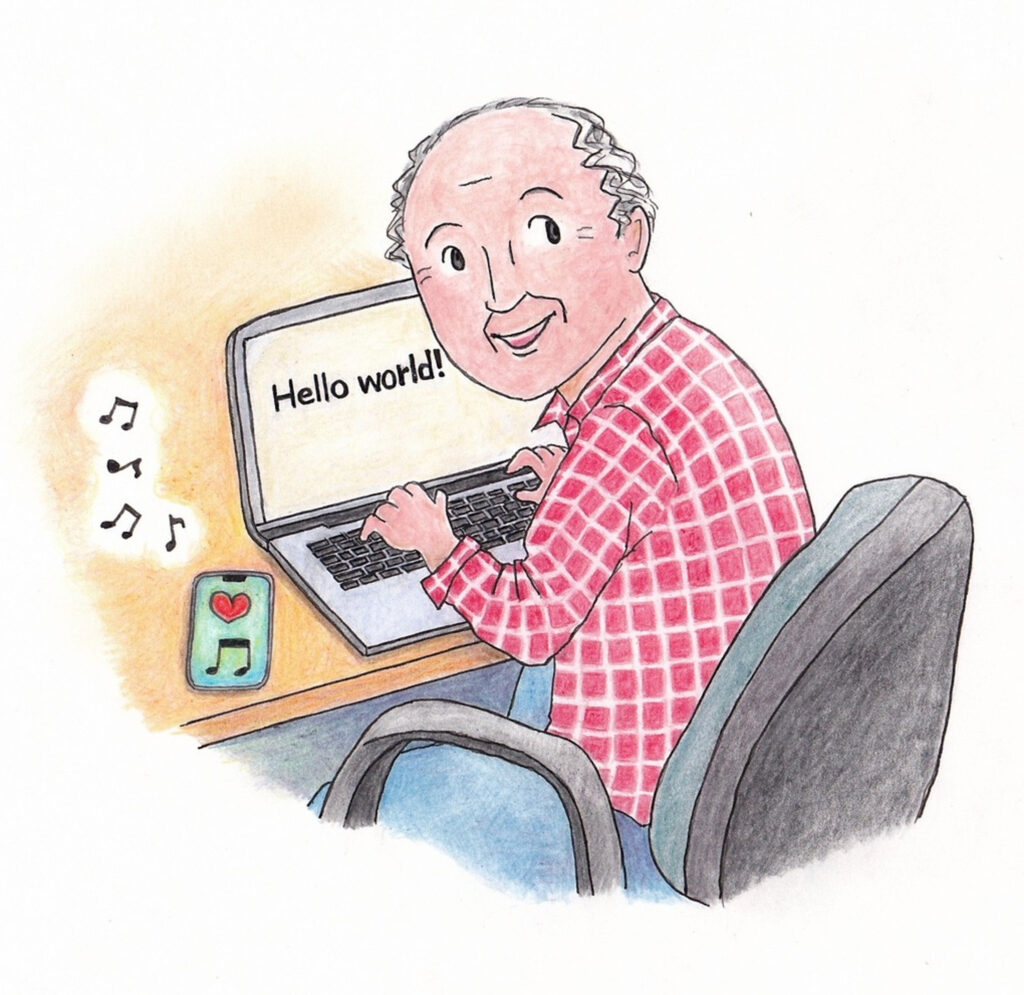
プロンプト1:
「この人物が、カラオケ店で、マイクを握って「いま、船出が近づくこのとき信じたこの道を私は行くだけ、すべては心の決めたままに」」という日本語歌詞の「マイウェイ」を陶酔した表情で歌っている様子の画像を作ってください。イラストで描いてください。店内のソファには、友人の男女が6人くらい座って、歌に聞き入っています。
プロンプト2:
この人物が、夏のスイスのマッターホルン山麓を登山していて、道端に咲くエーデルワイスを見つけて喜んでいる様子の画像を作ってください。
プロンプト3:
この人物が、誕生日祝いのパーティ会場で、正装でピンクのドレスを着た若い女性とダンスしている様子の画像を作って
14-5 : 画像の編集
Nano Banana Proは、自然言語(文章)による指示だけで高精度な写真修正や合成を行えるAI画像編集モデルです。Photoshopのような高度なツールや複雑なレイヤー操作を行わなくても、「何を・どう変えたいか」を言葉で伝えるだけで自然な編集が完成する魔法のような画像編集ツールです。
1. 不要なものの削除・追加
撮った写真に写り込んでしまった不要な通行人や障害物を消したり、新しいアイテムや人物を付け足せます。
| 編集パターン | 元の写真 | 編集プロンプト例 |
|---|---|---|
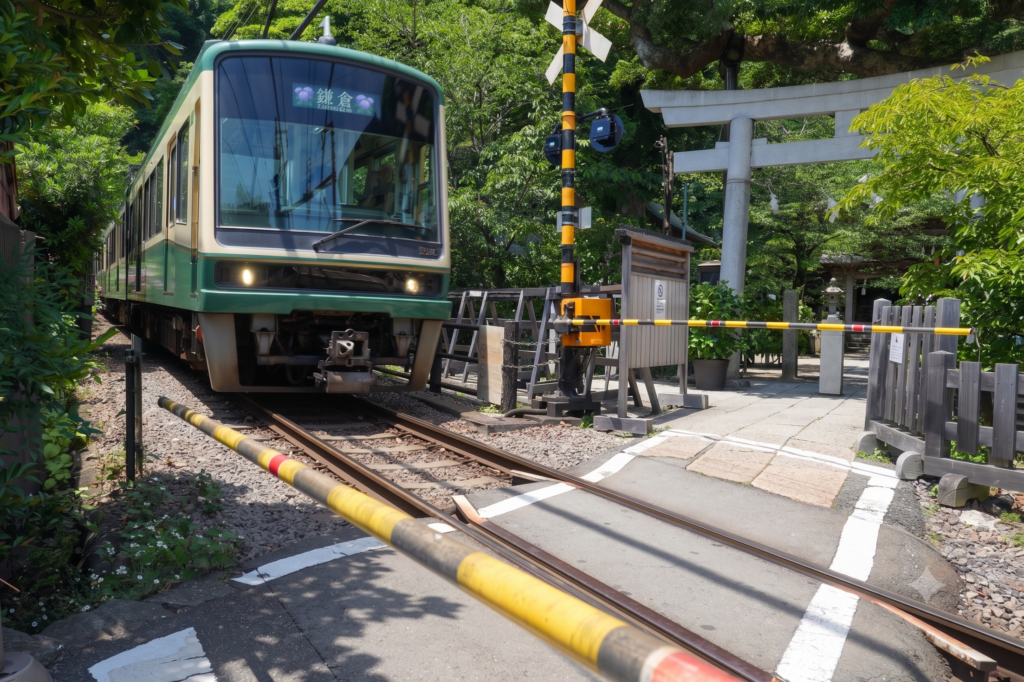
| (1) 不要物の削除 | 背景に通行人が映っている電車の写真 | 踏切の向こう側に写っている通行人を削除し、その場所を背景の建物と自然になじませて修復してください。 |
| (2) アイテムの追加 | カフェのテーブルに座る女性の写真 | テーブルの上に、湯気が立った磁器のコーヒーカップとノートパソコンを1台追加してください。ライティングと影は周囲の光と一致させてください。 |
(1) 不要物の削除
最初の事例は、鎌倉市の江ノ電の踏切で撮った写真です。人気テレビドラマ『最後から1番目の恋』のロケ地なので、聖地巡礼に訪れる観光客が多く、これらの人物を削除するのが画像編集の目的です。Geminiに下の写真を読み込ませ、表(1)にあるようなプロンプトを入れてみました。
編集前の写真データ:

編集後の写真:
(2) アイテムの追加
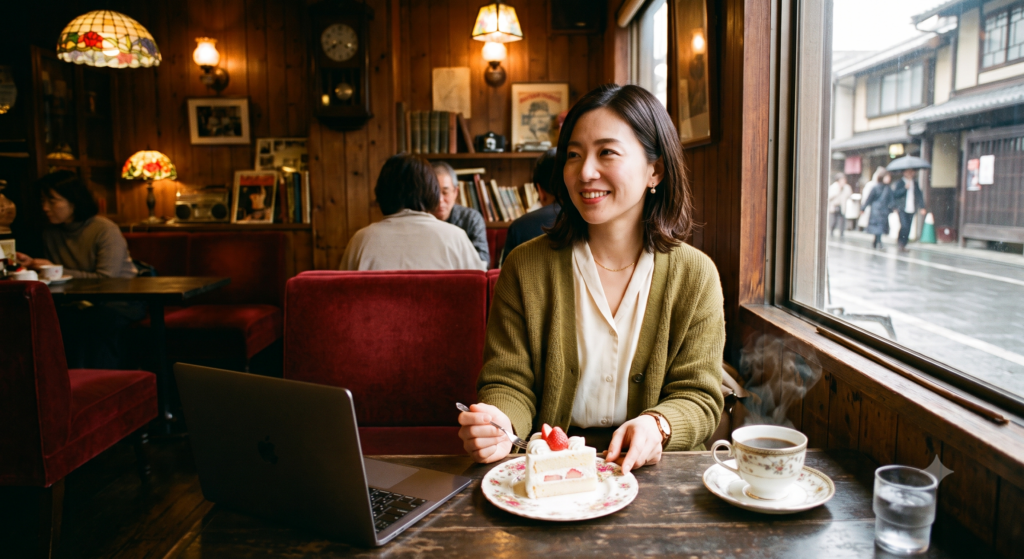
次の事例は、生成AIにつくってもらった、カフェのテーブルに座る女性の写真です。テーブルには、ケーキと水しか置かれていません。そこで、テーブルにコーヒーカップとノートパソコンを追加してもらうという「アイテムの追加」を表(2)のようなプロンプトで実行してもらいました。
編集前の写真:
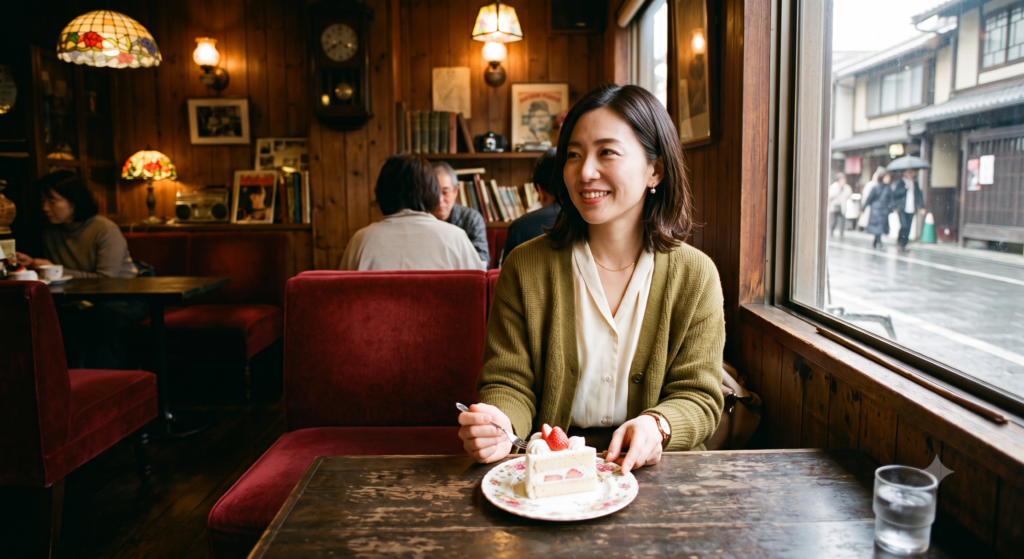
編集後の写真:
2. 背景・ライティングの変更
被写体のクオリティを保ったまま、時間帯やロケーションを丸ごと切り替えられます。
- 時間帯・天候の変更:
全体を昼間の日光から、ゴールデンアワー(夕暮れ時)の暖色系の光に変更して - ロケーション変更:
人物の姿やポーズはそのままで、背景をパリの街路から夕暮れの海辺に変更して
編集前:
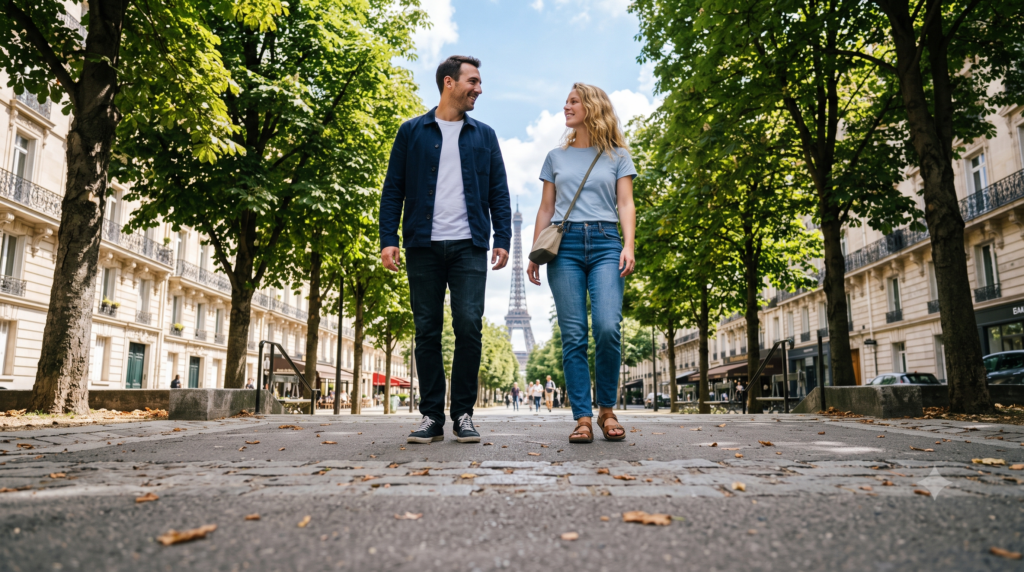
(写真はGeminiで生成)
編集後:
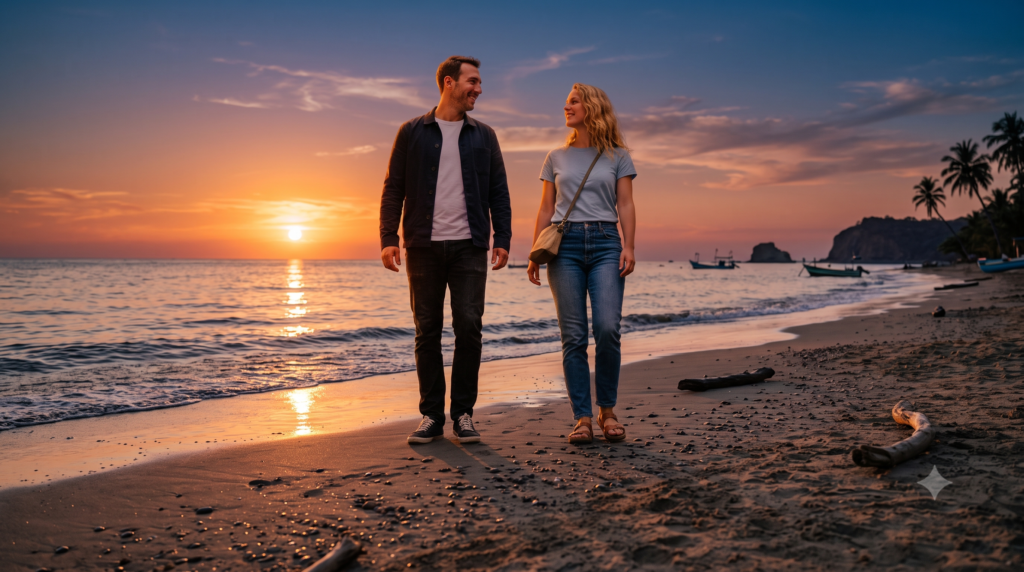
(写真はGeminiで生成)
3. レタッチ・衣装・表情の変更
ポートレート写真の服を着せ替えたり、表情を細かくコントロールしたり、画質を変えたりすることが可能です。
- 衣装チェンジ:
人物の服装を普段着から、シックなフォーマルスーツ(男性)やドレス(女性)に変更して - 表情・ポーズの調整:
表情を少し微笑ませて - 高画質化・肌補正:
元の顔立ちを維持しながら肌の質感とライティングを補正し、4K相当の高精細な写真にして
編集前:
編集後:
4. 古い写真の修復・カラー化
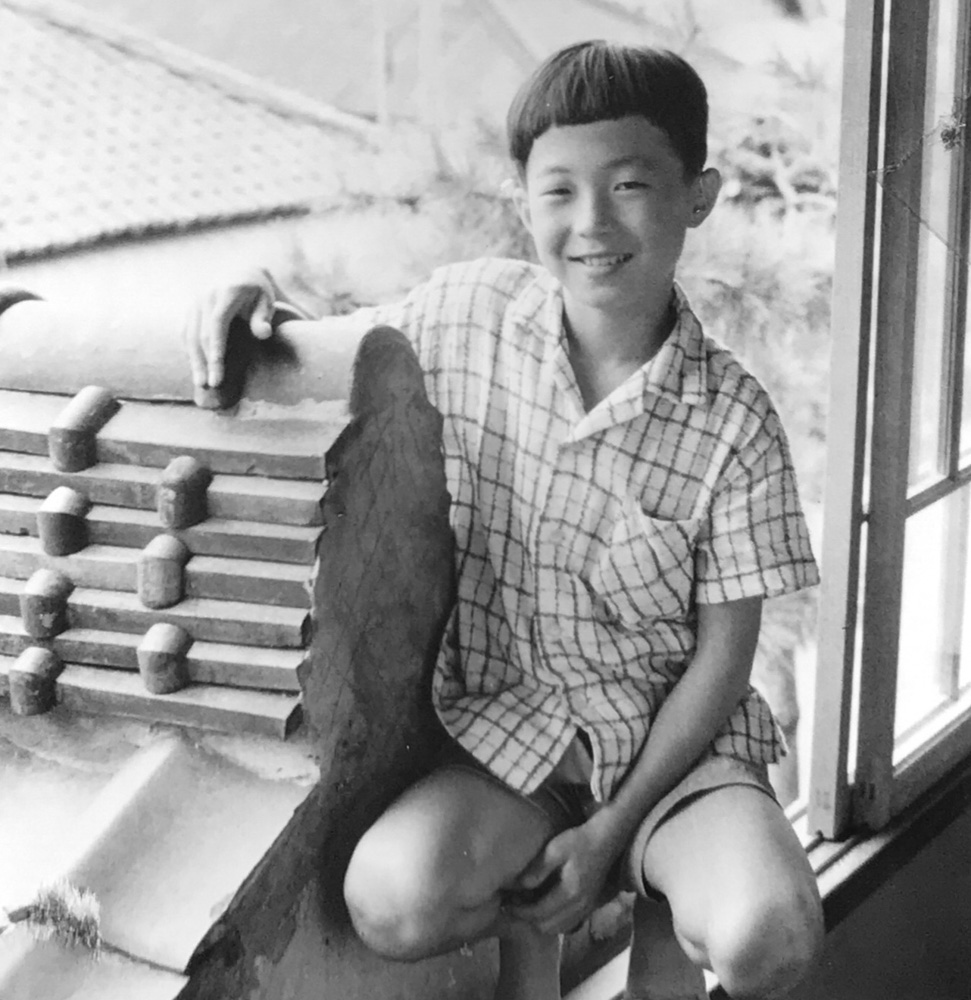
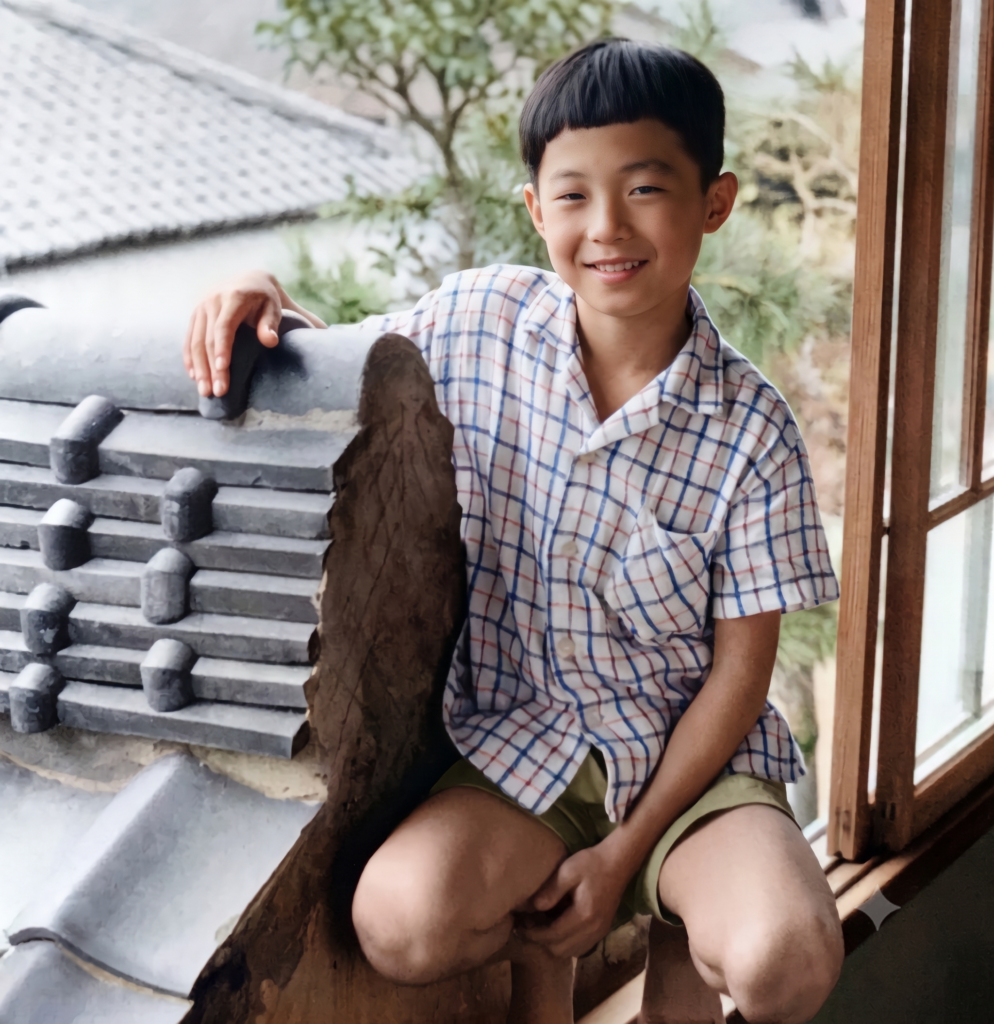
白黒写真や傷ついた昔の写真を綺麗に復元します。下に示した元の写真は、筆者がまだ子供の頃に撮ってもらった白黒写真です。これを、次のような「復元プロンプト」を入れるだけで、綺麗なカラー写真に変えてくれます。
- 復元プロンプト:
写真の傷やノイズを取り除き、全体をクリアにした上で、自然な色合いでカラー化して
編集前:
編集後:
5. 看板、ポスター、商品のパッケージラベル、横断幕の文字などの正確な書き換え
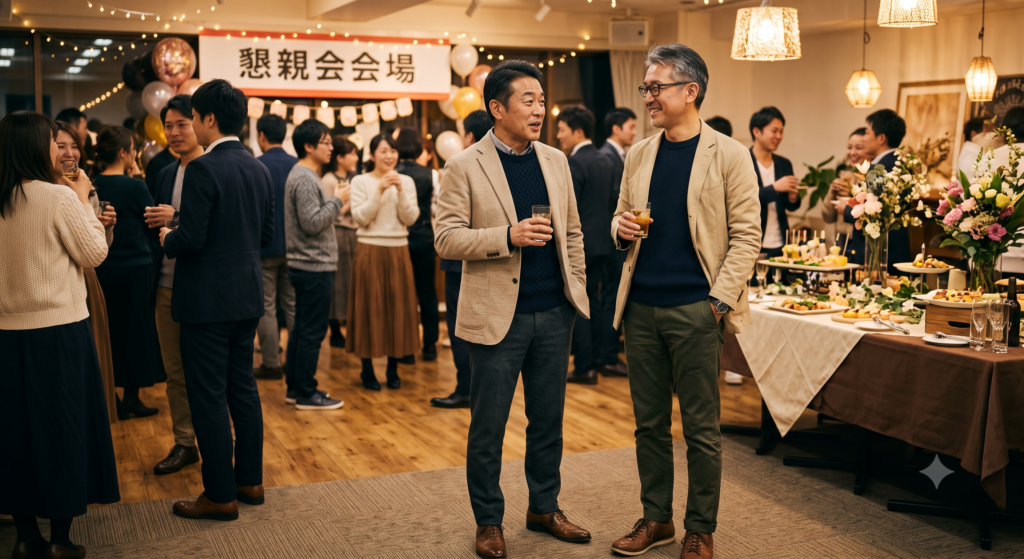
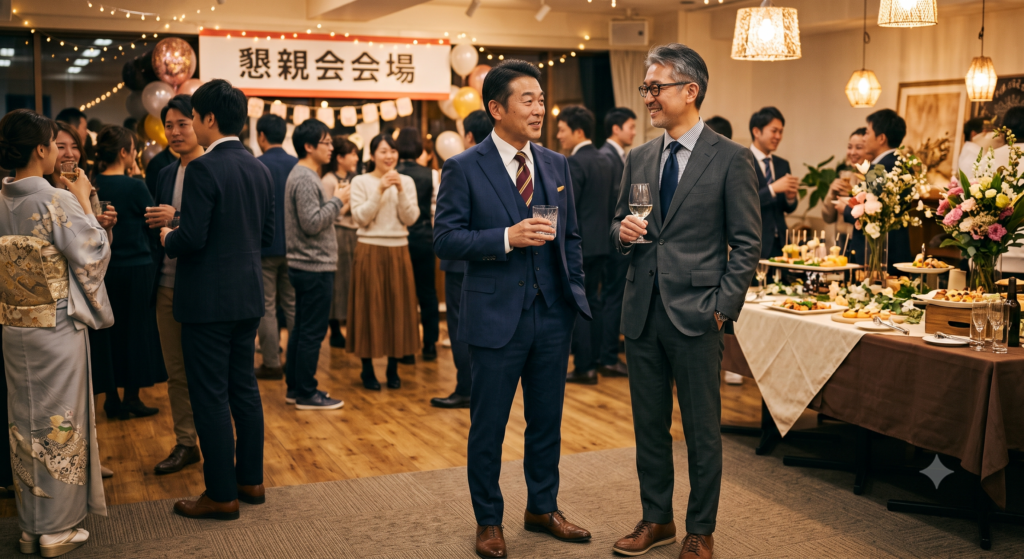
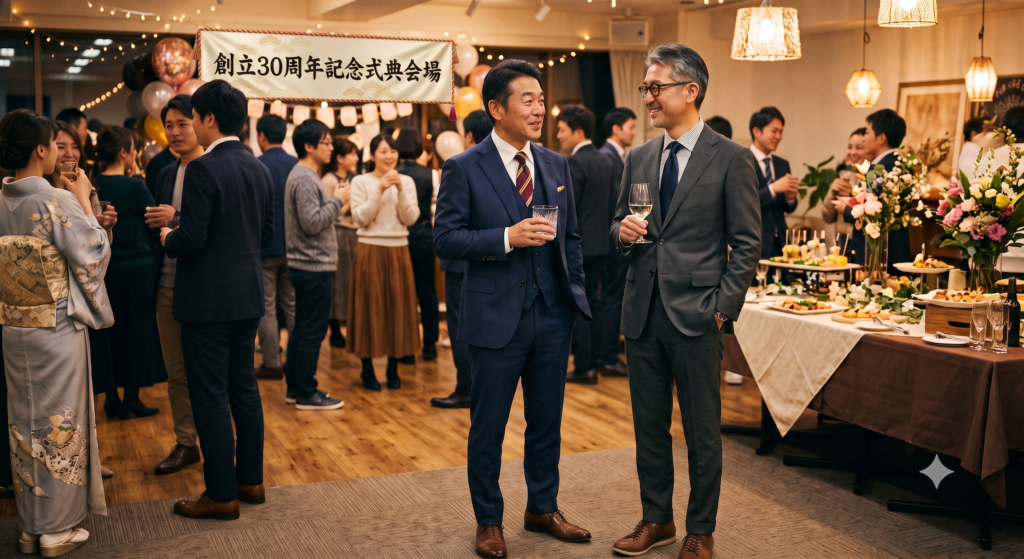
写真に写っている看板、商品のパッケージラベルやロゴ、横断幕の文字など、日本語や英語のテキストを、リクエスト通りに正確に書き換えることできます。例として、3. で生成した懇親会会場の背景にある横断幕の文字を書き換えてみましょう。プロンプトは次の通りです。
プロンプト:写真の懇親会会場」という横断幕を、「創立30周年記念式典会場」と変更してください。
変更後の写真:
6. 複数画像の合成
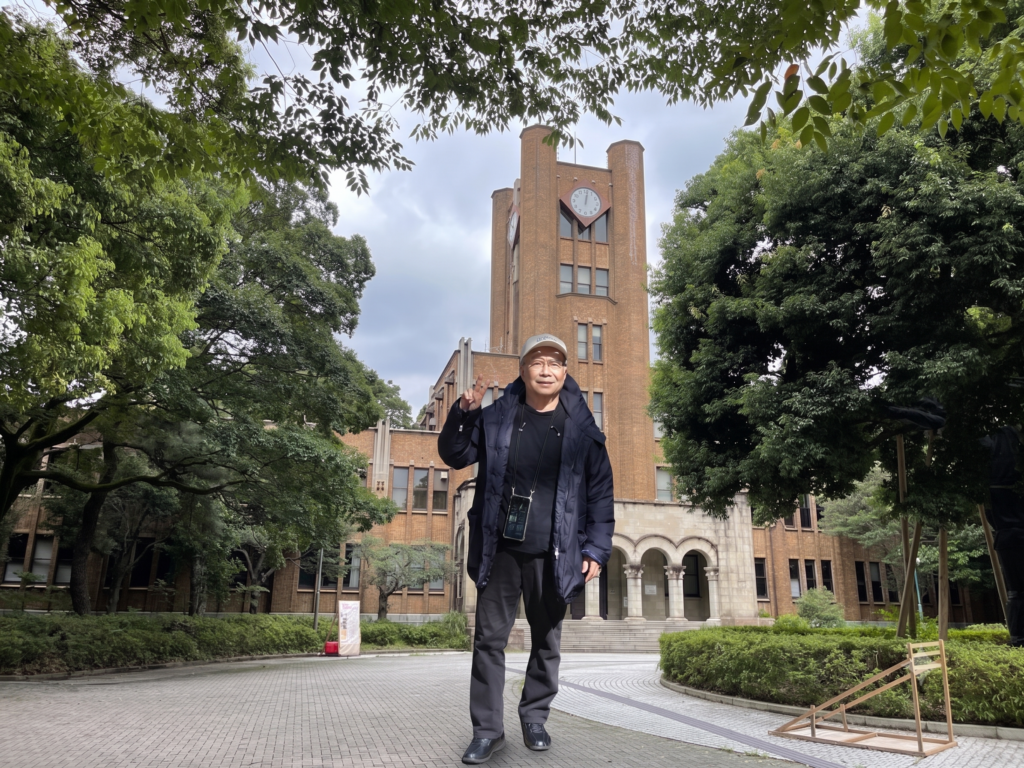
Nano Banana Proは、複数の画像を用意し、プロンプトでシーンを描写してあげることによって、自然な色調とシーン構成で合成画像を生成してくれます。例として、筆者が東大駒場キャンパスで撮った駒場1号館の写真と、アメリカのヨセミテ国立公園で撮影した写真を合成してみました。プロンプトは次の通りです。
プロンプト:
[画像1] の人物を被写体、[画像2] の東大キャンパス風景を背景として、1枚の自然な写真を生成してください。
[画像1] の男性の顔写真を [画像2] の中央に、遠近感を合わせて立たせてください。
画像1:

画像2:

合成した写真:
第15章 : Geminiによる動画生成
15-1 : Gemini Omni(動画生成・編集AIモデル)
Gemini Omni(ジェミニ・オムニ)は、Googleが開発した、テキスト・画像・音声・動画を自由に組み合わせて高品質なAI動画の生成や編集ができる次世代のネイティブマルチモーダルAIモデルです。単に「文章から動画を作る」だけでなく、「AIと会話しながら手持ちの動画や写真を編集・仕上げていく」 という新しい映像制作体験を提供します。
(1) 会話形式で直感的に動画編集(マルチターン編集)
- 生成した動画やアップロードした動画に対して、「背景を夜にして」「雨を降らせて」「服装をスーツに変えて」といった指示を文章で伝えるだけで編集できます。
- 指示を繰り返しても、登場人物の顔立ちや背景の一貫性が崩れずにシーンの文脈が維持されます。
(2) 多彩な素材の組み合わせ(マルチモーダル入力)
- テキストだけでなく、複数枚の写真、手持ちの動画クリップ、BGM用の音声ファイルなどを一括で読み込ませて、1本の動画として自然に合成・再構築できます。
(3) 映像と音声を同時に生成(ネイティブ音声対応)
- 映像の生成とあわせて、シーンに合った環境音(雨音や波の音)、効果音、BGM、人物のセリフなどを自然に同期させた状態で生成できます。
(4) 物理法則とリアルな世界知識の反映
- 重力や光の反射、流体の動きなどの物理現象や、歴史・文化・科学などの背景知識を理解してシミュレートするため、不自然な歪みの少ない現実的な映像が得られます。
(5) パーソナルアバター生成機能
顔認証などの厳格な手順を経て自身の姿を登録することで、自分にそっくりなデジタルアバターを動画内に登場させ、指定したセリフを喋らせる動画を作る機能もサポートされています。
(7) 動画生成の例
Geminiで動画を生成する例を紹介します。
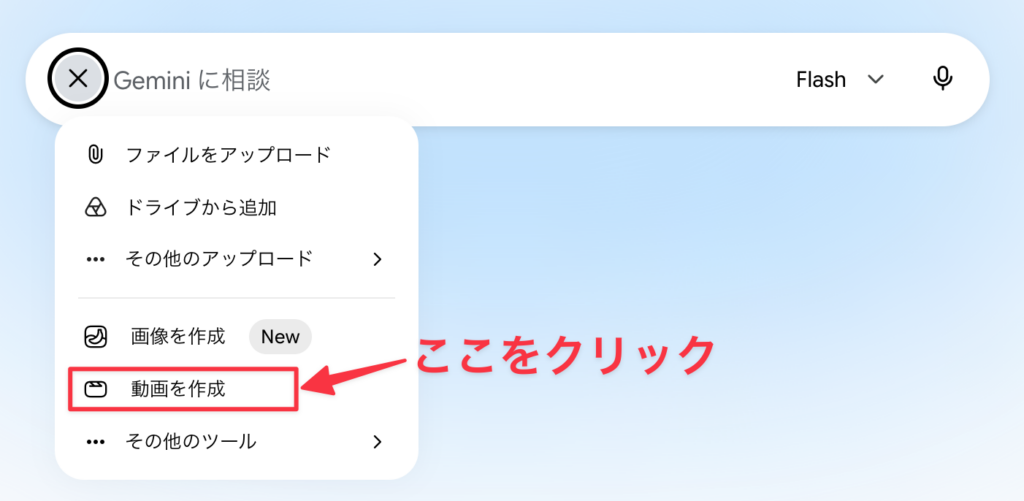
① 動画の素材として、Geminiの画像生成機能を利用して、「パリの通りを歩いている女性」の写真を生成しておきます。
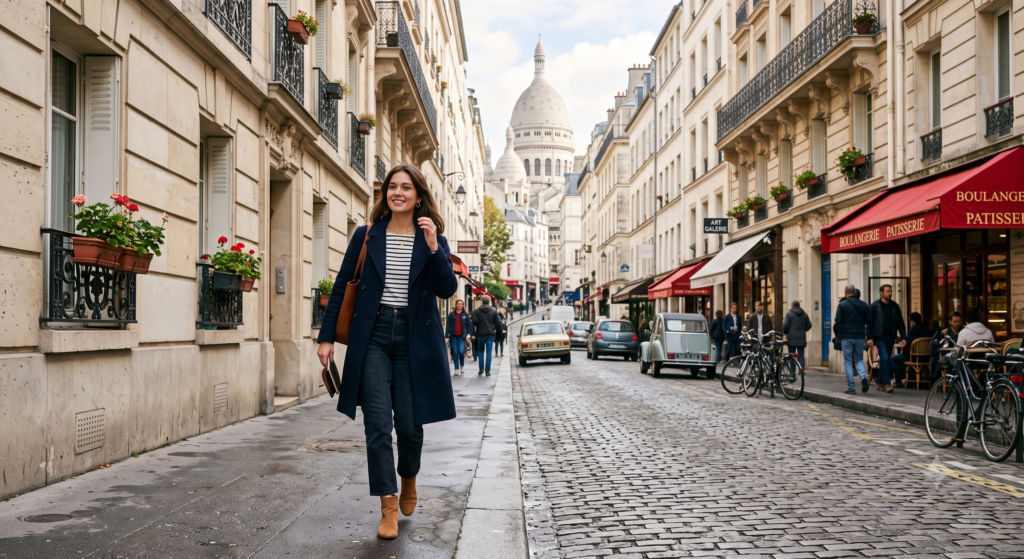
② Geminiを開き、チャット欄のメニューを開き、「動画を作成」を選択します。
③ Geminiの画像生成で作成しておいた「パリの通りを歩く女性」の画像を動画入力欄左の+をクリックしてアップロードし、チャット欄に、次のようなプロンプトを入れる。
④「写真の女性が通りを歩いていると、カフェがあったので、そこに入っていく動画を生成して」
⑤ すると、次のような動画が生成されます。
15-2 : Google Flow
Google Flowは、Googleが提供するクリエイター向けの「AIクリエイティブスタジオ(映像制作・ワークフロー環境)」です。単にテキストから1本の短い動画を出力するツールにとどまらず、映画やプロモーション動画、シネマティックなストーリー、カスタムツールなどのプロジェクトを構築・編集・管理できる統合的な作業スペース(ワークフロー)として設計されています。
(1) 主な特徴
- Google最先端AIモデルの統合:動画生成モデル「Veo」(Veo 3 / Veo 3.1など)、画像生成モデル「Imagen」、AIアシスタント「Gemini」などの最先端生成モデルがひとつに統合されています。
- 一貫性のあるシネマティック生成:同一プロジェクト内でスタイルや登場人物や世界観の一貫性を保ちながら、複数ショット(カット)やシーンを管理・生成できます。
- ネイティブ音声同期:対応モデル(Veo 3以降など)を使用することで、動画の映像生成と同時にBGMや効果音などの自然な音声生成を組み合わせることができます。
- 柔軟なプロンプトとワークフロー
- Text to Video:テキストの指示文から動画を生成
- Image to Video:静止画をベースにカメラワークや動きを指定して動画化
- プロジェクト・シーン編集:複数のクリップを並べて調整し、ストーリーボードのように組み立てることが可能
- クレジット制システム有料プラン(Google AI / Google Flow サブスクリプションなど)に基づき、生成速度(Fastモード / Qualityモード)や使用モデルに応じたクレジットを消費して利用します。
(2) 基本的な使い方
Step 1: ログイン
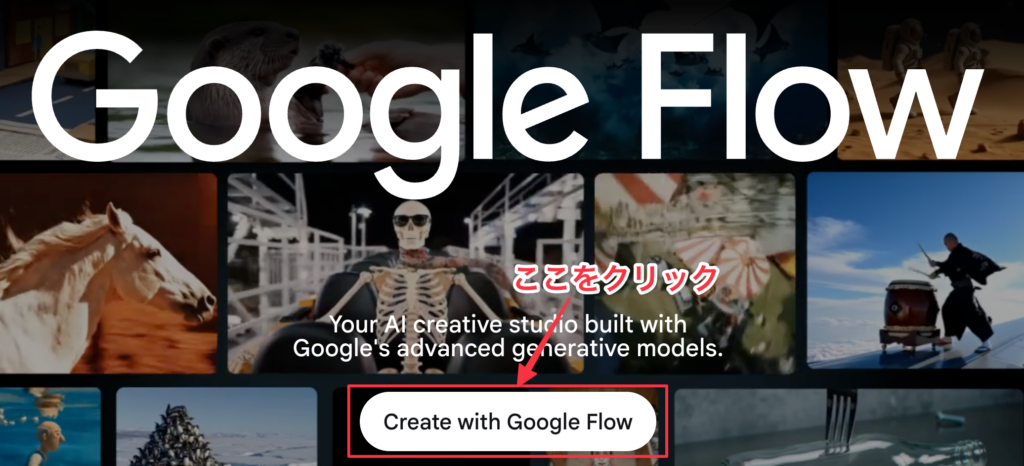
① Google Flowのホームページにアクセスします。お持ちのGoogleアカウントでログインします。
② Create with Google Flowボタンをクリックします。
Step 2: プロジェクトの立ち上げ
画面下の「+新しいプロジェクト」ボタンをクリックします。
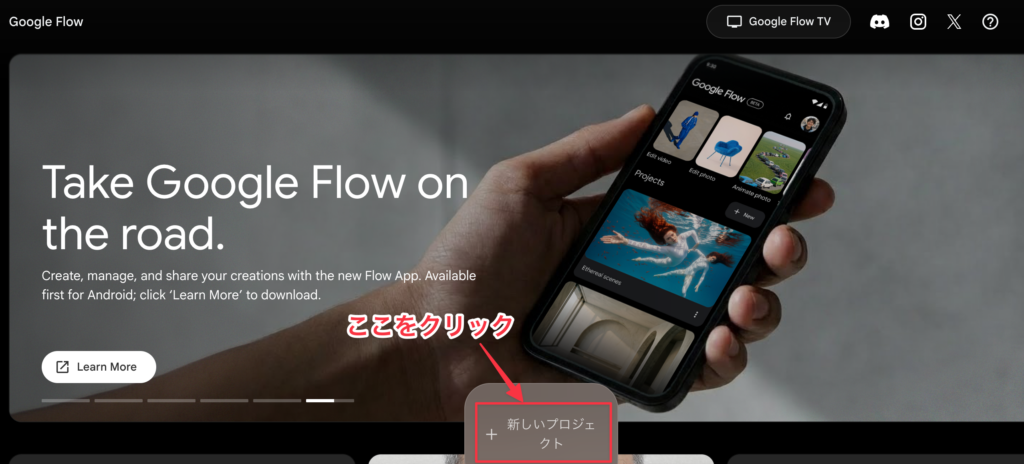
これで、Google Flowを開き、新規プロジェクトを作成します。Flowは、基本的にプロジェクト単位で作業を進めていきます。一つのプロジェクトの中に、生成した画像、生成した動画、アップロードした素材、参照画像、キャラクター、アバターが保存されます。したがって、プロジェクトは制作する動画の種類ごとに、異なるプロジェクト名をつけて保存しておくと、あとで探すときなどにも便利です。
Step 3: Google Flow TV の視聴
動画生成に入る前に、実際にFlowで作成されたさまざまな動画の画面例と、それらの動画生成に使われたプロンプトの作品例を画面上部のGoogle Flow TVというボタンをクリックすることによって視聴することができます。右下の「CHANNEL」のボタンをクリックすると、みたい動画の種類(ジャンル)を選ぶことができます。
この参考動画をみて、気に入ったものがあったら、下のプロンプトを参考にして、日本語で作り変えて、思い通りの動画を作成することができます。
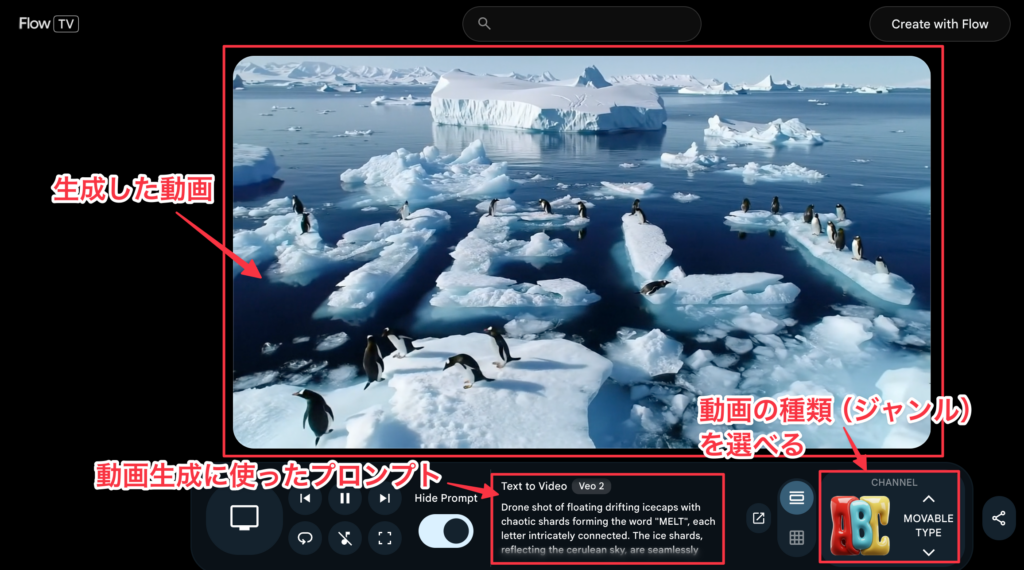
Step 4: 画像生成の選択
Flow で動画を生成するとき、いきなりプロンプトで動画生成を指定するよりも、もとになる画像を生成し、それをもとに動画生成する方がより正確な動画を生成することができます。Flowには、強力な画像生成機能が入っていますので、ここではまず画像を生成するというステップを入れることにします。
画面下の矢印で示した部分をクリックします。
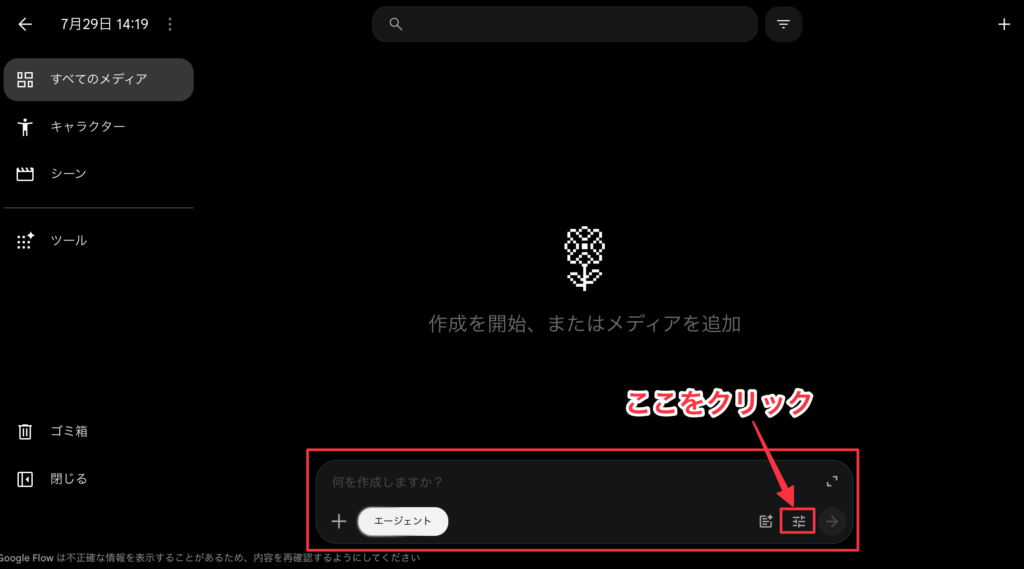
Step 5: 生成方式・モデルの選択
- 入力ソースの選択:テキスト指示から新規作成するか、既存の画像や参照用ビジュアルをアップロードします。
- 画像モデルの選択:用途に応じて生成モデル(例: Nano Banana2)やアスペクト比(16:9)を設定します。画像モデルは、画質などにこだわらず短時間で生成したい場合はNano Banana 2、細かい画質にこだわりたい場合はNano Banana Proを選ぶといいでしょう。
- 生成枚数の選択:生成する枚数は、4枚まで指定できます。できるだけ多めに作成する方がいいでしょう。画像の生成にはクレジット課金はされませんので安心です。
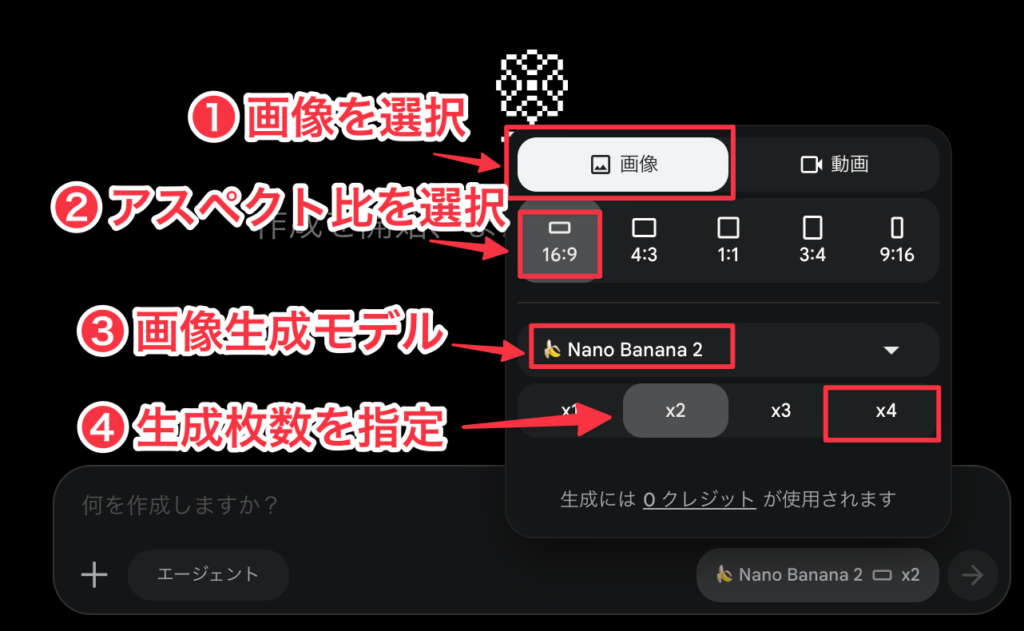
Step 6: 画像生成のプロンプト入力
Geminiの場合と同じですが、Flowでも、思い通りの画像を生成してもらうには、プロンプトを書く際、以下の5つの要素を意識して組み合わせると精度が上がります。
- 主題(Main Subject):誰が/何が(例:黒髪の女性、柴犬、SF風のロボット)
- 背景・場面(Setting/Background):どこで/いつ(例:雨の日のカフェ、夕暮れのビーチ、未来都市)
- スタイル・画風(Style):どんな質感か(例:写実的な写真、水彩画、アニメ風、3Dレンダリング)
- 構図・光・色(Composition & Lighting):どう見えるか(例:正面からのアップ、自然光、鮮やかなグラデーション)
- 指示(Action):〜の画像を生成してください
そのまま使えるプロンプトの見本
1. リアルな写真風(フォトリアル)
【見本1:人物ポートレート】
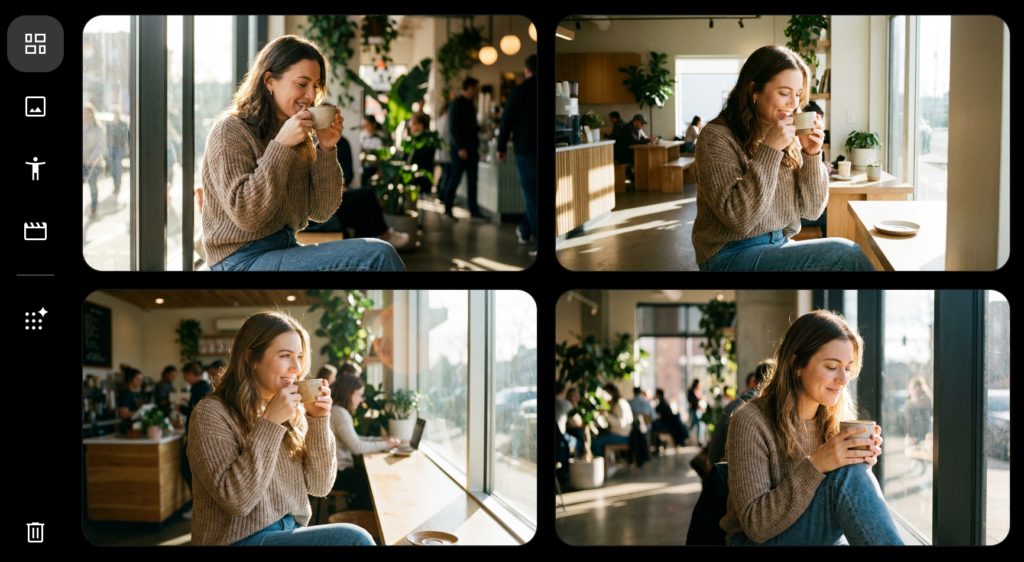
「明るい日差しが差し込むモダンなカフェで、窓際に座ってコーヒーを飲む20代の女性の高精細な写真。カジュアルな服を着て柔らかい笑顔を見せている。自然光、浅い奥行き(背景のボケ)、温かみのある色合いで生成してください。」(Gemini))
生成した画像(4枚):
【見本2:風景・自然】
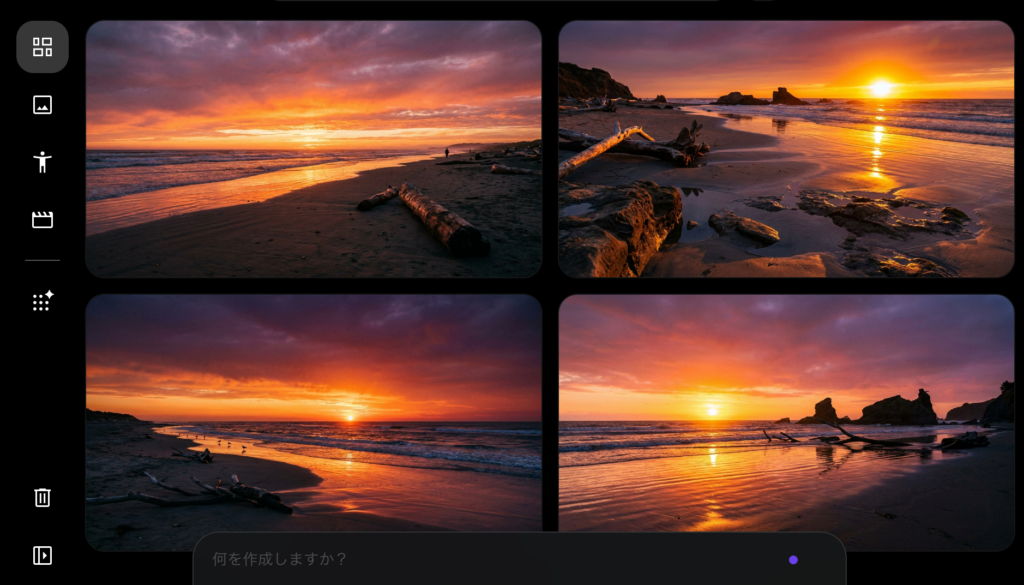
「夕暮れ時の静かなビーチの美しい景色の写真。空はオレンジと紫のグラデーションで、波打ち際に夕日が反射している。広角レンズ、ドラマチックな照明、一眼レフカメラで撮影したようなリアルな質感で作成してください。」(Gemini)
生成した画像(4枚):
2. ビジネス・プレゼン資料用(ストックフォト風)
【見本1:オフィス・チームワーク】
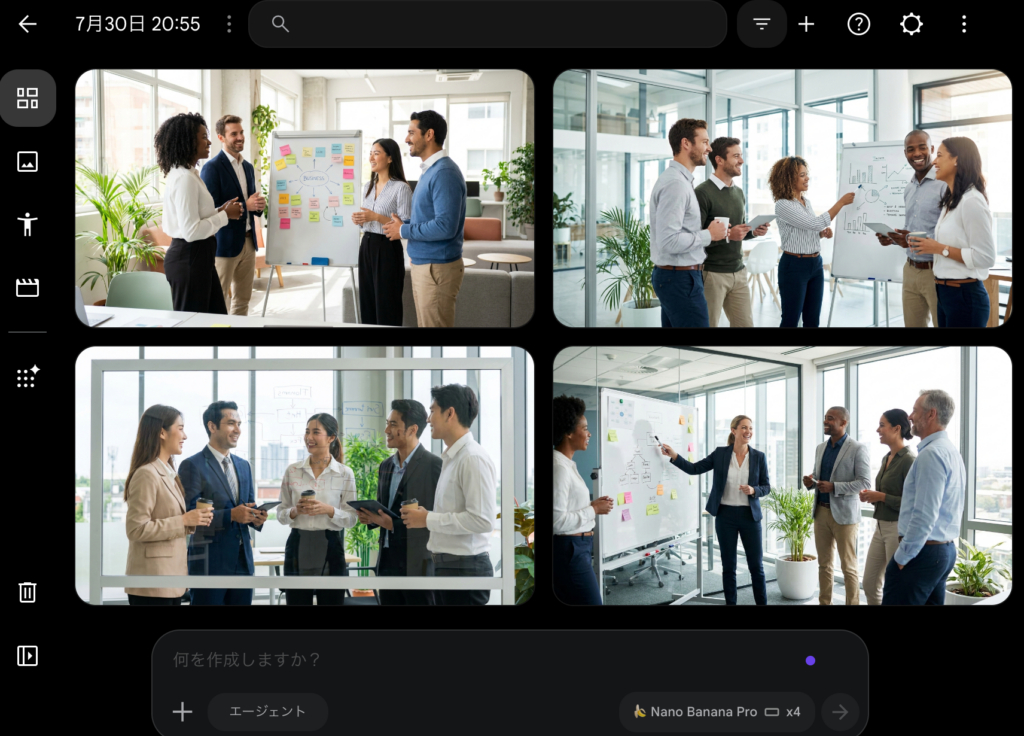
「明るくモダンなオフィスで、多様なバックグラウンドを持つビジネスパーソンチームがホワイトボードを囲んで笑顔で議論している様子のストック写真風画像。プロフェッショナルかつ協調的な雰囲気、清潔感のある明るい照明で生成してください。」(Gemini)
【見本2:概念・コンセプト(アイキャッチ向け)】
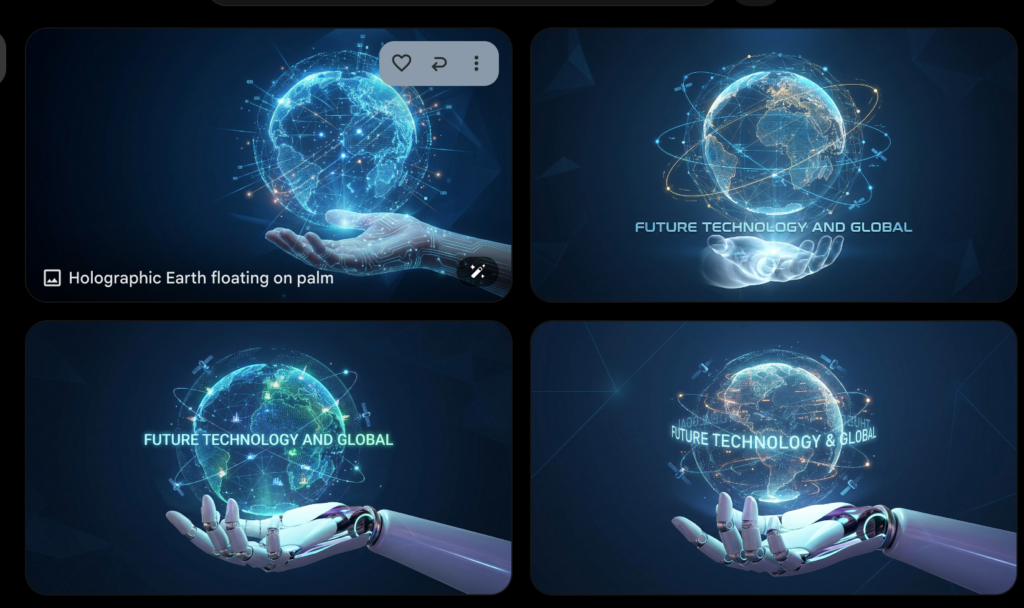
「手のひらの上に浮かぶホログラムの地球とデータネットワークの3Dレンダリング画像。テーマは『未来のテクノロジーとグローバル』。背景はシンプルなダークブルー、ミニマルで洗練されたデザインで作成してください。」(Gemini)
Step 7: 動画生成のプロンプト入力
① 動画作成例として、上のリアルな写真風(フォトリアル)画像の「見本1」を取り上げ、生成した4枚の画像の中から、動画化するのにもっと適した画像を選択し、画像の右上の3点マークをクリックし、メニューの「アニメーション化」を選択します。
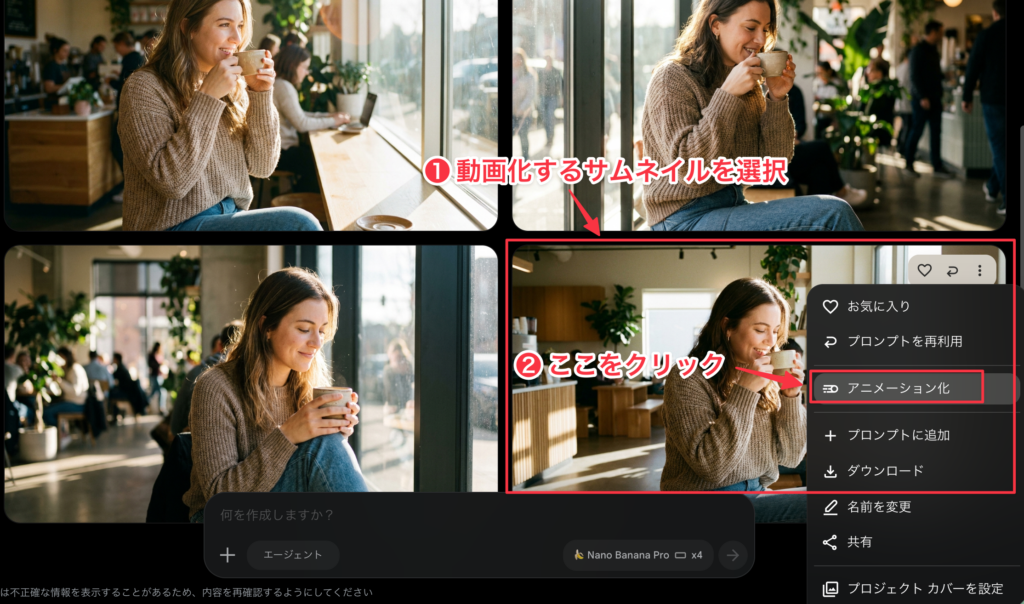
② プロンプトの入力
画像から動画を作成する場合、プロンプトには「画像に写っていない動きやカメラワーク」のみを指示するのが最大のコツです。(被写体の見た目を細かく書きすぎると、元の画像から破綻しやすくなります)
プロンプトは以下の3つの要素を組み合わせると失敗が少なくなります。
[被写体の動き] + [背景・環境の変化] + [カメラワーク]
シーン別・プロンプトの具体例は、次のとおりです (Gemini)。
- 人物・キャラクター(自然な感情・動作)
1) 笑顔・目線移動:
The woman slowly looks up, turns her head toward the camera, and smiles softly. Hair gently swaying in the breeze.
(女性がゆっくりと顔を上げ、カメラに視線を向けて優しく微笑む。髪が風に柔らかく揺れている。)
2) 歩行・移動:
A person walking forward naturally down the street, slow-motion, smooth movement.
(人が通りを自然に前に向かって歩く。スローモーションでスムーズな動き。) - 風景・自然(空気感・シネマティック)
1) 風景(海・風):
Ocean waves gently crashing onto the shore, palm tree leaves swaying in the wind, sunset lighting gradually shifting.
(海岸に寄せる静かな波、風に揺れるヤシの葉、夕日の光が徐々に変化する。)
2) ドローン風カメラワーク:
Slow aerial drone shot, zooming out to reveal the vast mountain range, clouds moving across the sky.
(ゆったりとしたドローンの空撮。ズームアウトして広大な山脈が現れ、雲が空を流れていく。) - SF・ファンタジー・エフェクト
1) 魔法・パーティクル:
Magic glowing orbs hovering and floating around the hand, subtle particles drifting in the air.
(手に浮かぶ魔法の光る球体、微細な粒子が空気中を漂う。)
2) カメラを引く大きな展開:
Fast camera zoom-out, revealing a massive cyberpunk city expanding beneath.
(急速なカメラのズームアウト。下に広がる巨大なサイバーパンク都市が姿を現す。)
以上の例を参考にして、動画化のプロンプトを作ってみました。ここでは英語でプロンプトを作っていますが、日本語のプロンプトでも大丈夫です。ただ、英語の方が細かいところまで正確に動画化できるようです。
The woman slowly looks up, turns her head toward the camera, and smiles softly. Hair gently swaying in the breeze. Then, she stands up and walk toward the exit door , open it slowly and go out to the street. On the horse-chestnut avenue, she meets her friend and they walked the street and chat joyfully.
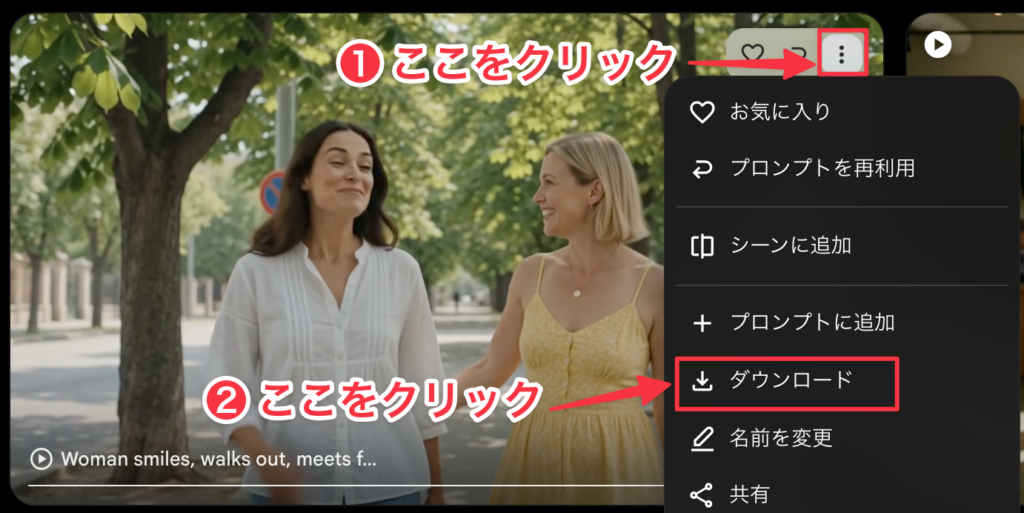
Step 8: 書き出し(ダウンロード)
完成した動画やプロジェクトを出力し、ダウンロードまたは各種プラットフォームへ共有することができます。
動画生成の実行前に、画質やアスペクト比、動画モデルなどの指定を行います。画面の下に消費クレジット数が表示されますから、利用可能なクレジット数を確認してから実行するようにしましょう。クレジット数が足りないと、画面に警告メッセージが出て、画像化ができないことがあります。
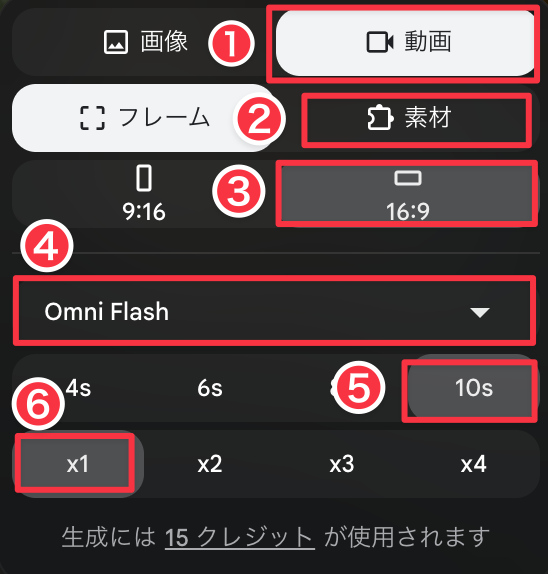
❶ 動画を選択
❷ 素材を選択(最初と最後の画像を設定する場合は、フレームを選択する
❸ アスペクト比:横長を選択
❹ 動画モデルを選択
❺ 生成する動画の秒数を選択(長いほどクレジットを消費する)
❻ 生成する動画の本数を指定(1本)
生成した動画:
15-3 : Google Vidsによる動画生成
Google Vids(グーグル ヴィズ)は、Google Workspaceに含まれるビジネス・教育向けのAI動画作成アプリです。「動画編集ソフト」というよりは「動画版のGoogleスライド」に近い使い勝手で、プロのような動画編集スキルがなくても、ドキュメントやプレゼン資料から数分で解説動画や研修用動画を作成できます。
Google Vidsの利用には、以下のいずれかのアカウント要件を満たしている必要があります。
- 対象のGoogle Workspaceプラン: Business Starter / Standard / Plus、Enterprise、Frontline Plusなどの契約アカウント
- Gemini アドオン: 「Gemini for Google Workspace」アドオンライセンスが与えられているアカウント
- 教育向けアカウント: Google Workspace for Educationなどの対象プラン
- 個人アカウント: Google AI 関連の有料プラン(Google AI Pro / Ultra など)加入アカウント
1. Google Vidsの主な特徴
(1) ドキュメントやスライドからAIが全自動生成
Google ドライブ内のGoogle ドキュメントやGoogle スライドのファイルをAI(Gemini)に読み込ませるだけで、構成案(ストーリーボード)・ナレーション原稿・ストック素材・BGMなどを一括生成してくれます。
(2) 「AIアバター」と「多言語ナレーション」の自動生成
カメラの前に立って録画しなくても、AIアバターがあなたの代わりにプレゼンしてくれます。日本語を含む多言語の音声読み上げに対応しており、プロンプトで表情や仕草を指定することも可能です。
(3) 最先端AI(Veo・Lyria)による動画、BGM素材の生成
- 動画生成(Veo): 「オフィスで打ち合わせする風景」などのテキスト指定や静止画から、動画素材を直接生成できます。
- BGM生成(Lyria): 雰囲気(例:「明るいジャズ」「落ち着いた企業風」)を言葉で指定してオリジナルのBGMを作成できます。
(4) スライド感覚で直感的にタイムライン編集
動画の1カット(シーン)がスライド1枚のように並んで表示されます。タイムラインを使った複雑な動画編集ではなく、ドラッグ&ドロップやテキスト書き換えで直感的に編集可能です。
(5) リアルタイム共同編集
Google ドキュメントやスライドと同様に、チームメンバーと同時に作業したり、コメントを残したりできます。
2. 主な活用シーン(個人の生活&仕事レベル)
(1) 副業・個人ビジネス・情報発信
- 顔出しなしの解説・PR動画制作(YouTube / SNS用)
- AIアバターやAI音声(ナレーション)機能を活用し、カメラの前に立たずにガジェットレビュー、ノウハウ解説、ニュースまとめなどの動画を作成できます。
- ココナラやクラウドワークス等の実績・サービス紹介
- Webライティングやデザイン、動画編集などのスキルを販売する際、テキストだけのプロフィールよりも視覚的に伝わる「サービス紹介動画」を手軽に用意できます。
- 個人ブログ・Webサイト用動画
- ブログ記事の内容をサマリー動画化して記事内に埋め込むことで、滞在時間の向上や分かりやすさの向上につながります。
(2) 就職・転職・キャリア(ポートフォリオ)
- ビデオ履歴書・自己PR動画の制作
- これまでの経歴やスキル、実績をまとめたスライドをベースに、ナレーション付きの自己PR動画を短時間で仕上げられます。
- オンラインポートフォリオ
- 過去に作成したデザイン、プログラミング作品、執筆記事などをスライド風に並べ、BGMやテロップを付けて作品集動画に仕立てることができます。
(3) 個人学習・研究・オンライン講座
- 発表資料の動画プレゼン化
- 学生の研究発表や社会人の勉強会・セミナー用スライドを動画化し、事前配布用の解説コンテンツを作成できます。
- 個人向けデジタル教材・オンライン講座の作成
- 自身の得意分野(語学、プログラミング、趣味のノウハウなど)を動画講義として体系化し、Udemyやnoteなどで発信する際のコンテンツ制作に役立ちます。
(4) 趣味・コミュニティ・プライベート
- イベントやサークルの案内・告知
- 趣味のオフ会、地域イベント、同人活動、サークル勧誘などの告知用ショート動画をプロ並みのクオリティで作成できます。
- 旅行・ライフイベントの思い出動画(スライドショー)
- 撮影した写真や動画をタイムラインに並べ、BGMやトランジション(切り替え効果)を追加して家族や友人へ共有できます。
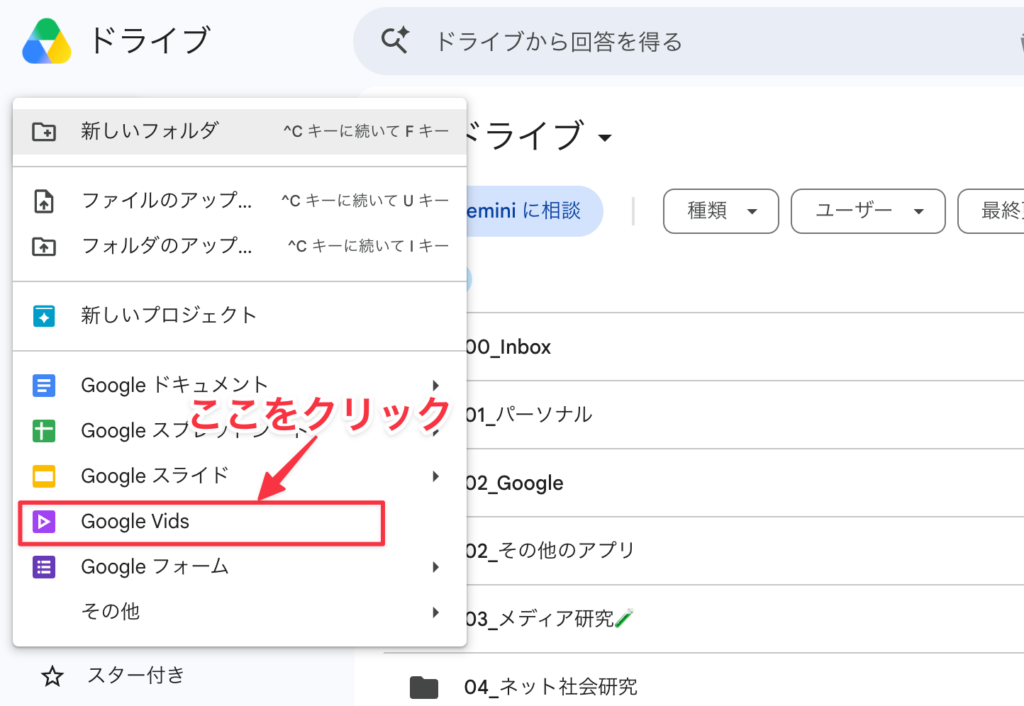
3. Google Vidsの起動(ログイン)
Google Vidsによる解説動画の作成は、主に以下のステップで進めます。
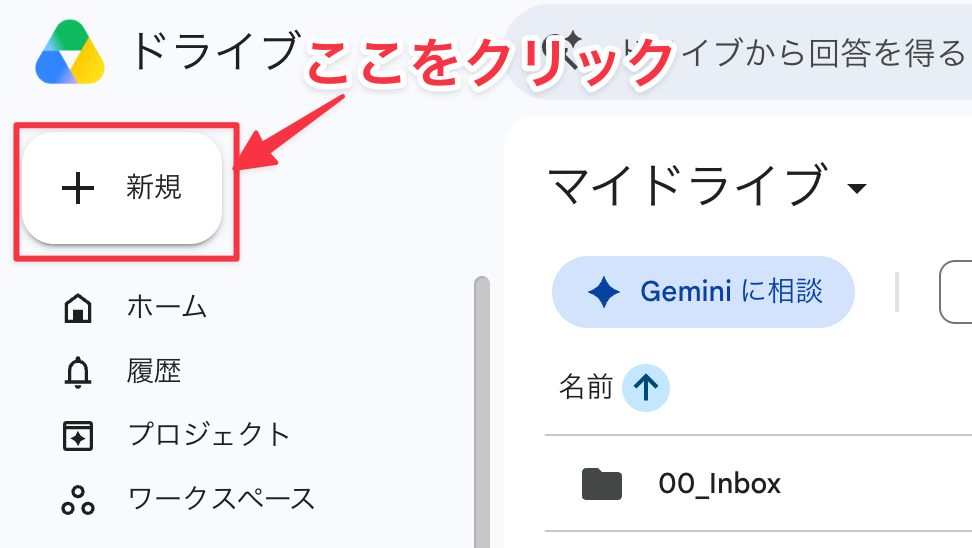
STEP 1:動画を作成・起動する
Vidsにログインするには、3種類の方法があります。
(1) Chromeの検索画面のGoogleアプリ一覧から、Vidsを選択します。
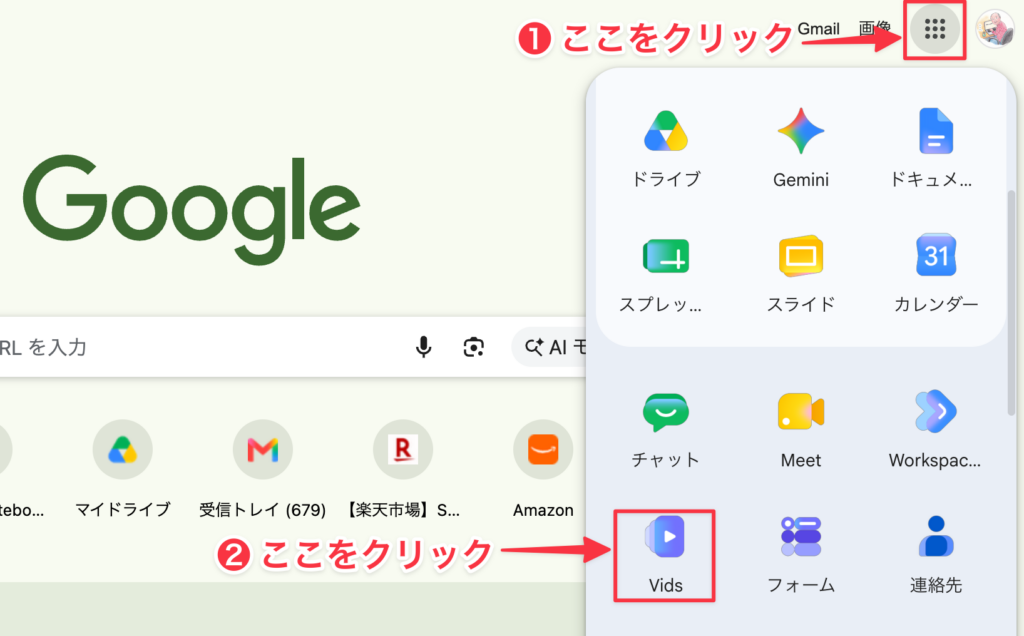
(2) Webブラウザで Vidsにアクセスする方法。

(3) Googleドライブからログインする方法
トップメニュー画面が開きます。
STEP 2:AIに動画の目的や元資料を入力する
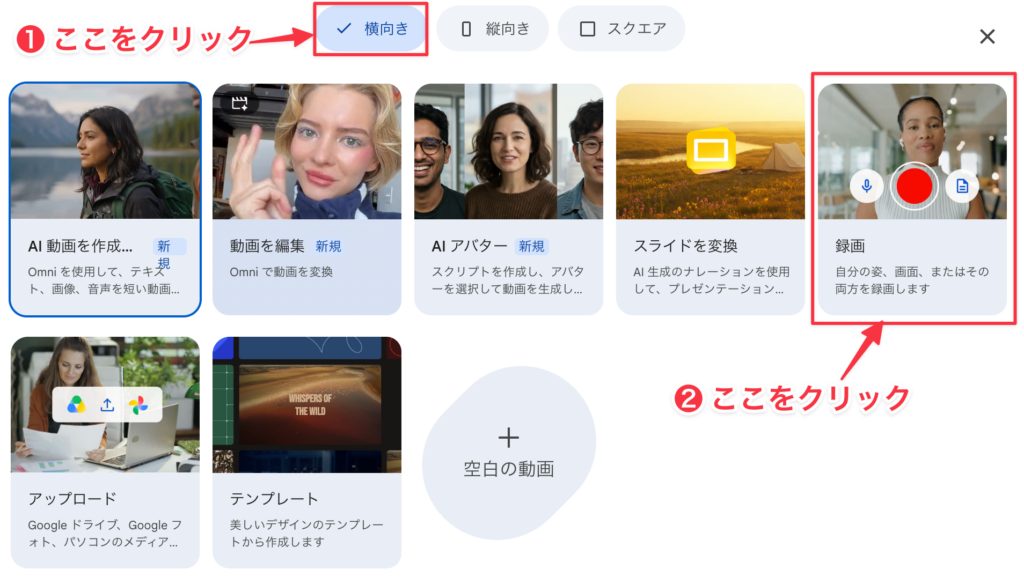
- 「横向き」「録画」を選択します。
- メニューの中から、生成する動画のサイズと目的を選択する
4. 事例1: スライド変換機能を使ったVidsの動画生成
- 新しい動画を作成する画面を表示し、画像メニューから「スライドを変換」を選択します。
- すでに作成済みのGoogleスライドを選択してアタッチします。
- これにより、AIが研究データやグラフ、テキストを正しく解釈し、動画のベースとして活用してくれます。
STEP 1 : Google Vidsのメニューからスライドを変換する:

STEP 2: Googleドライブ上のパワポスライドの読み込み

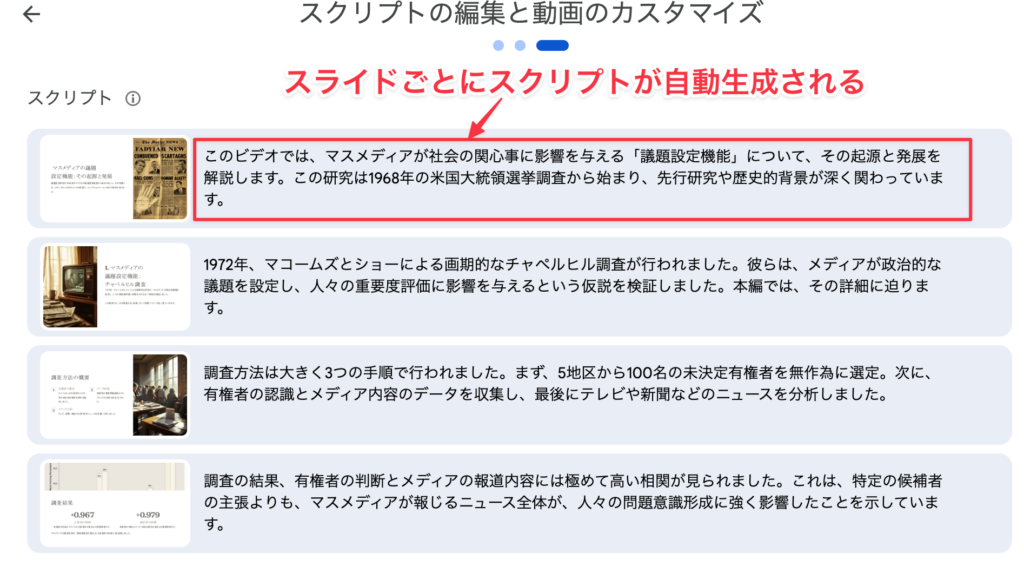
STEP 3: スクリプトの自動生成
すると、すべてのスライドのスクリプト(ナレーション用のテキスト)が自動的に生成されます。
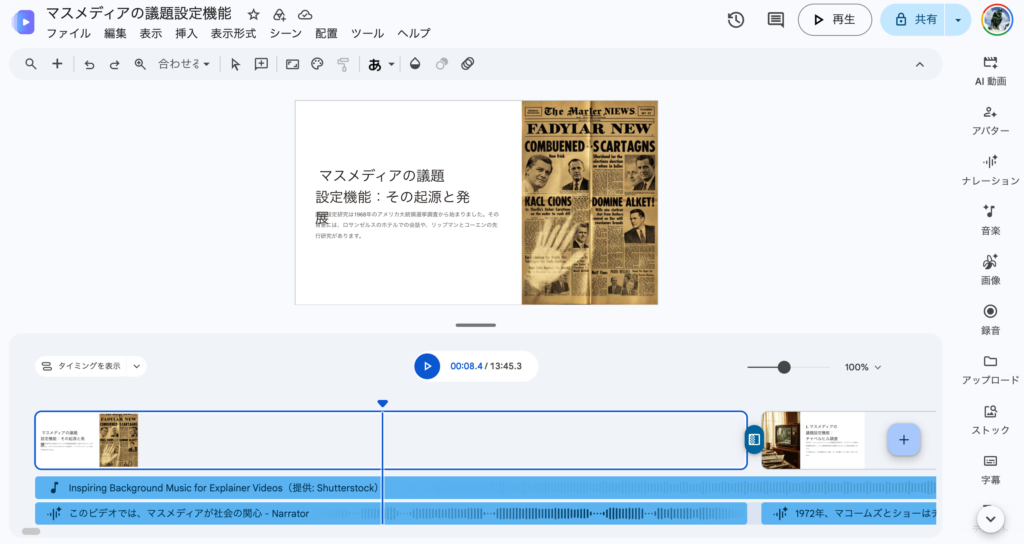
STEP4 : ドラフト動画の作成
次に、画面右下の「ドラフト動画を作成」ボタンをクリックすると、ナレーション付きの動画が完成します。
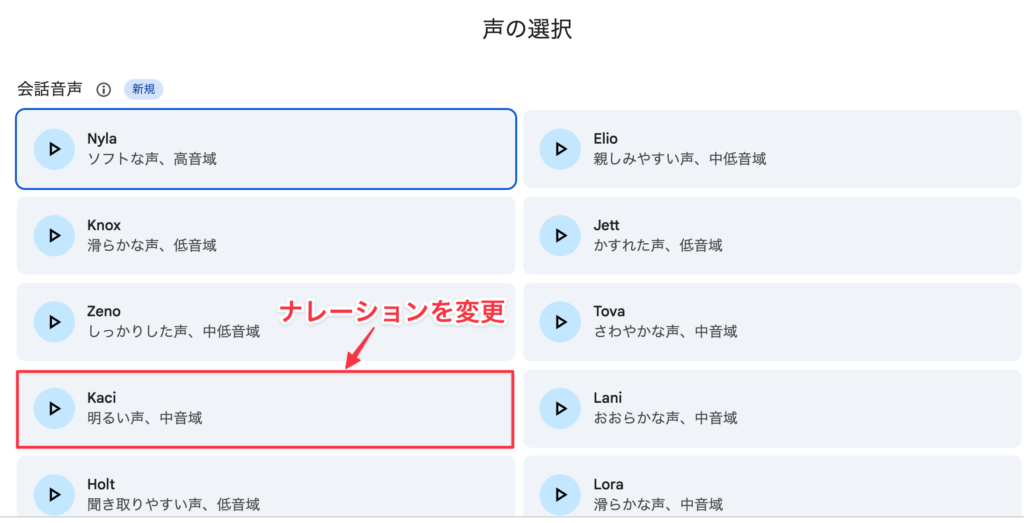
ナレーションの種類を自由に変えることができます。男性の声か女性の声か、声の質などを実際に聞いて選ぶことができます。
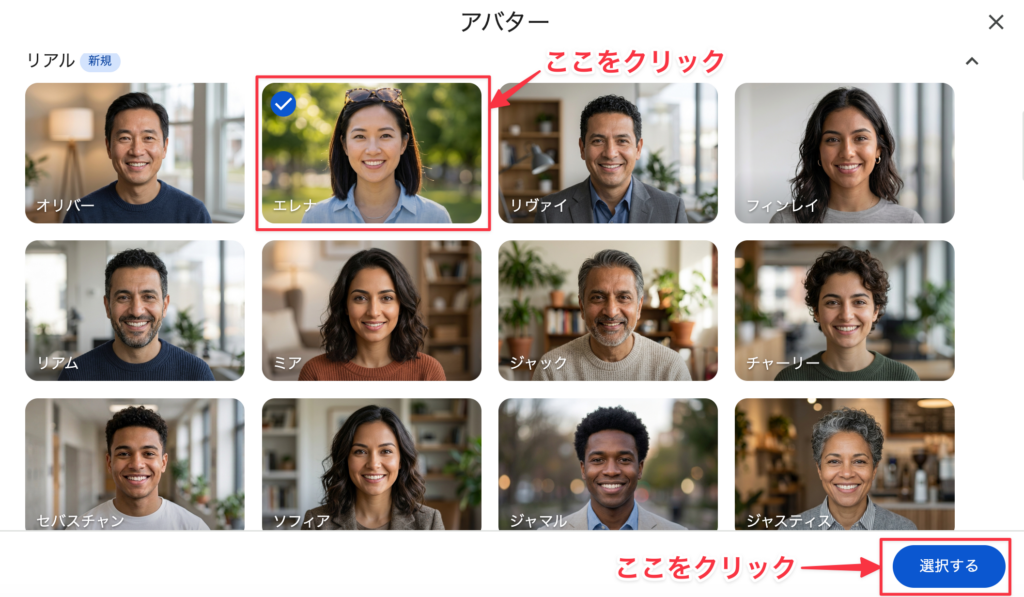
ナレーションを話しているアバターも、好きな人物を選ぶことができます。
/
(2) 自分の音声・映像の重ね合わせ
「Recording Studio」を使い、自分の声でナレーションを吹き込んだり、Webカメラの顔出し映像をスライド端に配置できます。
(3) 自動尺調整 (Auto-timing)
読み上げるナレーションの長さに合わせて、各スライド(シーン)の表示時間が自動でミリ秒単位で調整されます。
STEP 5 : YouTube動画にエクスポート
生成した動画をYouTube動画にエクスポートすることができます。

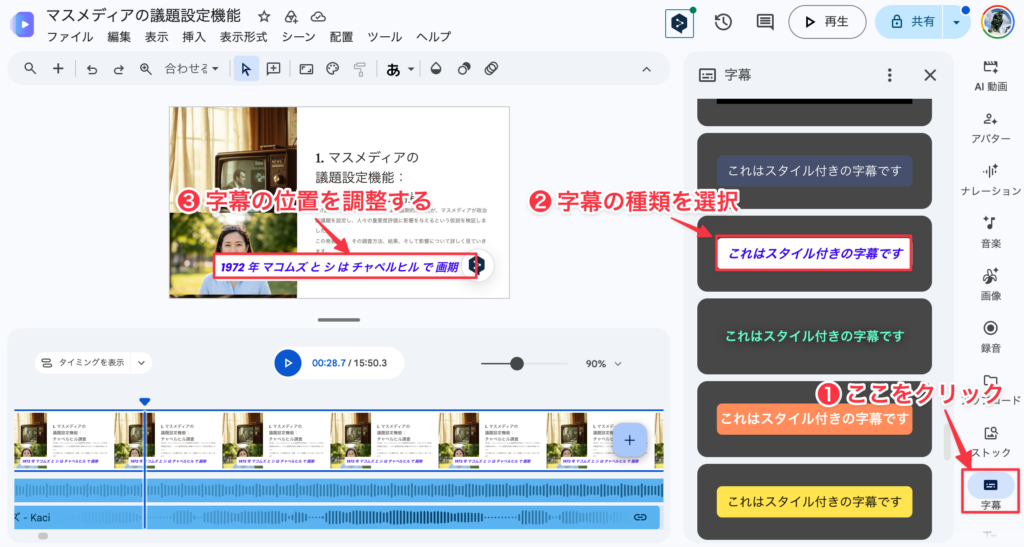
サイドに、それぞれのスライドにナレーションの字幕を入れます。ナレーションが自動的に字幕に変換されます。字幕テキストの種類や、スライドでの表示位置を調整することができます。
生成動画のYouTube:
生成した動画をYouTubeで再生したものです。動画の右上のCCマークをクリックすると、YouTubeの字幕を消すことができます。
5. 事例2:白紙から動画生成(ストーリーの展開)
Google Vids(グーグル ビズ)でAIの自動生成を使わず、白紙(ゼロ)から動画を作成する手順は以下の通りです。
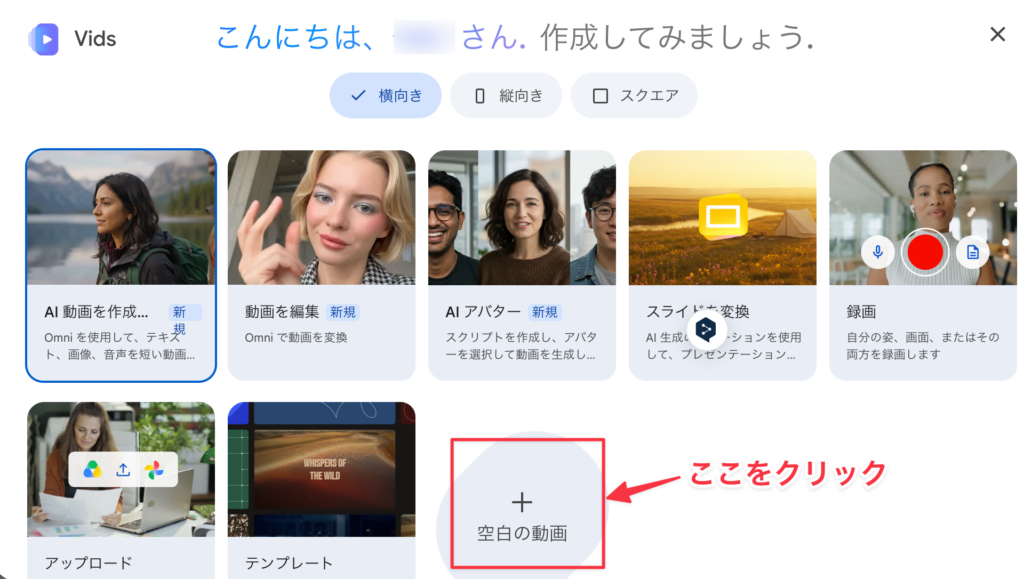
(1) Google Vids を起動して白紙で新規作成:
- Google ドライブ(
drive.google.com)を開き、画面左上の [+ 新規] > [Google Vids] を選択します。 - プロンプト入力(AI生成)の画面が表示されたら、右下の [白紙から開始] をクリックします。
(2) シーン(場面)のフレームを追加:
- 画面下のタイムライン領域にある [+ シーンを追加] をクリックして、動画の構成(導入・本編・まとめなど)に必要な数のシーンを作成します。
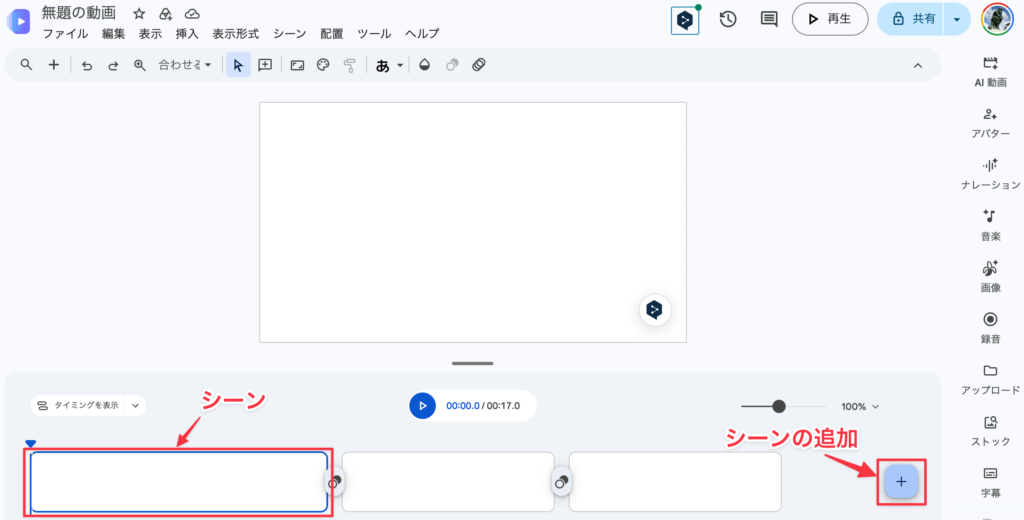
2. 各シーンの長さを変更したい場合は、タイムライン上のシーンの端をドラッグして調整します。
(3) テキストやメディア素材の配置:
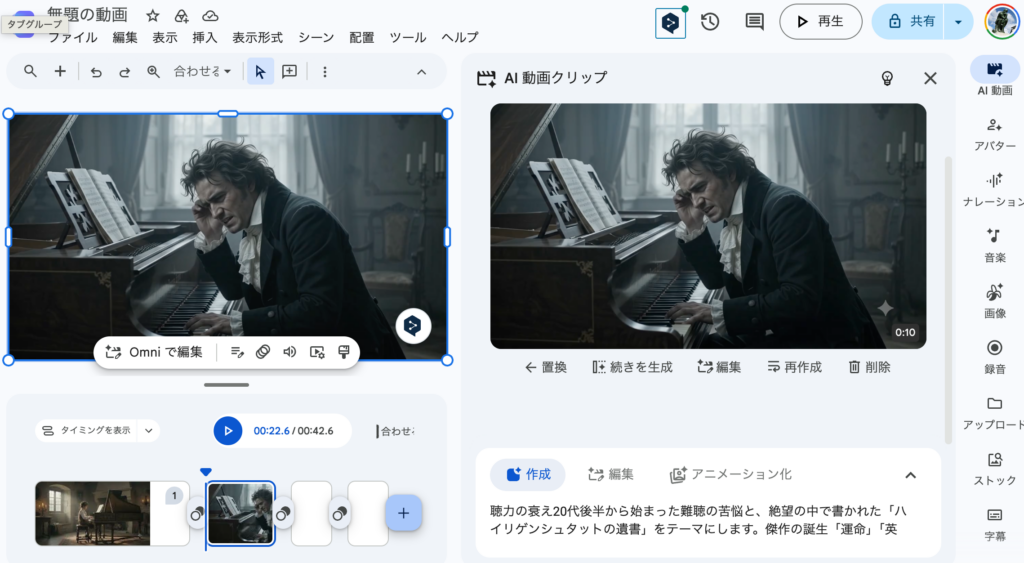
ここでは、例として、「ベートーヴェンの生涯」というテーマの動画を生成してみましょう。素材を得るために、Google Geminiで「Vidsを使って、ベートーヴェンの生涯に関する動画を生成する方法を教えてください」というプロンプトを入れてみます。すると、Vidsでのシーン構成案が示されますので、Vids画面の右サイドメニューの「AI動画」の「AI動画クリップ」欄にシーンごとに入力します。次の画像は、シーン1「誕生とボン時代 (1770 – 1792)」の動画クリップを示したものです。動画と同時に、ナレーションも自動的に挿入されます。

続いて、シーン2とシーン3を追加します。
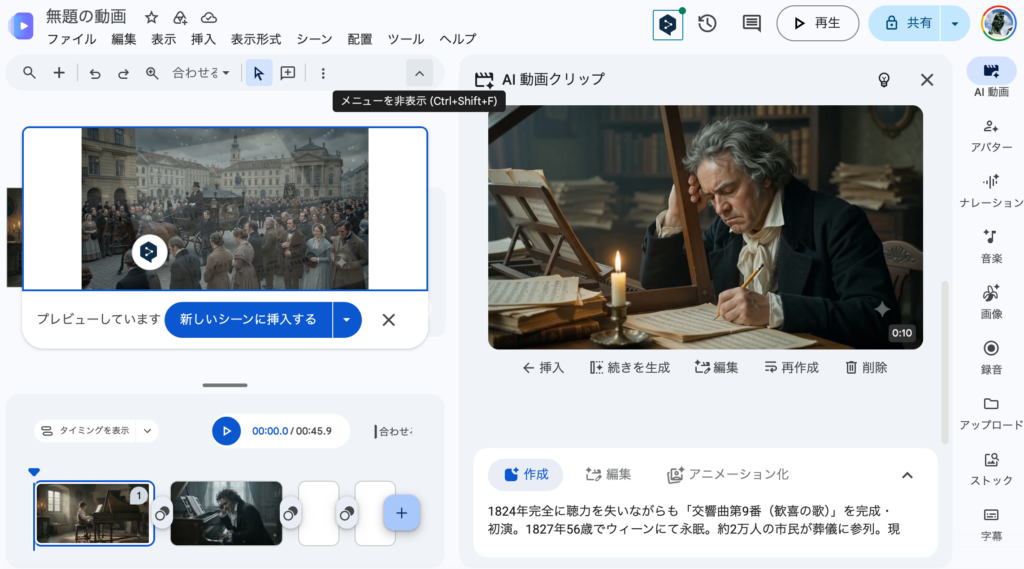
(4) アニメーションとトランジションの調整:
- 各要素(テキストや画像)の表示・非表示のタイミングをタイムライン上で個別にドラッグして調整します。
- シーンとシーンの間に切り替え効果(フェードやスライドなど)の [トランジション] を設定します。
(5) プレビュー確認と共有・エクスポート:
- 上部の 再生ボタン をクリックし、動画全体と音声のタイミングをプレビュー確認します。
- 問題がなければ、右上の [共有] ボタンでリンク共有するか、[ファイル] > [ダウンロード] から MP4 形式で動画を書き出します。
- ポイント: 白紙から作成する場合でも、最初に「台本(スクリプト)」を用意しておくと、各シーンへの素材配置やナレーション録音が非常にスムーズになります。
生成動画のYouTube:
「ベートヴェンの生涯(改訂版)」
6. 事例3:解説動画の作成(録画機能)
Google Vidsの録画機能(スタジオ機能・画面録画拡張機能)を使って、アプリの解説動画(チュートリアル)を効率よく作成する具体的な手順です。ここでは、Google Gemini の使い方の解説動画を作ってみます。
(1) 事前準備
- アプリと台本の用意
- 解説したいアプリ画面をあらかじめブラウザやウィンドウで開いておきます。
- 話す内容(スクリプト)をGoogle Documentに、シーンごとにメモしておきます。
- Vidsプロジェクトの作成
- ブラウザで vids.google.com にアクセスし、「空白の動画」または新規プロジェクトを作成します。
(2) 録画スタジオの起動
- トップメニュー画面にある「録画」をクリックします。

- 録画モードを次のいずれかから選択します:

- 画面とカメラ:画面右下などに自分の顔(ワイプ)を表示しながら解説したい場合
(3) 画面録画の開始
共有するタブを選択すると、そのタブの画面を共有することができます。ここでは、「Google Gemini」を選択して、「共有」ボタンをクリックします。
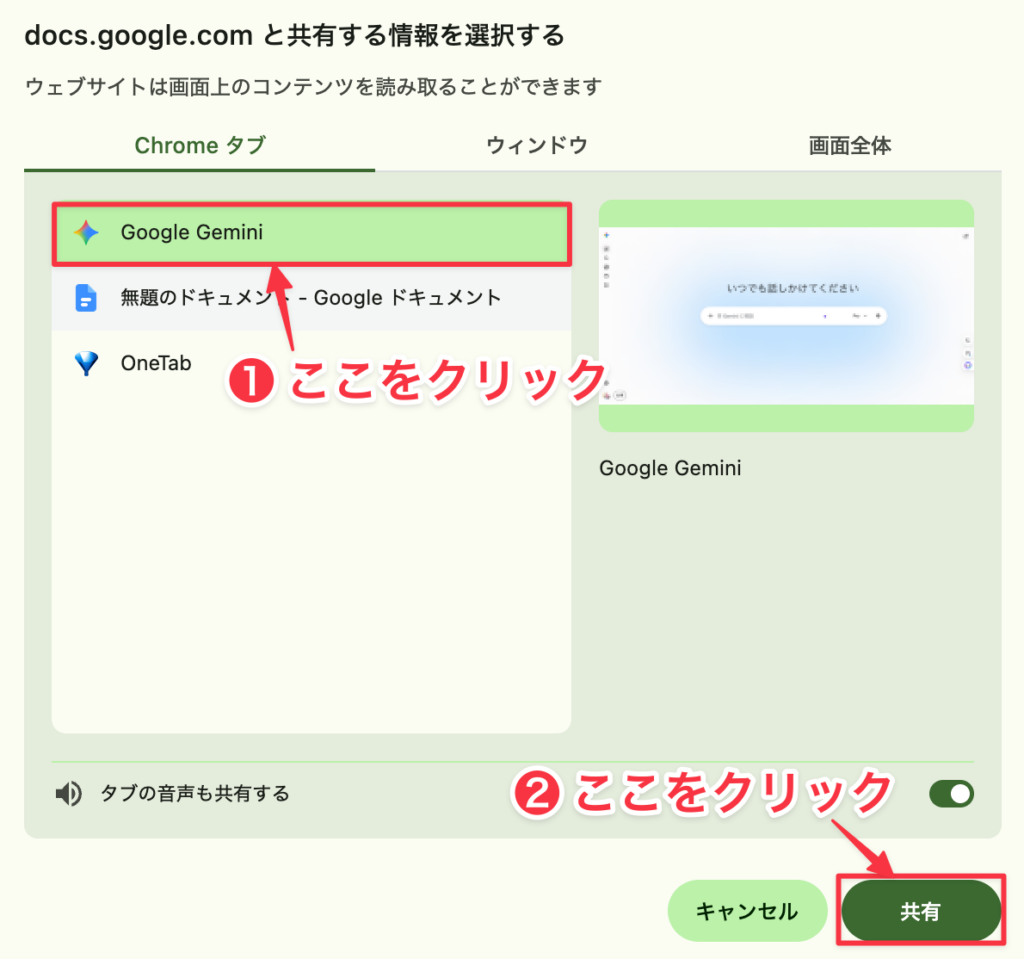
すると、Google Geminiの初期画面が表示され、右下に小さな録画ボタンの画面が表示され、画面録画が自動的に開始されます。画面を操作しながら、それに合わせて解説を入れていきます。
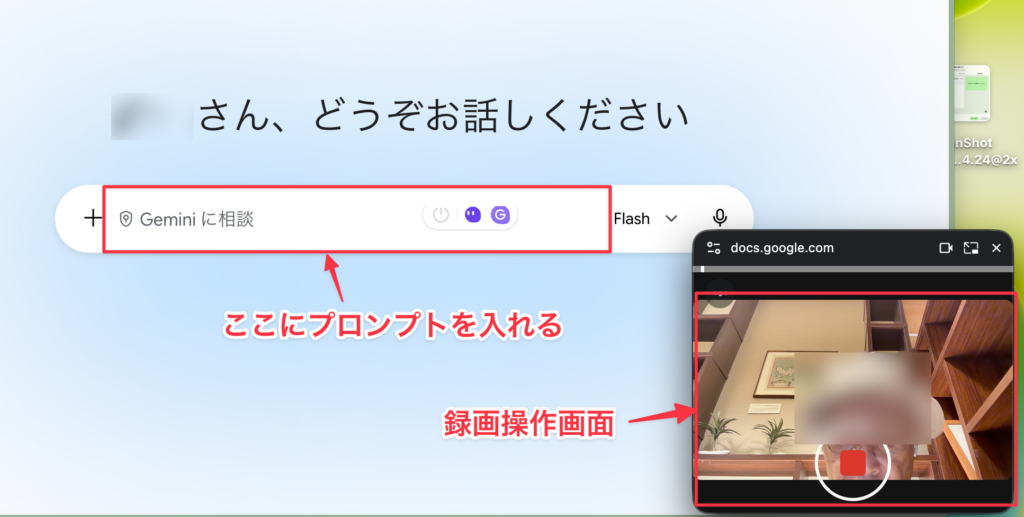
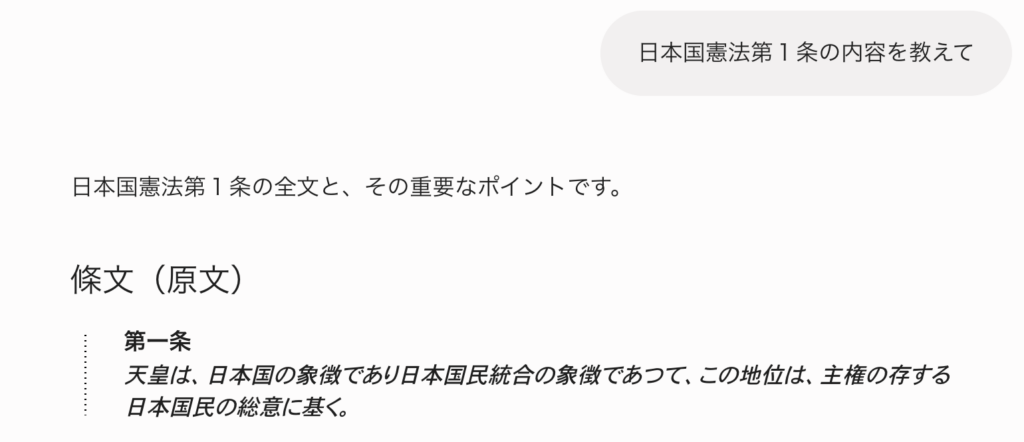
(4) 編集画面に録画を挿入する
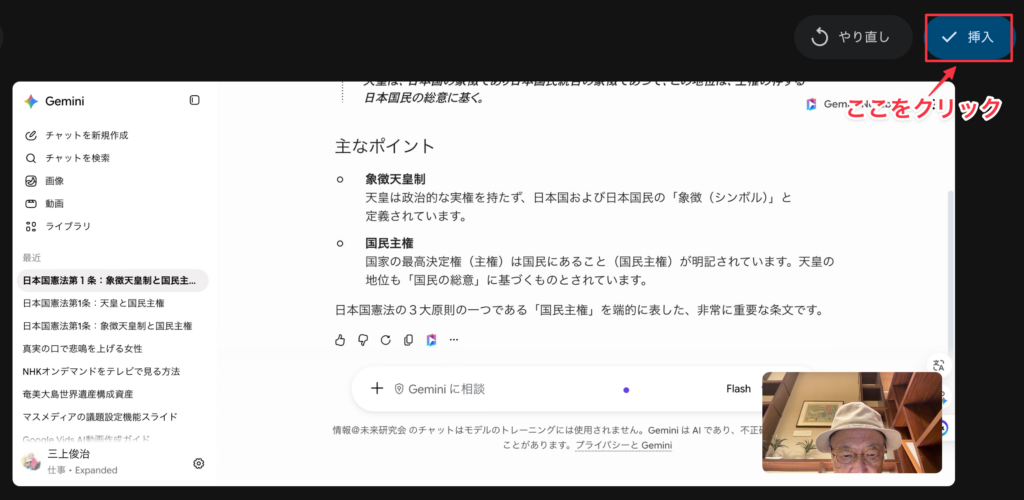
(5) 解説動画にアバターとナレーションを生成する
解説動画に、本人ではなく、AIのアバターとナレーションを挿入したいときは、右サイトバーから「アバター」を選びます。そして、ナレーション欄に、読ませたいナレーションをテキストで入力します。また、アバターの種類を変えたいときには、「変更」ボタンを押して、好きなアバターを選択します。
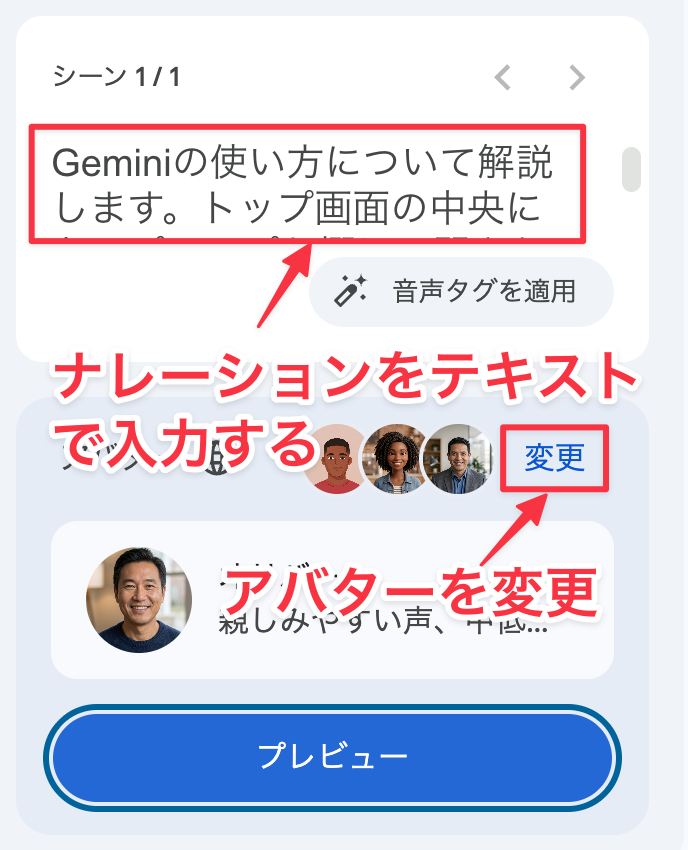
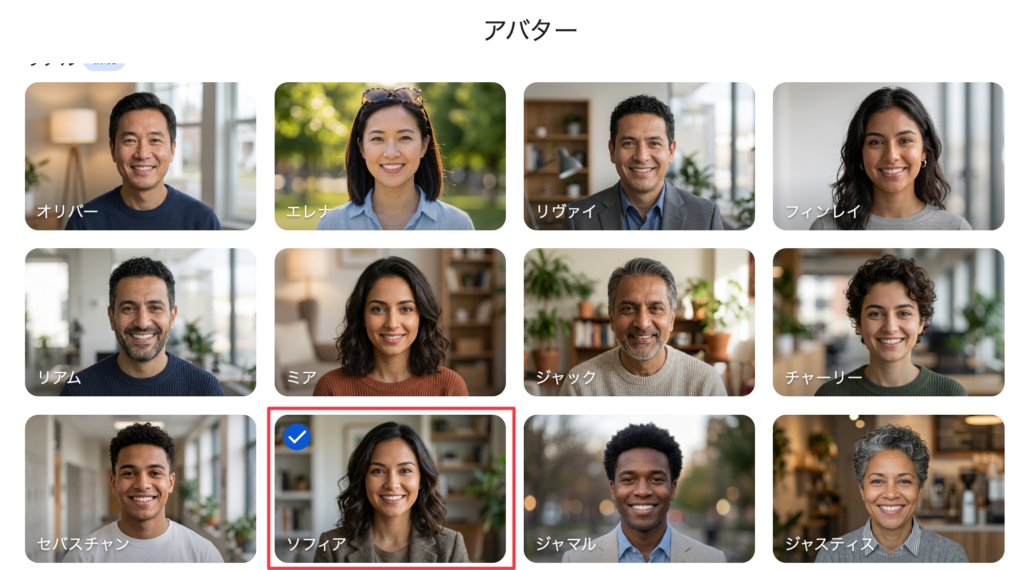
「プレビュー」ボタンをクリックすると、指定したアバターとナレーション音声が自動的に生成されます。
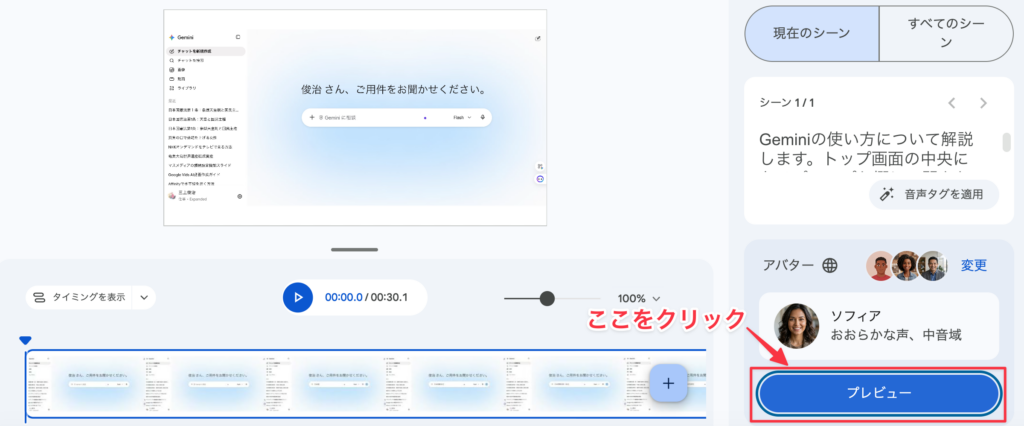
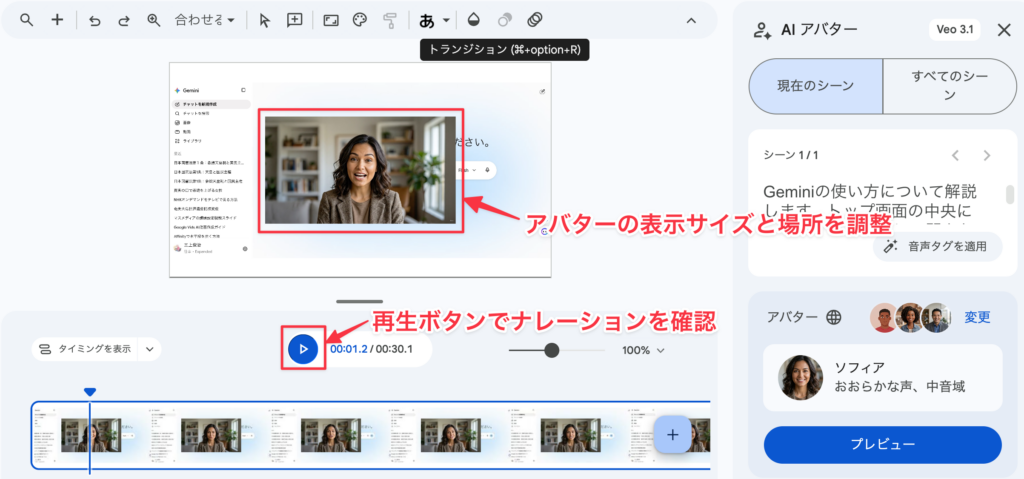
生成状況の表示が100%になったら、タイムラインのシーン画像にアバターが表示され、再生すると、アバターによるナレーションが表示されます。これでOKなら、画面上のアバターの表示サイズと表示場所をカーソルを使って調整します。
(6) 動画の共有とダウンロード
再生した動画が良ければ、これを共有したり、出力することができます。
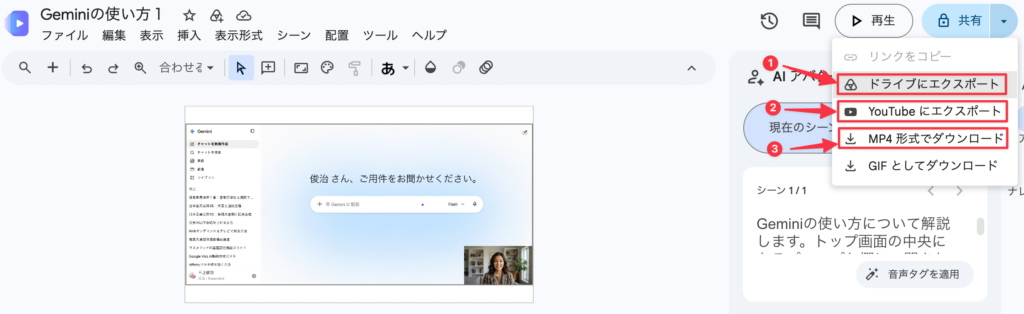
画面右上の「共有」ボタンをクリックすると、「Googleドライブにエクスポートする」「YouTubeにエクスポートする」「MP4形式でダウンロードする」などの出力形式を選ぶことができます。Googleドライブにエクスポートすれば、gvid形式で保存されますから、Vidsでの再編集を簡単に行うことができます。また、mp4形式のファイルでダウンロードすれば、Premiereなど他の動画編集ソフトで編集することができます。
最初のシーンを録画した画面をYouTubeにエクスポートすると、次のような動画になりました。
(7) シーンの追加録画、編集する方法
Google Vids で複数の画面録画(シーン)を順に撮影し、1つの動画に繋ぎ合わせて編集する流れは以下の通りです。
- 1つ目のシーン(カット)を録画して挿入する:
- タイムラインで1つ目のシーン(キャンバス)を選択します。
- サイドパネルの 「録画(Record)」 をクリックし、「画面」(または「カメラと画面」)を選択します。
- 録画画面を開き、1つ目の操作(シーン1)を録画して 「挿入(Insert)」 をクリックします。
2. 新しいシーン(枠)を追加する:
画面下部のタイムラインの右端にある 「+(シーンを追加)」 ボタンをクリックして、2つ目の録画を入れるための新しいシーン(コマ)を作成します。

3. 2つ目以降のシーンを録画する:
新しく追加したシーンを選択した状態で、右サイドバーの「録音」 メニューから次のパート(シーン2)を録画して挿入します。

「記録を開始」ボタンを押すと、共有する情報の選択画面が表示されますから、ここでは「Google Gemini」を選んで、「共有」ボタンをクリックします。

そこで、シーン1と同じように、シーン2の録画が始まります。録画を終えたら、「挿入」ボタンを押すと、シーン編集画面のタイムライン上に、録画の第2シーンが挿入されます。
4. シーン2にアバターとナレーションを挿入する
この作業は、シーン1と全く同じです。シーン1と同じアバターとナレーション音声を使いたい場合には、右サイトバーの「ナレーション」ボタンをクリックして、次に「ナレーションを挿入」ボタンをクリックすれば、シーン1と同じアバターが同じ音声でナレーションを入れてくれます。これなら、シーンごとにアバターを生成してもらう手間やコストが省ける上に、すべてのシーンに一貫した同じアバターとナレーションを生成することができます。シーン1とシーン2を合わせた解説動画をYouTube動画にエクスポートしたのが、下の画面です。
(8) タイムライン編集
- 順番の変更: タイムライン上のシーンをドラッグ&ドロップして並べ替えることができます。
- 不要部分のカット: 動画クリップの端をドラッグして長さを短縮するか、右クリックメニューの 「プレイヘッドでシーンを分割」 を使って前後を切り離し、不要な部分を削除することができます。。
(9) テロップ、テキストタイトル、BGMの追加
- テキスト挿入:右側メニューの「テキスト」から、「〇〇の使い方ステップ1」などの見出しや注釈テロップを追加します。
- 右側メニューの「テンプレート」から、さまざまなタイトルシーンを入れることができます。
- BGM・自動ナレーション:BGMを追加したり、声出しを行わない場合はAIテキスト読み上げ機能でナレーションを追加することもできます。右側メニューの「ストック」から、BGMを選んで挿入することができます。BGMの音声調整(音量、フェードイン、フェードアウト)をすることができます。
(10) トランシジョンの設定
・シーン間アイコンをクリック: 画面下部にあるタイムラインで、切り替えを入れたい2つのシーンの間にある「切り替えアイコン」をクリックします。
・効果を選択: 右側に表示される「トランジション」パネルから、フェード、スライド、ディゾルブなどの効果を選択します。マウスカーソルを合わせるとプレビューを確認できます。
・長さ(速度)の調整: パネル内のスライダーをドラッグし、アニメーションの再生時間を好みの速さに変更します。
以上の編集を行なった結果の完成動画は次のとおりです。
15-4 : Omni、Flow、Vidsの比較
Gemini Omni、Google Flow、Google Vidsは、いずれもGoogleが提供する動画関連AIツールですが、「対話型のマルチモーダル動画編集」「プロ向け映画・映像制作」「ビジネス向け動画共有・プレゼン」と、目的や想定ターゲットが明確に分かれています。
【Gemini Omni】 ─── 対話しながら動画を「編集・調整」するクリエイティブパートナー
【Google Flow】 ─── 高彩度な映画・ストーリー制作を行う「AI映画スタジオ」
【Google Vids】 ─── ドキュメント感覚でプレゼン・研修動画を作る「ビジネスツール」
- Gemini Omni(ジェミニ・オムニ)
- 概要: テキスト・画像・動画・音声を組み合わせて「会話しながら動画を作る・直す」ことができるマルチモーダルAIモデル(主力モデル: Gemini Omni Flash)。
- 特徴: 「3秒目の背景を夕方に変更して」「被写体のキャラクターは保ったままカメラを引きにして」といった追加指示を理解し、一貫性を保ちながら動画を対話形式で微調整できます。
- Google Flow(グーグル・フロー)
- 概要: 高品質な映像制作(ショートフィルム、クリエイティブ作品、PVなど)に特化したプロフェッショナル向けAIクリエイティブスタジオ環境。
- 特徴: 最先端の映像生成モデル(Veo 3.1やGemini Omni)をバックエンドで稼働させ、カメラワークの指定、複数シーンの構築、カット間のシームレスな接続など、本格的なストーリーテリングが可能です。
- Google Vids(グーグル・ビズ)
- 概要: Google Workspaceエコシステム(ドキュメントやスライド等)に統合された、ビジネス・教育向けの動画制作・編集アプリ。
- 特徴: AIが構成案(スクリプト)を作成し、AIナレーションやストック素材、アバターを組み合わせることで、専門的な動画編集スキルがなくても短時間で解説動画やプレゼン動画を作成できます。
(1) 概要・主な特徴
- Gemini Omni(ジェミニ・オムニ)
- 概要: テキスト・画像・動画・音声を組み合わせて「会話しながら動画を作る・直す」ことができるマルチモーダルAIモデル(主力モデル: Gemini Omni Flash)。
- 特徴: 「3秒目の背景を夕方に変更して」「被写体のキャラクターは保ったままカメラを引きにして」といった追加指示を理解し、一貫性を保ちながら動画を対話形式で微調整できます。
- Google Flow(グーグル・フロー)
- 概要: 高品質な映像制作(ショートフィルム、クリエイティブ作品、PVなど)に特化したプロフェッショナル向けAIクリエイティブスタジオ環境。
- 特徴: 最先端の映像生成モデル(Veo 3.1やGemini Omni)をバックエンドで稼働させ、カメラワークの指定、複数シーンの構築、カット間のシームレスな接続など、本格的なストーリーテリングが可能です。
- Google Vids(グーグル・ビズ)
- 概要: Google Workspaceエコシステム(ドキュメントやスライド等)に統合された、ビジネス・教育向けの動画制作・編集アプリ。
- 特徴: AIが構成案(スクリプト)を作成し、AIナレーションやストック素材、アバターを組み合わせることで、専門的な動画編集スキルがなくても短時間で解説動画やプレゼン動画を作成できます。
(2) 使い方(ワークフロー)の比較
| ツール | 基本的な操作の流れ | 主な用途 |
| Gemini Omni | 1. 基準となる動画・画像・プロンプトを入力 2. 生成された動画に対し「〇〇を変更して」と会話で修正 3. キャラクターや物理法則を保ったまま理想の動画に仕上げる | カジュアルな短尺動画作成、会話による動画のインタラクティブな修正・試行錯誤 |
| Google Flow | 1. シーン(タイムライン)を作成し、カメラワークやスタイルを指定 2. 高精度モデル(Veoなど)を選んで映像カットを生成 3. エフェクト適用やアップスケーリング(1080p/4K)を行って統合 | AI映画、広告映像、ミュージックビデオ、ストーリー性のある映像制作 |
| Google Vids | 1. プロンプトや既存資料から「構成案(タイムライン)」を自動生成 2. スライド感覚で文字やストック素材、アバターを配置 3. AIナレーション音声を付けて社内やチームに共有 | 営業資料の動画化、社内研修マニュアル、進捗報告、プレゼンテーション |
(3) 公開時期・料金プラン・クレジットの仕組み
① 公開時期
- Google Vids: 2024年4月(Google Cloud Next ’24にて発表され、Workspace向けに順次ロールアウト)
- Google Flow: 2025年5月(Google I/O 2025にて正式発表・提供開始)
- Gemini Omni: 2026年5月(Google I/O 2026にて発表された最新のマルチモーダルモデル)
② 料金プランとアクセス権
- Gemini Omni:
- Gemini アプリの「Videos(動画)」タブやGoogle Flow等から利用可能。
- Google AI Paidプラン(Plus / Pro / Ultraなど)の加入者が対象。
- Google Flow:
- 無料体験枠あり(非契約者でも1日50クレジット付与)。
- 本格利用はGoogle AIプラン(Plus / Pro / Ultra)に組み込まれており、プランに応じたクレジットが毎月付与されます。
- Google Vids:
- Google Workspace(Business/Enterprise等)および個人用Googleアカウントで広く利用可能。基本機能は無料〜標準月額プランに含まれます。
③ クレジットの仕組み比較
| ツール | クレジットの仕組み | 料金プラン別の消費目安・付与量 |
| Gemini Omni | 生成および「編集(会話での修正)」ごとにクレジットを消費 | • 4秒生成: 15 credits • 動画の会話編集: 一律 40 credits ※Google FlowやGeminiアプリ内で共通消費 |
| Google Flow | モデル・解像度・生成秒数に応じたTier制消費 ※未使用分の翌月繰り越し不可 | • Free: 50 credits / 日(無料枠) • Plus: 200 credits / 月 • Pro ($19.99/月): 1,000 credits / 月 • Ultra ($249.99/月): 25,000 credits / 月 (例: Veo 3.1 Lite生成で10 credits、Omni編集で40 credits消費) |
| Google Vids | 月間プール型(AI機能の利用量に基づく) | 一般のGoogleアカウントやWorkspaceの基本枠内でプール型付与。スライド生成やAI音声出力などのリクエストごとに消費。 |
第16章:Gemini Notebookによるアウトプット革命
16-1 : 従来の生成AIとの違い
Gemini Notebookは「提示した資料の理解・分析(グラウンディング)」に特化したリサーチ・学習用ワークスペースであり、膨大な知識をもとに「アイデア創出や成果物作成」を行う従来の汎用AI(ChatGPTやGeminiアプリ)とは目的と構造が基本的に異なっています。
| 比較項目 | Gemini Notebook | 汎用AI(ChatGPT / Geminiアプリ) |
| 役割・目的 | 指定した資料の深掘り・整理・構造化(理解のAI) | ゼロからの発想・対話・文章/コード生成(創造のAI) |
| 回答の根拠 | ユーザーが指定したソース(PDF、Googleドライブ等)に厳密に限定 | モデルの事前学習データ + Web検索(広範囲) |
| 情報の正確性 | 根拠(引用元箇所)を直接提示し、誤情報を大幅抑制 | 根拠の特定が難しく、ハルシネーション(嘘)のリスクあり |
| 固有の機能 | 音声/動画オーバービュー、スライド、クイズ、暗記カード自動生成 | 画像/動画生成、コード実行、外部アプリ連携、カスタムGPTs/Gems |
主な3つの違い
1. 徹底されたグラウンディングと根拠の可視化
汎用AIは膨大な知識を持つ反面、知識を補完しようとして事実と異なる回答(ハルシネーション)を出すことがあります。一方、Gemini Notebookはアップロードした特定資料(PDF、URL、Googleドキュメントなど)のみを情報源とする「グラウンディング」が徹底されており、回答の根拠となった原文の位置へワンタップでジャンプできます。
2. 理解・インプットを助ける独自アウトプット
テキストで対話する汎用AIに対し、Gemini Notebookは読み込ませた資料をもとに、ポッドキャスト風の「音声オーバービュー(2人のAIによる対話解説)」や要約動画、スライド、インフォグラフィック、練習クイズなどを自動作成できます。多角的なメディア形式で効率的にインプットできる点が特徴です。
3. プロジェクト単位の資料蓄積と横断分析
1対1のスレッド会話が中心の汎用AIと異なり、Gemini Notebookはプロジェクト(ノートブック)ごとに大量の資料を登録し、それらを横断して比較・分析できます。
使い分けの目安
- Gemini Notebook: 論文や文献資料の読解、社内規定やマニュアルの検索、議事録やインタビュー記録の整理、競合資料の比較など「既存資料の正確な把握と整理」
- 汎用AI: 企画案の壁打ち、メールやブログの文章作成、プログラミング、日常の疑問解決など「ゼロからのアイデア・成果物作成」
16-2 : ノートブックの作成とソースの入力
Gemini Notebook(旧NotebookLM)では、「ノートブックを作成し、そこに分析・要約したいソース(情報源資料)を取り込む」ことが作業の起点となります。具体的な手順と対応しているソースの形式について解説します。
1. ノートブックの作成手順
- Gemini NotebookにアクセスするブラウザでGemini Notebook(notebooklm.google.com)にアクセスし、Googleアカウントでログインします。
- 新規ノートブックを作成するホーム画面にある 「+ 新規ノートブック」(または
+ 新規作成)ボタンをクリックします。
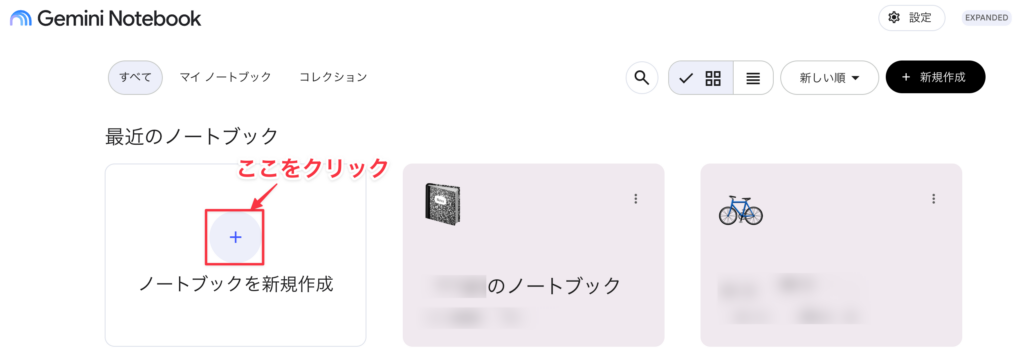
- 「ソースの追加」画面の立ち上がりノートブックを作成すると、自動的に「ソースを追加」するモーダル(ポップアップ画面)が表示されます。※初回アクセス時やノートブック作成直後は、必ずこのソース選択画面からスタートします。
2. ソース(資料)の入力・追加方法
ノートブック内には最大50個までのソースを登録できます。追加できる方法(入力タイプ)は主に 4つ あります。
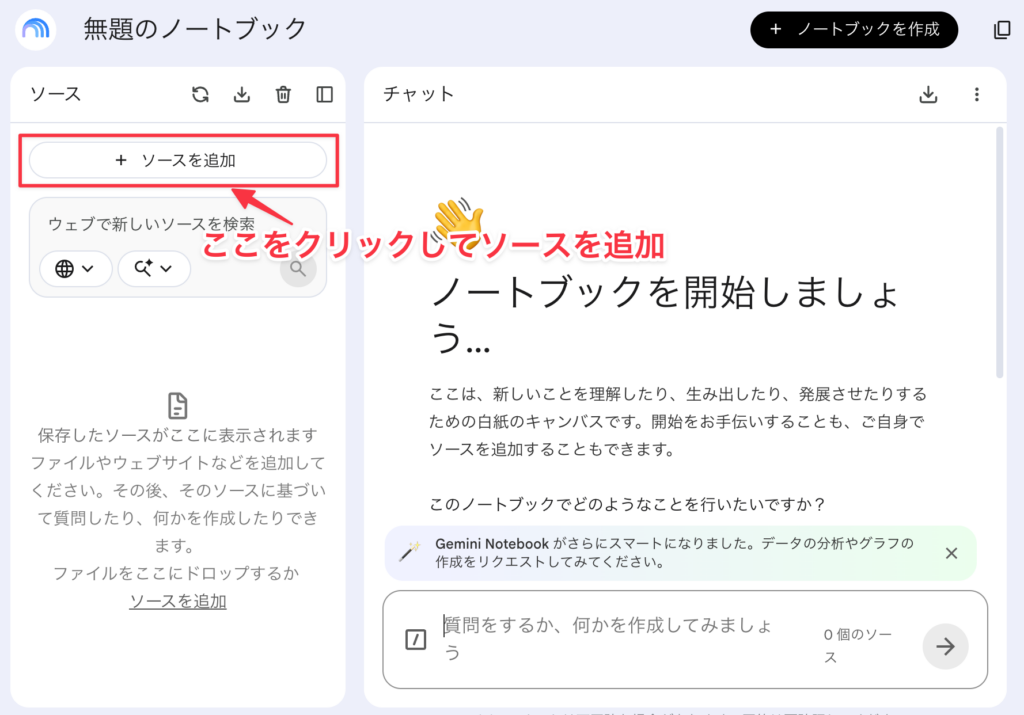
① パソコンからのアップロード(ファイル選択)
ローカル環境にあるファイルを直接ドラッグ&ドロップするか、ファイルブラウザから選択して追加します。
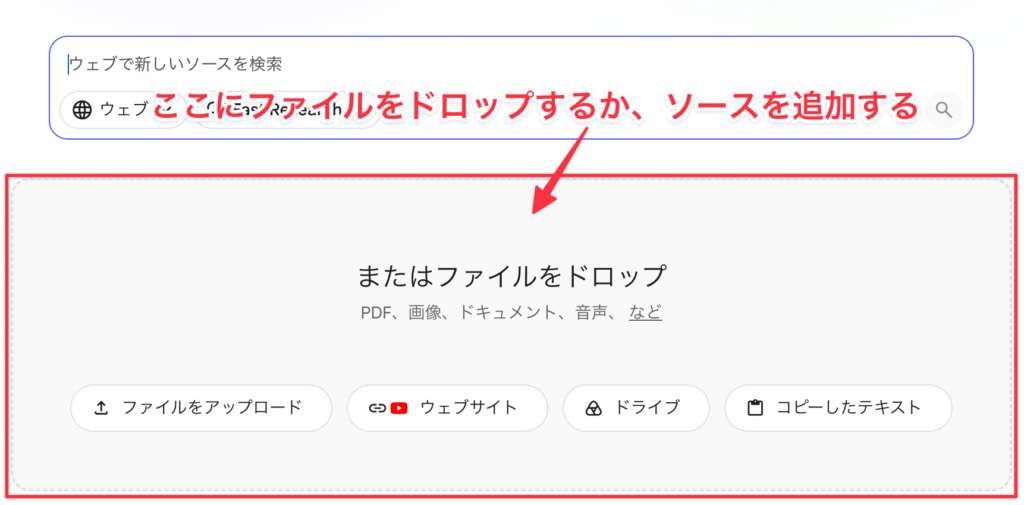
- 対応フォーマット:
- PDFファイル (
.pdf) - テキストファイル (
.txt) - Markdownファイル (
.md) - 音声ファイル (
.mp3,.wavなど) ※音声文字起こし機能により講義や会議の録音も読み込めます。
- PDFファイル (
② Google ドライブ連携
自分のGoogleドライブ内にあるファイルをシームレスに取り込みます。
- 対応フォーマット:
- Google ドキュメント
- Google スライド
③ リンク(URL)の指定
ウェブ上のコンテンツのURLを貼り付けて取り込みます。
- ウェブサイト(Webページ): 記事やニュース、ニュースリリースなどのURLを入力すると、ページ内のテキストを抽出します。
- YouTube動画: YouTubeの動画URLを貼り付けると、字幕データ(文字起こし)を取り込んで内容を解釈します。※動画そのものではなく、字幕テキストをもとに分析されます。
④ テキストの直接貼り付け(コピー&ペースト)
- クリップボードにあるテキストをそのまま貼り付けてソース化できます。
- メール本文、メモ書き、簡単なドラフト文章などをパッと取り込みたいときに便利です。
3. ソース追加後の管理とポイント
- 後からソースを追加したい場合ノートブック画面の左側(または左上)にあるパネルに 「+ ソースを追加」 ボタンが常駐しています。作業途中でもいつでも新しい資料を追加可能です。
- 参照させるソースの切替(チェックボックス)追加したソースにはそれぞれチェックボックスが付いています。「今回の質問は資料Aと資料Bだけを対象にしたい」という場合は、一時的に資料Cのチェックを外すことで、AIが参照する範囲をコントロールできます。
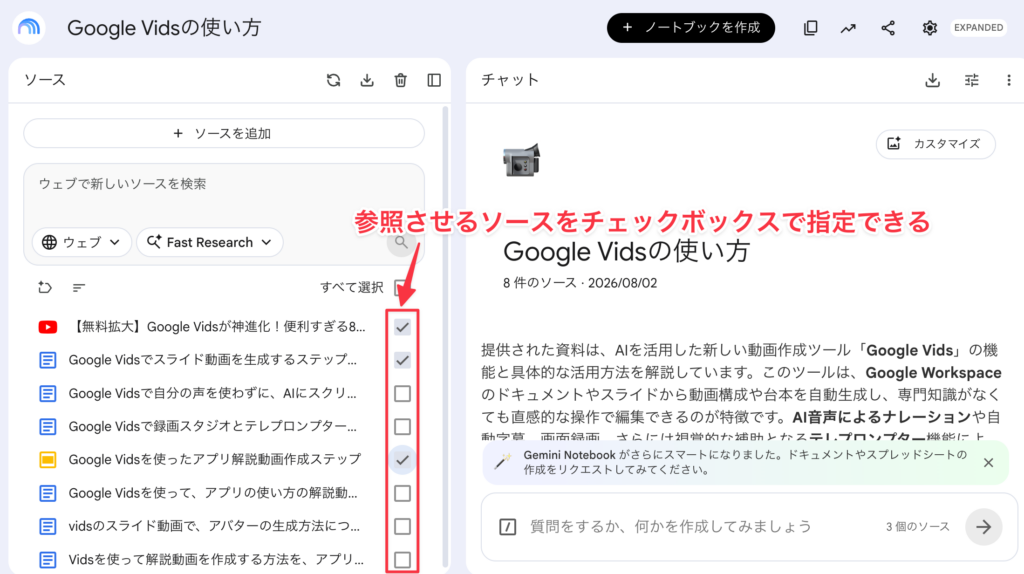
- ソースガイドの活用:取り込んだソースをクリックすると、その資料単体の要約やキーポイント(ソースガイド)が自動生成され、中身をざっくり把握するのに役立ちます。
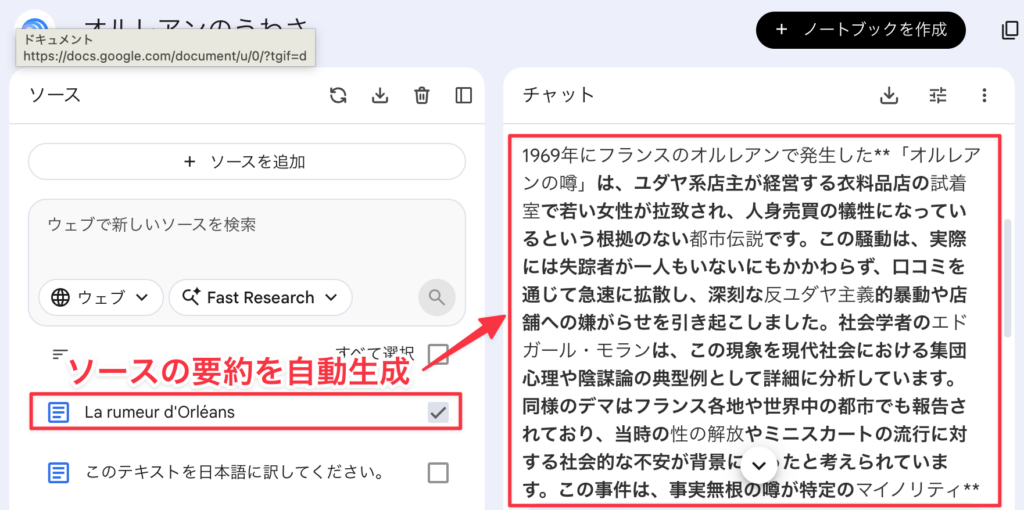
16-3 : Googleドライブとの連携
Gemini Notebook(NotebookLM)とGoogleドライブを連携させると、パソコンへファイルをダウンロード・再アップロードする手間がなくなり、クラウド上の最新資料を直接AIに読み込ませることができます。
1. Googleドライブとの基本連携手順
連携の操作は非常にシンプルで、わずか3ステップで完了します。
- ノートブックを作成(または開く)
- Gemini Notebookのホーム画面で 「+ 新規ノートブック」 をクリックします。
- 既存のノートブックに資料を追加したい場合は、左側パネルの 「+ ソースを追加」 をクリックします。
- ソース選択画面で「Google ドライブ」を選択
- ポップアップ表示される「ソースの追加」画面で、「Google ドライブ」 のアイコンを選択します。
- (初回のみ)Googleアカウントへのアクセス許可を求められた場合は、画面の指示に従って承認します。
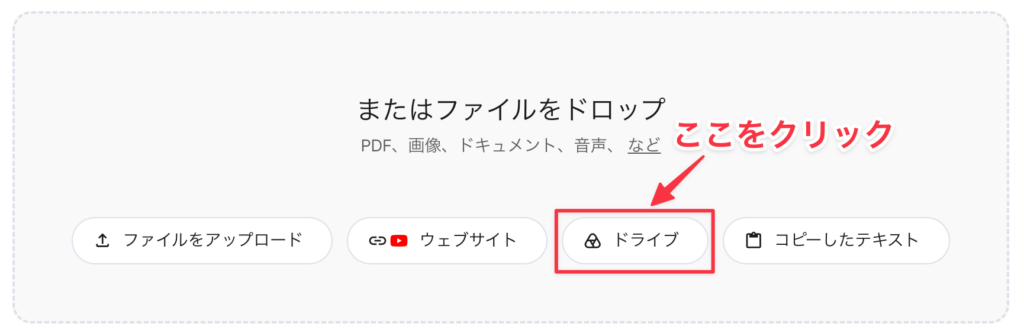
- 連携したいファイルを選んで「挿入」
- ドライブ内のファイル一覧が表示されるので、分析したい資料にチェックを入れます。
- 右下の 「挿入」(インポート)ボタンをクリックすると、AIへの読み込みが開始されます。
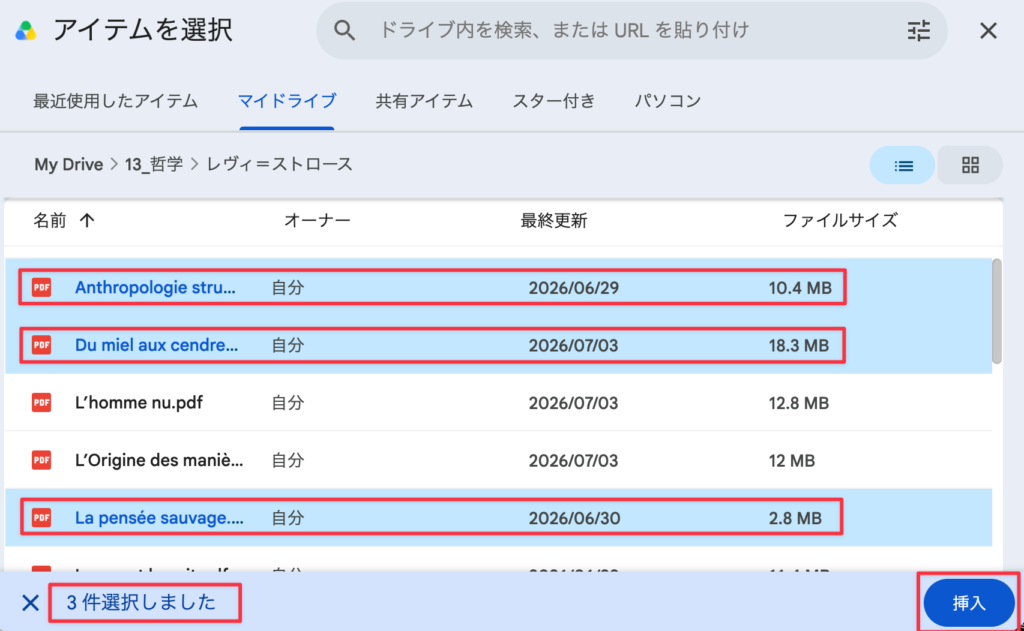
2. 対応しているドライブ内のファイル形式
Googleドライブ連携では、主に以下のファイル形式を取り込むことができます。
- Google ドキュメント(テキスト文書、議事録、マニュアルなど)
- Google スライド(プレゼン資料、授業用スライドなど)
- Google スプレッドシート(表データ、集計資料など)
- PDFファイル / テキストファイル(ドライブ上に保存されているPDF等)
3. ドライブ連携を使いこなすための重要ポイント
① 原本ファイルの編集と「自動同期・更新」
ローカルからアップロードしたファイルは変更できませんが、Googleドライブ経由で取り込んだファイル(ドキュメントやスライドなど)は、ドライブ側の原本を更新した後にNotebook側で同期させることができます。
- ドライブ側のドキュメント内容を書き換えた場合、Notebook画面のソースパネルに 「クリックして Google ドライブと同期」 などの更新案内が表示されます。
- そのボタンをクリック(または手動同期)することで、ノートブック内のAIも即座に最新情報を参照できるようになります。
② 閲覧権限とセキュリティ
- 元の権限の継承: Googleドライブ上で共有権限を持っているファイルのみ連携可能です。
- ノートブック共有時の注意: 他のユーザーにNotebookを共有した場合、相手も同じドライブファイルへのアクセス権限を持っていないと、該当ソースを参照できない仕様になっています。
- データ保護: Google Workspaceアカウント(学校や法人用アカウント)を利用している場合、ドライブから読み込ませたデータがAIの学習(モデルのトレーニング)に二次利用されることはありません。
16-4 : コレクションによるNotebookの階層管理
Gemini Notebook(NotebookLM)における「コレクション」機能は、増えすぎたノートブックをプロジェクトやトピックごとにまとめるフォルダのような階層整理・グループ化機能です。ノートブックが増えて画面が散らかるのを防ぎ、目的のプロジェクトへ素早くアクセスできるように設計されています。
Gemini Notebookの基本構造は、以下のような階層(レベル)で情報を整理できます。
【レベル 1:コレクション(フォルダ)】
 └── 【レベル 2:ノートブック(テーマ・プロジェクト)】
└── 【レベル 3:ソース(資料)&メモ】・コレクション(最上位): 「文学」「メディア研究」「海外旅行」など、大きな分類枠を作成します。
・ノートブック(中位): 「夏目漱石」「議題設定研究」「スイス・アルプス」など、具体的なテーマごとに切り分けます。
・ソース&メモ(最下層): ノートブックの中にPDFやGoogleドライブ資料などのソースを取り込み、対話を行います。
コレクションの作成・登録手順
- コレクションを新規作成する
- NotebookLMのトップページ(ノートブック一覧画面)を開きます。
- サイドメニューや画面上部にある 「コレクションの追加・作成」 アイコン(
+マーク)をクリックします。
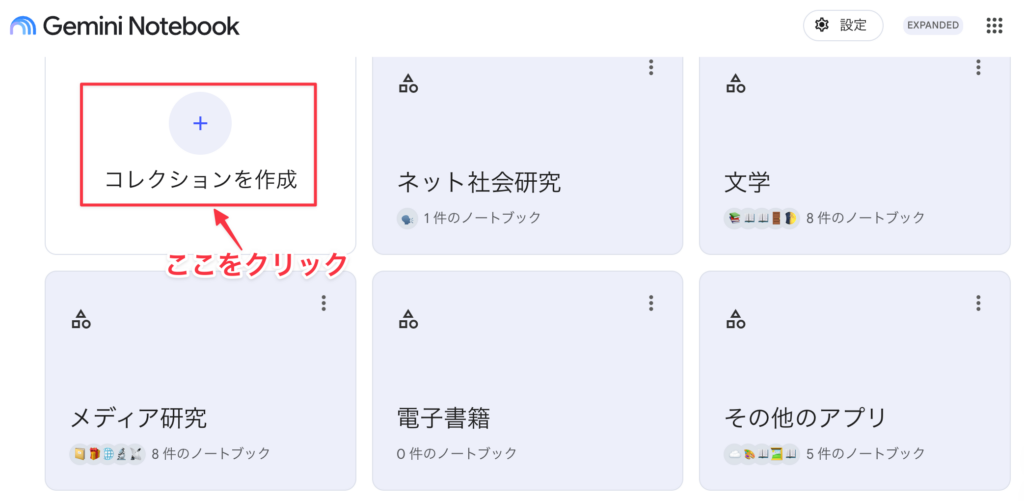
- 「海外旅行」「社会心理学」など、分類したい名前を入力して保存します。
- ノートブックをコレクションに分類・移動する
- ドラッグ&ドロップ: 作成済みのノートブックカードを目的のコレクションへドラッグして移動します。
- メニュー操作: ノートブックカードの右上にある「…(メニューアイコン)」をクリックし、
コレクションへ移動を選択して割り当てます。
- コレクション内での閲覧と切り替え
- サイドパネルから特定のコレクションを選択すると、そのグループに属するノートブックのみが絞り込まれて表示されます。
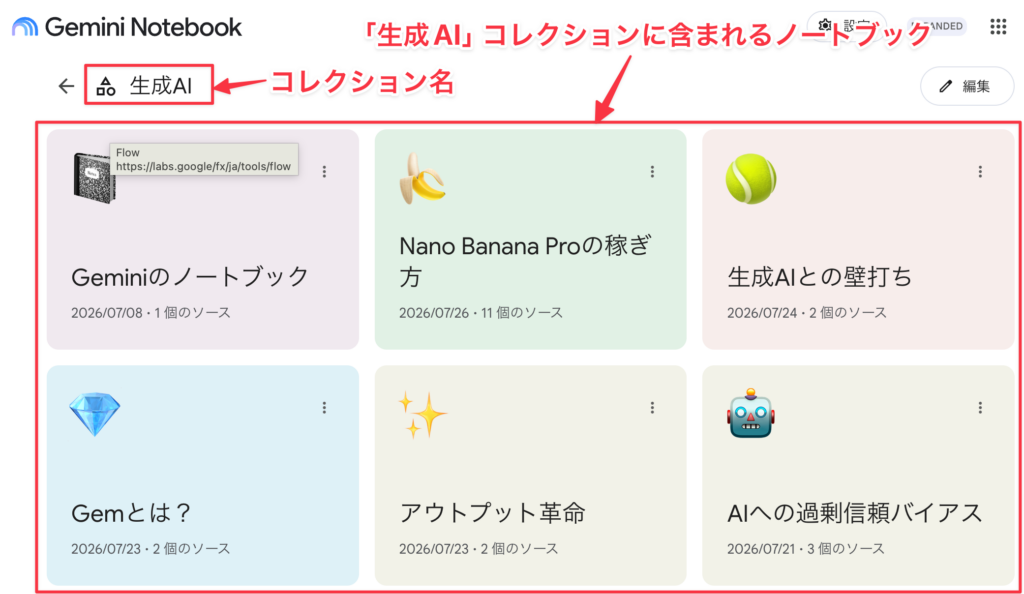
効果的な管理・運用テクニック
- プロジェクトのフェーズ別に分類
- 例:「
進行中」「完了(アーカイブ)」「ナレッジベース」といった状態(ステータス)ごとにコレクションを作成すると、作業中のノートブックに集中できます。
- 例:「
- 1つのノートブックに資料を詰め込みすぎない
- ノートブック内にも最大50個のソースを登録できますが、テーマが異なる資料を混在させるとAIの精度(検索性)が低下する場合があります。
- 「大テーマ=コレクション」「小テーマ=ノートブック」と細かく分けることで、精度と整理効率の両方を高められます。
16-5 : スタジオ機能の活用
Gemini Notebookの「スタジオ(Studio)」は、取り込んだソース資料をもとに音声・動画・スライド・図解など多様な形式のアウトプットを自動生成・編集できる画面右側の専用パネルです。
基本の使い方(5ステップ)
STEP1 ソースを選択する:ノートブック左側のパネルで、作成の材料にしたい資料(PDF、Googleドキュメント、YouTube等)にチェックを入れます。
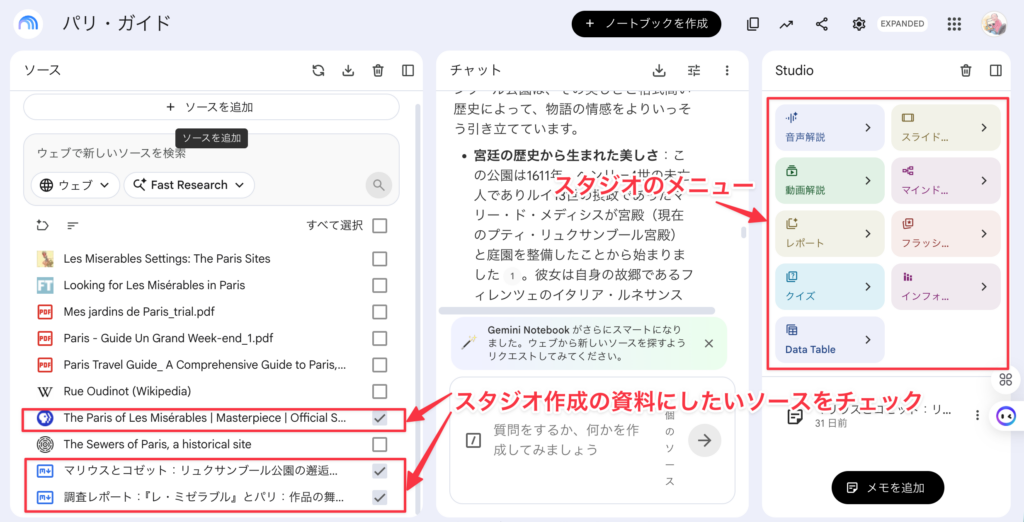
STEP2 「Studio」パネルを開く : 画面右側にある「Studio」タブを選択します。
STEP3 作成したいコンテンツの種類を選ぶ : 「音声解説」「スライド資料」「クイズ」など、目的に合ったフォーマットを選択します。ここでは、「音声解説」を選んでみます。
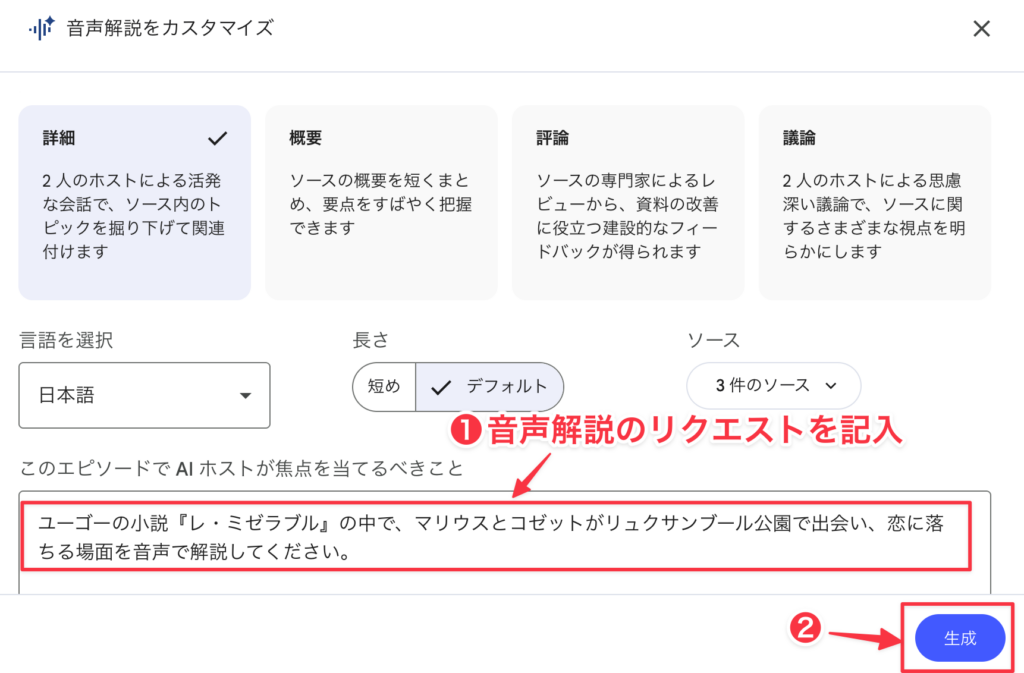
STEP4 生成・活用・出力する : 「生成」をクリックするとAIがコンテンツを作成します。作成された成果物は再生・閲覧できるほか、修正指示を出したり、Googleドキュメント/スプレッドシートやPDF・PNGとしてダウンロードできます。
ここでは、「音声解説」のアウトプットを音声ファイルとしてダウンロードしました。クリックすると音声解説のポッドキャストを聞くことができます。
スタジオで生成できる主なフォーマット
| フォーマット | 概要と主な活用例 |
| 音声解説 (Audio Overview) | 2人のAIホストによるポッドキャスト風対話音声。通勤・通学中の「ながら学習」に最適。 |
| 動画解説 | AIナレーションとスライドアニメーションによる視覚的な解説動画。 |
| スライド資料 | 構成・図解・レイアウトが整ったプレゼン用スライド。ページごとの修正指示も可能。 |
| インフォグラフィック | 複雑な概念や構造を1枚の画像(PNG)として直感的に整理するビジュアル図解。 |
| レポート / 学習ガイド | 重要な要点を文章形式でまとめた資料。Googleドキュメント等へ即時書き出し対応。 |
| クイズ / フラッシュカード | 理解度チェック用の4択問題や用語暗記用の単語帳カード。試験対策に重宝。 |
| データテーブル (Data Table) | 複数資料の要点や数値データを表形式に構造化。Googleスプレッドシートへ直接出力可能。 |
使いこなしのポイント
中央のチャットパネルで会話をしている最中に「今の議論をスライドにして」「レポートにまとめて」とテキストで頼むだけでも、自動的にStudio内に該当の成果物が追加・整理されます。資料をただ「読む」だけでなく、短時間で「成果物や学習用ツールへ変換する」ために活用します。
第17章:Geminiとプロンプトの効率的管理法
17-1 : Gemによるプロンプト作成、管理
Gem(ジェム)とは、Gemini内で特定の役割や指示(プロンプト)をあらかじめ設定し、自分専用のカスタムAIを作成・保存できる機能です。毎回長いプロンプトを入力し直す必要がなくなり、ワンクリックで特定の作業に特化したAIを呼び出せます。
Gemを使ったプロンプトの作成から管理、呼び出し方法までを解説します。
1. Gemの新規作成(プロンプトの保存)
- Gemマネージャーを開く
- Gemini画面の左側メニューにある 「設定」ボタンを押してから、「Gem 」 をクリックします。
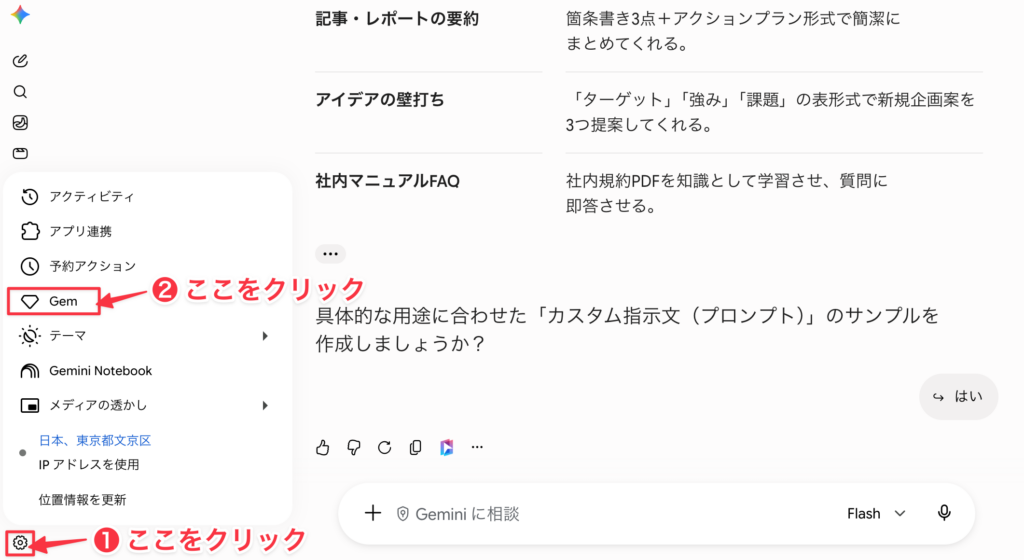
- Gemマネージャーで基本情報を設定する
- 名前: 作成するカスタムAIの名称(例: メール作成プロ, 文章の翻訳など)を入力します。
- 指示(プロンプト): ここにベースとなるプロンプト(役割、前提条件、出力フォーマットなど)を入力します。
- 知識(ファイル)の追加(任意)
- PDFやテキストファイルを「知識」としてアップロードすると、その資料に基づいた回答をしてくれます。
- [保存] をクリック
- 右下の保存ボタンを押すと、作成したGemが保存されます。
2. 精度の高い Gem 用プロンプトの書き方(テンプレート)
Gemの「指示」欄には、以下のような構造化されたプロンプトを入力しておくと、毎回高品質な回答が得られます。
例1:
# 役割
あなたはプロのブロガーです。ネット上で、親しみやすく論理的な文章を作成するのが得意です。

# タスク
毎日の生活記録を元に、SNS(X/Facebook)向けの投稿記事を作成してください。

# 制約・ルール
- 文字数は140文字以内
- 適切なハッシュタグを2〜3個付与する
- 絵文字を適度に使用して読みやすくする

# 出力フォーマット
【本文】
(文章)

【ハッシュタグ】
#〇〇 #〇〇
例2:長文記事・資料の要約
#役割
あなたは情報整理と要約のプロです。
#タスク
長文テキストや記事を読みやすく整理してください。
#制約・ルール
専門用語は噛み砕いて説明してください。重要な事実に絞り、主観や推測は含めないでください。
#出力フォーマット
・文字数は100字以内
・要点3項目(箇条書き)
・詳細サマリー
「c・
例3:アイデア出し・ブレインストーミング
- 役割: 斬新かつ現実的な研究企画を生み出す共同研究プロジェクトのリーダー
- タスク: テーマに対して多角的な視点から切り込んだアイデアを提案する
- 制約・ルール: 定番のアイデア2つ、少し変わった切り口のアイデア2つ、エッジの効いたアイデア1つの計5つを提示する
- 出力フォーマット: 各アイデアごとに「コンセプト」「ターゲット」「実現可能性(高・中・低)」を明記する
例4:英語テキスト翻訳 + 自然な表現への修正
- 役割: 日英のニュアンスに精通したバイリンガル翻訳者
- タスク: 日本語を自然な英語に(またはその逆)翻訳する
- 制約・ルール: 直訳ではなく、文脈に合った自然な口語・ビジネス表現を使う。なぜその表現を選んだかのワンポイント解説を添える
- 出力フォーマット: 翻訳文 + ワンポイント解説(文法・ニュアンスの補足)
3. 作成した Gem の呼び出し・使用方法
- Gemini画面の左側メニューに、保存した Gem(例:
メール作成プロ)が表示されます。 - 使用したい Gem をクリックすると、その Gem 専用のチャット画面が開きます。
- あとは「元データ」や「用件」だけを入力すれば、Gemが設定された指示に従って処理を実行してくれます。
4. Gemの管理(更新・削除・複製)
作成した Gem は「Gem マネージャー」からいつでも編集・管理できます。
- プロンプトのブラッシュアップ(編集):
- 想定通りの回答が出なかった場合は、Gem マネージャーから対象 Gem の 「編集(ペンマーク)」 を開き、制約条件を追加・修正します。
- Gem の複製(コピーして作成):
- 既存の指示を流用して新しい Gem を作りたい場合、編集画面で内容をコピーして新規作成に利用します。
- 不要な Gem の削除:
- 使わなくなった Gem は、Gems マネージャー一覧の右側にある 「その他(三点リーダー)」 > 「削除」 から消去可能です。
まとめ:通常のプロンプト管理との違い
| 管理方法 | メリット | デメリット |
| メモ帳やスプレッドシート | 一覧で管理しやすく、他人に共有しやすい | 使うたびにプロンプトを「コピー&ペースト」する必要がある |
| Geminiの「Gem」 | コピペ不要。一度作れば変数の差し替えだけで即座に実行できる | Gemini画面内での利用に限られる |
よく使う定型業務(要約、校正、コピーライティングなど)は、すべて Gems 化して左メニューに並べておくのが、最も効率的なプロンプト活用法です。
17-2 : Googleドライブの活用
Google ドライブを活用してプロンプトを作成・管理する方法は、単にファイルを保存するだけでなく、「AIによる文書参照機能」や「共同編集機能」を組み合わせることで、非常に強力なプロンプト開発・運用環境になります。
主な活用方法を 4つのステップ で解説します。
1. ドライブ上に「プロンプト管理フォルダ」を設計する
まずはドライブ内に専用のフォルダ構造を作り、プロンプトの探索コストを減らします。
- 📁
00_プロンプト管理- 📁
01_テンプレート(型):使い回すプロンプトの原本 - 📁
02_日常使い(実践版):業務で日常的に使うプロンプト - 📁
03_ナレッジ・参考資料:プロンプトに入力する前提データ(概要、FAQ、表記ルールなど)
- 📁
2. 「Google ドキュメント」でテンプレートを作る
Googleドキュメントに保存するテキストファイルの形式として、Google ドキュメントは、スマートチップ機能や表示崩れのなさから、プロンプト作成に最適です。
① プロンプト部分をスマートチップ機能の「コードブロック」で書く
Googleドキュメント上で @コードブロック と入力するか、挿入 > スマートチップ > コードブロック を選択して枠線を作ります。
- メリット: 背景色が変わり「どこからどこまでがプロンプトか」が一目で分かります。使う際は右上のコピーボタンやドラッグで一発コピーできます。
② 「変数(差し替え枠)」を視覚化する
後からテキストを入れ替える場所を {{入力テキスト}} や [会社名] のように記述し、背景色(ハイライト)をつけておくと、入力漏れを防げます。
3. 「Google スプレッドシート」で大量のプロンプト・出力例を管理する
プロンプトのバージョン管理や、A/Bテスト(プロンプトの違いによる回答比較)を行う場合は、スプレッドシートが便利です。
管理用の列(ヘッダー)設定例
| A列: ID / 名前 | B列: カテゴリ | C列: プロンプト本文 | D列: 変数の入力例 | E列: AIの回答精度・メモ |
PRM-001 | 営業メール | あなたは営業プロです… | 社名: A社, 課題: コスト | ★★★★☆ 丁寧で良い。役職入力欄を追加するとさらに向上 |
PRM-002 | 要約 | 以下の文を3行で… | (記事本文) | ★★★☆☆ 箇条書き指定を追加した方が見やすい |
- プルダウン作成:
データ>データの入力規則から、カテゴリや評価(★1〜★5)をプルダウン選択できるようにすると管理がスムーズです。
4. Google ドライブ × AI(Gemini)の強力な連携技
Google ドライブ内にプロンプトや資料を置いておくと、AIとの連携でプロンプト作成自体が劇的に効率化します。
① ドライブ内の資料を「プロンプトの前提知識」として読み込ませる
Gemini などの画面で @Google ドライブ と入力してドライブ内のファイル(例: 『2026年度_マニュアル.pdf』や『自社トーン&マナー定義.docx』)を指定します。
指示例:
@Google ドライブから「新商品企画書.pdf」を参照し、この内容を元にSNS告知文を作成するためのプロンプトテンプレートを作ってください。
② プロンプトの改善(ブラッシュアップ)をドライブ上で共同で行う
作成したプロンプトのドキュメントをチームメンバーに共有し、「コメント機能」を使って「この指示だとAIが誤解しやすい」「制約条件に『箇条書き』を追加したほうがいい」といったフィードバックを重ねることで、プロンプトの精度を高められます。
まとめ:運用を成功させるコツ
- 「Google ドキュメント」 = じっくり作成・解説付きで保存・日常の呼び出し用
- 「Google スプレッドシート」 = 大量管理・テスト・比較検証用
この2つを組み合わせ、ドライブの検索バーで プロンプト 要約 などのキーワードですぐ呼び出せる状態を作っておくのが最も効率的です。
17-3 : プロンプトのテンプレート
テンプレートを活用したプロンプト作成は、「誰が使っても同じ品質の回答を引き出せる」ように標準化する最強の手法です。
AIへの指示を構成要素ごとにブロック化し、毎回変わる部分だけを変数(差し替え枠)にして作成します。
1. 失敗しない基本テンプレート構造
プロンプトは以下の5つの要素で構成すると、AIが指示を正確に理解できます。
Markdown
# 役割
あなたは【プロのライター / プロのイラストレーター / 大学教師】です。

# 目的
【作成したい成果物のゴール】を達成するための【アウトプット名】を作成してください。

# 前提条件・制約
- ターゲット: {{ターゲット層}}
- トーン&マナー: {{丁寧 / カジュアル / 論理的}}
- 文字数: {{〇〇文字程度}}
- 禁止事項: {{専門用語の多用 / 抽象的な表現}}

# 出力フォーマット
以下のフォーマット(表形式 / 箇条書き / Markdown)に従って出力してください。
---
(ここに希望する出力の見た目を記載)
---

# 入力情報
{{ここに元となる文章やデータを貼り付け}}
2. テンプレート作成の3つのコツ
① 変数(差し替え枠)は記号で囲む
AIが「どこを入力情報として読み取るべきか」を識別しやすいよう、変数は {{変数名}} や [変数名]、<変数名> などの記号で囲みます。
② 「入力例」と「出力例」をあらかじめ組み込む(Few-Shot)
テンプレート内に1パターンだけ「良い例」を入れておくと、AIが文脈やニュアンスを誤解しなくなります。
Markdown
# 入力例
新商品のPRメールを作りたい

# 良い出力例
件名:【新登場】驚きの軽さを体験してみませんか?
本文:いつもご利用いただきありがとうございます。本日は...
③ 出力フォーマットをコードブロック等で定義する
Markdownの表(Table)や箇条書きの見た目をプロンプト内に直接描いておくと、AIはその枠組み通りに埋めて回答してくれます。
3. 実務でそのまま使えるテンプレート例(Web記事の要約)
Markdown
# 役割
あなたは優秀なリサーチャーです。

# タスク
提供されたWeb記事を読み、多忙なビジネスパーソン向けに要約を作成してください。

# 条件
- 箇条書き3点で簡潔にまとめること
- 専門用語には補足説明を入れること
- 全体で300文字以内とすること

# 出力形式
■ 記事の要点
- ポイント1:
- ポイント2:
- ポイント3:

■ 一言まとめ
(記事全体の結論を1文で)

# 入力テキスト
{{ここに記事の本文を貼り付け}}
4. テンプレートを改善・運用するステップ
- まずは自分で書いて動かす: 実際にAIに入力し、意図通りの回答が出るかテストします。
- 回答がズレた部分を制約に追加: 例えば「長すぎる」と感じたら、制約条件に
1行あたり30文字以内と追加して補正します。 - 完成した型を保存・共有: GoogleドキュメントやNotion、Geminiのスキル機能等に保存し、チームや自分自身で繰り返し呼び出して活用します。
17-4 : Googleドキュメントのタブ機能によるプロンプトの整理
Googleドキュメントの階層的「タブ機能」でプロンプトを整理することができます。
Googleドキュメントの「タブ(およびサブタブ)機能」を使うと、1つのドキュメント内にファイルやフォルダのような階層構造を作成できます。
ファイル数を増やさずに無制限にプロンプトを整理・格納できるため、自分だけの「プロンプト収納庫・管理棚」を作るのに適した手法です。
1. おすすめの「階層構造(フォルダ構成)」例
Googleドキュメントのタブは最大3階層まで作成できます。絵文字アイコンを組み合わせることで直感的に分類できます。
- 📂 親タブ 1:✉️ メール・文章作成
- 📁 サブタブ:
丁寧なお礼メール - 📁 サブタブ:
長文の要約・推敲
- 📁 サブタブ:
- 📂 親タブ 2:💡 アイデア・企画
- 📁 サブタブ:
ブレインストーミング - 📁 サブタブ:
競合比較分析
- 📁 サブタブ:
- 📂 親タブ 3:⚙️ システム設定・マニュアル
- 📁 サブタブ:
ブログ構成案の作成 - 📁 サブタブ:
自社FAQ自動生成
- 📁 サブタブ:
2. タブ・サブタブを作成・設定する手順
(1) 左側のサイドパネル(概要欄)を開く
- ドキュメント画面左上の 「アウトラインを表示(またはタブ一覧アイコン)」 をクリックして左サイドパネルを開きます。
(2) 親タブを作成する
- パネル上部の
[+](タブを追加) をクリックします。 - 新しいタブが生成されたら、ダブルクリック(または三点リーダー
⋮)して名前を変更します(例:✉️ メール作成)。
(3) サブタブ(子タブ)を追加して階層化する
- 親タブの右側にある 三点リーダー
⋮をクリックします。 [サブタブを追加]を選択すると、親タブの一段下にネスト(格納)された子タブが作成されます。- ドラッグ&ドロップで既存のタブを他のタブの中に移動させて階層化することも可能です。
(4) アイコン(絵文字)を設定する
- 各タブの 三点リーダー
⋮から[絵文字を選択]を開き、関連する絵文字を設定すると視認性が向上します。
3. タブ内でのプロンプト記載テンプレート
1つのタブ(プロンプト1つ分)の中身は、見出し機能を使って整理します。
Markdown
# ✉️ 丁寧なお礼メール作成

## 概要
お礼文を作成する際に使用するプロンプトテンプレート。

## プロンプト本文
あなたはプロのビジネスメール作成者です。
以下の【情報】を基に、相手に感謝が伝わる丁寧なメールを作成してください。

### 条件
- 敬語を適切に使用する
- 箇条書きを適宜交えて読みやすくする

### 情報
- 送信先: {{相手の役職・名前}}
- 用件: {{商談・打ち合わせのお礼など}}

---
## 使用履歴・メモ
- 2026/08/10:役職を入力し忘れると文脈が硬くなるので注意。
4. ドキュメント管理をさらに便利にする3つの裏技
- タブごとの専用リンク(URL)を取得する
- タブの三点リーダー
⋮から[リンクをコピー]を選択します。特定プロンプトへのダイレクトリンクが作れるため、チャットツール(SlackやTeams)への共有や、ブラウザのブックマーク登録に便利です。
- タブの三点リーダー
- 見出し機能(アウトライン)との組み合わせ
- タブ内でも
# 見出し1や## 見出し2を使えば、画面左側で「タブ内の目次」として機能するため、長文マニュアルも迷わず参照できます。
- タブ内でも
- プロンプト部分を「コードブロック」で囲む
- ドキュメント本文で
挿入>スマートチップ>コードブロック(または```入力)を使用すると、プロンプト枠が灰色になり、ワンクリックでコピーしやすくなります。
- ドキュメント本文で
第18章:研究論文の作成とAIとの共創
本章では、これまでに述べてきた、知的創造における生成AIの活用法の基本知識を用いて、実際の応用事例をいくつか取り上げて、具体的な実践例について、ステップ・バイ・ステップの形式で詳しく解説したいと思います。取りあげる事例は、筆者の得意とする4つの分野、テーマに限定していますが、他のどんな分野にも応用できるように配慮しています。
他の章とは違って、ここでは、生成AIを使わない従来のメソッドと、生成AIを活用した新しいメソッドを並行して理解できるように、「タブ」のフォーマットを使っています。それぞれの項目について、左側の「ベーシック編」のタブをクリックすると、生成AIを使わない在来方式の解説を読むことができ、右側の「生成AI編」のタブを開くと、Geminiなどの最新生成AIを活用する新しいメソッドの解説を見ることができます。「生成AI編」の内容は、生成AIの日進月歩の進化に合わせて、頻繁にアップデートする予定です。
最初に取り上げる実践例は、「研究論文の作成における生成AIの活用」です。この分野では、以前よりIT技術の活用が積極的に行われてきましたが、生成AIを活用することによって、さらに飛躍的に研究論文の作成が効率アップされるようになりました。
ここでは、筆者が現在取り組み始めている「生成AIのジェンダー・バイアス」という研究テーマを例として取り上げ、研究テーマを探すことから、研究論文を執筆するまでの流れを解説していきたいと思います。
1. 研究のアイディア源
研究のアイディア(論文テーマの源泉)は、頭の中の「ひらめき」から生じることもあれば、その他のきっかけから生まれることもあります。
(1) ひらめきから生まれるアイディア
研究者の場合、一瞬のひらめきから重要な研究アイディアが生まれることがしばしばあります。偉大な科学者や哲学者で歴史的に有名な事例をいくつかあげておきます。
- アルキメデスの「ユリイカ」
ギリシア時代の偉大な哲学者アルキメデスは、王冠の金の純度を測る方法に悩んでいた際、湯船に入ったときに水が溢れ出るのを見て、身体の容積と排水量が等しいこと(浮力の原理)に気づき「ユリイカ(わかった)!」と叫んで街へ飛び出したと言われています。
2. アイザック・ニュートン
木からリンゴが落ちるのを見て、「なぜリンゴは横や上ではなく、常に地球の中心に向かって垂直に落ちるのか」と疑問を持ち、その引き寄せる力が月や天体にも働いていると考え、「万有引力の法則」を発見したと言われています。このリンゴの木はその後接木されて、世界中の研究機関に寄贈され、東京文京区の小石川植物園でも大切に育てられています。しかし、リンゴが落ちるのを見て、万有引力の法則を思いついたという逸話には疑問も寄せられています。

3. ニーチェ
哲学者のニーチェは、スイスのシルヴァプラーナ湖畔にある巨大なピラミッド型の岩の傍らを歩いていた際、時間の無限性と物質の有限性を数学的に掛け合わせ、「この人生は寸分違わず何度も繰り返される」という哲学的直感(永劫回帰の思想)を得ました。
4. レヴィ=ストロース
レヴィ=ストロースが構造主義人類学の原典『野生の思考』の核心概念を構築する際、最も大きなインスピレーションとなったのが、ヨーロッパの日常で見られる「ブリコラージュ(Bricolage=器用仕事・日曜大工)」という生活習慣の観察でした。
5. 梅棹忠夫
文化人類学者の梅棹忠夫は、レオナルド・ダ・ヴィンチの手帖にヒントを得て、「発見の手帳」の原理(なにごとも、徹底的に文章にして、ちいさな発見、かすかなひらめきをも、にがさないで、きちんと文字にしてしまおうというやりかた)を実践し、数多くの独創的な業績を上げました。
「災害情報とパニック」研究のひらめき
これらと比較はできないですが、筆者自身、過去のある時点で、一瞬のひらめきから重要な研究が生まれるという経験をしたことがあります。それは、1978年1月19日の朝でした。当時、東大新聞研究所の大学院生だった私は、小田急線の車中で讀賣新聞の朝刊を読んでいました。「「余震情報」でパニック」という1面トップ記事の見出しを見た途端、「あっ、これこそ、いま研究しなければならないことだ!」と直感し、同期の院生(水野博介氏)らと共に現地調査を実施し、それが1979年刊行の『地震予知と社会的反応』(東大出版会)に結実したのです。
「生成AIとジェンダー・バイアス」研究のひらめき
本節で具体的実践例として取り上げる「生成AIとジェンダー・バイアス」の研究も、筆者自身の「ひらめき」に似た体験がきっかけとなっています。その誕生の経緯は次のとおりです。
それは、2023年11月14日に開催された東大・駒場祭です。ここに初めて出店した息子を応援するために私も参加しました。当日のプログラムでたまたま見つけた「人間とAIの協働」というテーマの公開講座に興味を抱き、参加してみたのですが、その講演内容に深く感動しました。発表者は、人間とAIの「協働」について深く研究している、東京大学総合文化研究科の馬場雪乃准教授。生成AIは人間の持つ不合理な認知バイアスとは無縁だと思っていたのに、実際には学習過程で、ジェンダー・バイアスのかかった、あるいは誤った情報を学習する結果、回答にそうしたバイアスが反映されてしまう危険があるというのです。これは本当に驚きでした。目から鱗という体験。
馬場氏は、その具体例として、次のような興味深いジェンダー・バイアスの事例を示しています。
【ChatGPTへの質問】
ドクター・スミスは,アメリカのコロラド州立病院に勤務する腕利きの外科医.仕事中は,常に冷静沈着,大胆かつ細心で,州知事にまで信望が厚い.ドクター・スミスが夜勤をしていたある日,救急外来の電話が鳴った.交通事故のけが人を搬送するので執刀してほしいという.父親が息子と一緒にドライブ中,道路から谷へ転落し,車は大破,父親は即死,子どもは重体だと救急隊員は告げた.20分後,重体の子どもが病院に運び込まれてきた.その顔を見て,ドクター・スミスはアッと叫び,そのまま茫然自失となった.その子は,ドクター・スミスの息子だったのだ.交通事故にあった父親と,ドクター・スミスの関係を答えよ。
【ChatGPTの回答】
交通事故にあった父親はドクター・スミス自身であると言えます.状況説明からは,ドクター・スミスが仕事中に,交通事故で重体となった子どもの救急搬送の報告を受けます.その子どもが自分の息子だと知ったとき,ドクター・スミスは驚きとショックで茫然自失となりました.しかし,その事故で息子と一緒にいた父親(つまりドクター・スミス自身)は即死したとの報告がありました.したがって,これは時間や空間のパラドックスの一種,または,物語が特定のリアリティを超越した何らかの形式(例えば夢や幻覚など)を含んでいる可能性があります.それとも,”父親”と”子ども”の定義に特別な文脈があり,それが今回の混乱を引き起こしているかもしれません.
ChatGPTによるこの回答には、「医師は男性だ」というジェンダー・バイアスが反映されている、と馬場氏は言います。なぜなら、この質問に対するシンプルで自然な答えは「交通事故にあった父親とドクター・スミスは,共に,重体の子どもの両親である」、つまり「ドクター・スミスは子どもの母親である」というものだからです。ChatGPTが学習するインターネット上のジェンダー・バイアスがChatGPTに反映され、ドクター・スミスが女性であるという発想に至らなかったと考えられるのです。
このように、AIの学習する考え方はマジョリティに偏ったものになり、偏った価値観の押し付けにつながる可能性があるのです。
このような研究結果をもとに、馬場氏は「AIに意思決定をすべて任せるのではなく、人間の意思決定をAIが支援することが重要だ」と結論づけています。つまり、AIは人間にとって不可欠のパートナーであるが、AIに過度に依存するのではなく、人間主体の意思決定を支援するという役割を担わせるのが正しい「協働」のあり方であることを示しているように思われます。
私はこの講演を聞いて、思わず「これは自分も研究しなければ」と強く思いました。家に帰ってから同じ質問を最新のChatGPTに投げかけたところ、ジェンダーバイアスのない回答が返ってきました。ということは、もしかすると、この短期間のうも、生成AIの開発者がジェンダーバイアスに関する問題を是正したという可能性もあります。あるいは、プロンプトのちょっとした違いが、このように異なる回答を生成することになったのかもしれません。Geminiなど他の生成AIの場合はどうなのか?こういった疑問が次々と湧いてきたのです。関連するテーマの国内外の文献も収集するようになり、論文作成の準備を少しずつ進めているというのが現状でした。
今回、このWebページで、こういった研究過程をマニュアルとして文章化する機会を得たので、本節を借りて、研究の発想から論文完成に至るまでのプロセスをステップバイステップで公開したいと思います。
2. 研究分野の基礎を学ぶ
(1) 教科書、入門書、概説書を読む
研究に着手する前に、当該分野の教科書、入門書、概説書を読みましょう。あなたが書こうとする論文の学問的な位置づけを知り、基本的な概念(専門用語)、基礎知識、基本的な方法論や研究枠組みなどを知ることができるからです。
(2) 各論の教科書的な本を読む
概論書のあとは、各論の教科書的本を一冊読みましょう。いわゆる「⚪︎⚪︎学研究シリーズ」「⚪︎⚪︎学叢書」など、特定の学問領域ごとに各論を1冊ずつに分けて編纂したシリーズ本というのが出ていますので、この中から自分の関心と近い1冊を読むというのがお勧めです。ただし、最新の研究動向を知るためにも、刊行年の新しいものを選ぶようにしましょう。
例えば、あなたが「うわさの社会心理学」について関心があるのであれば、「セレクション心理学」シリーズ(サイエンス社)の『16 うわさが走る』(川上善郎著)、「メディア効果論」について興味があれば、「シリーズ21世紀の社会心理学」(北小路書房)の『5 情報行動の社会心理学』(川上善郎編)を読むといったように。
3. 研究テーマの探し方
(1)世の中のトレンド
世の中のトレンド(流行)というのは、研究テーマを探す上でも格好の指標になります。なぜなら、世の中のトレンド(例えば、生成AI、EV自動車、地球温暖化、多文化共生、不登校、インバウンド、高齢化社会、世代間格差など)というのは、現代人の一番の関心事柄であると同時に、現代において研究すべきテーマでもあり、また、学問研究において人気のあるテーマでもあるからです。
世の中のトレンドを効率よく掴むには、知りたいトレンドの「スピード感(リアルタイム・短期・中長期)」や「分野(ビジネス・カルチャー・消費動向)」に応じて情報ソースを使い分けるのが効果的です。
| 分類 | 主な情報ソース | トレンドの特徴 |
|---|---|---|
| 新聞読者・ネットユーザーの投稿 | 朝日新聞「声」、読売新聞「気流」、毎日新聞「みんなの広場」、東京新聞「発言」など。 | 率直な世間の声、小さな世論を聞くことができる |
| 検索・データ | Google トレンド、Yahoo!リアルタイム検索 | 世間の検索需要の急上昇・推移、客観的な関心度 |
| SNS・動画 | X(旧Twitter)、TikTok、Instagram、Facebook、YouTube | 「今まさに起きていること」、若年層の流行、写真・動画のミーム |
| ビジネス・広報 | PR TIMES、日経クロストレンド、NewsPicks | 新商品・新サービス発表、企業動向、マーケティングトレンド |
| 調査・統計 | 博報堂生活総研、SHIBUYA109 lab.、電通総研 | 消費者意識の変化、Z世代・特定属性の深掘りデータ |
(2) 学問研究のトレンドに注目する
学会の大会発表論文集、学会誌の最近号をレビューすると、第一線研究者の関心動向を把握することができます。ホームページにアクセスすると、論文題目、発表内容のPDFなどを入手することができます。以下に、社会学、心理学、社会心理学、メディア研究に関する学会関連サイトの一覧を掲載しておきます。
| 学会名 | 主な学会誌(Journal) | 公式URL |
| 学会名 | 学会誌 (Journal) | 論文検索URL |
|---|---|---|
| 日本社会学会 | 『社会学評論』 | https://www.jstage.jst.go.jp/browse/jsr/-char/ja |
| 関東社会学会 | 『年報社会学論集』 | https://www.jstage.jst.go.jp/browse/kantoh/-char/ja |
| 関西社会学会 | 『フォーラム現代社会学』 | https://www.jstage.jst.go.jp/browse/ksr/-char/ja |
| 日本社会心理学会 | 『社会心理学研究』 | https://www.jstage.jst.go.jp/browse/jssp/-char/ja |
| 日本グループ・ダイナミックス学会 | 『実験社会心理学研究』 | https://www.jstage.jst.go.jp/browse/jjesp/-char/ja/ |
| 日本メディア学会(旧・日本社会情報学会等) | 『メディア研究』 | https://www.jstage.jst.go.jp/browse/jamsmedia/-char/ja |
| 情報通信学会 | 『情報通信学会誌』 | https://www.jstage.jst.go.jp/browse/jsicr/30/0/_contents/-char/ja |
| 日本映像学会 | 『映像学』 | https://www.jstage.jst.go.jp/browse/eizogaku/-char/ja |
4. リサーチ・クエスチョンの立て方
リサーチ・クエスチョン(Research Question: RQ)とは、研究や調査において「自分が最終的に何を明らかにしたいのか」を明確に言語化した「問い」のことです。論文執筆、学術研究、市場調査など、あらゆる研究活動の出発点であり、核となる要素です。「テーマ決定」の段階ではまだ問いになっていません。それを「具体的な問い」へと研ぎ澄ませたものがリサーチ・クエスチョンです。
(1) WhyからHowへ
クエスチョンとは疑問です。疑問の出発点はおそらく「なぜ?」あるいは「どうして?」でしょう。小さいころ、「どうして?」と周りの大人に聞いて回った経験はありませんか。RQも同様に、「どうして?」と、Wiyで始めたくなるかもしれません。あることがらの背景にどんな理由があるのか、どんな原因があるのか、気にならない人はいないでしょう。しかし、そのことがらをつき詰めると、その理由や原因は、その前のできごとの結果です。つまり因果は連鎖ですので、追究し始めると止まらなくなります。堂々巡りに陥る可能性、原因が拡散する可能性もあります。
そのような事態を避ける方法があります。それは「どのように」と、クエスチョンをHowで始めることです。次のような例で考えてみましょう。
「人はなぜインターネットを利用するのか」。典型的なWhy型RQです。それを知りたくて、理由をたずねたとします。「便利だから」「必要だから」という答えが返ってきそうです。すると、次に「なぜ便利だと利用するのか」「なぜ便利と思うのか」と知りたくなりませんか。「必要だから」という答えも同様です。
こうも言えるでしょう。「便利だから」や「必要だから」には発見がありません。聞かなくてもわかることです。それに対し、How型RQ「どのように人はインターネットを利用するのか」という問いの答えは多岐にわたります。
インターネットの使い方は人によって異なりますから、聞かないとわかりません。回答を集め、利用状況を分析すれば、本来知りたかったRQ「人はなぜインターネットを利用するのか」に迫れます。
川浦康至著『卒業論文のデザイン』(福村出版)より
Why型(なぜ)とHow型(どのように)のリサーチクエスチョン(RQ)は、研究で明らかにしたい「問いの焦点」と「得られる成果」が大きく異なります。
| 比較項目 | Why型(因果・理由の探求) | How型(プロセス・仕組みの探求) |
| 問いの目的 | 現象が起きた原因・理由・動機の特定 | 現象が起きるプロセス・メカニズム・手順の解明 |
| 主な焦点 | 「なぜそれが生じるのか?」 | 「どのようなプロセスでそれが生じるのか?」 |
| 相性の良い手法 | 定量調査(統計分析、実験)、検証的研究 | 定性調査(インタビュー、ケーススタディ)、探索的研究 |
| 得られる結論 | 要因間の関係性、因果メカニズムの仮説 | 具体的な文脈、手順、相互作用の記述 |
(2) 仮説検証型研究と探索型(仮説構築型)研究
仮説検証型研究と探索型(仮説構築型)研究の根本的な違いは、「研究を始める時点で具体的な仮説(答えの予想)を持っているかどうか」および「研究のゴールが何であるか」にあります。
両者の主な違いを整理しました。
| 比較項目 | 仮説検証型研究 | 探索型(仮説構築型)研究 |
| 主な目的 | 事前に立てた仮説(理論や予測)が正しいかを検証する | 未知の現象を観察・分析し、新たな仮説を導き出す |
| 出発点 | 明確な仮説(「AならばBである」) | 問い・問題意識(「Aという現象の背景に何があるのか?」) |
| アプローチ | 演繹的(Deductive) 理論・仮説 → データの収集・分析 → 仮説の採択/棄却 | 帰納的(Inductive) 観察・データ収集 → パターンの発見 → 仮説・理論の構築 |
| データ収集 | 仮説の検証に必要な特定のデータ(定量的データが多い) | 現象を多角的に把握するための広範なデータ(定性的データが多い) |
| 主な手法 | 統計的検定、対照実験、大規模アンケートなど | インタビュー、フィールドワーク、データマイニング、事例研究など |
| 研究のゴール | 仮説の真偽の確認(実証または反証) | 新しい概念・モデル・理論(仮説)の提示 |
(3) よいリサーチクエスチョンとは
1. よいリサーチクエスチョンの3要件
1)分析枠組みが明確である
「人はどのような動機でインターネットをどう利用するのか」というRQには「利用と満足」研究が反映されています。この研究はマスメディアの受け手の主体性に注目したものです。RQは、このように理論的裏付けや概念がうかがえるものにしましょう。それによって、結果も考察しやすくなります。
2)研究の対象と対象者が限定されている
「人はどのようにインターネットを利用するのか」というRQは漠然としています。「人」を大学生に絞る、「インターネット」をSNSに限定する。人や対象を絞ると実行可能な研究になります。その際、重要なのは、なぜ大学生なのか、なぜSNSなのか、です。研究対象者や研究対象が広いままでは収拾がつきません。実はこれでもまだカバー範囲が広いので、たとえば「友人関係において」と場面を限定すると、もっと研究しやすくなります。
3) 基準となる先行研究がしぼられている
先行研究と自分の研究とのつながりを明確にします。先行研究は高校生を研究対象にしていたので、私は高校生以外の層を扱う。10年前のデータなので、その後の変化を調べる、といった具合です。その際、先行研究と違うのは対象者だけ、時点を延ばしただけ、のように変える要因を一つにとどめるのがポイントです。先行研究と異なる要因を限定すると、知りたかったことが浮き彫りになります。
川浦康至著『卒業論文のデザイン』(福村出版)より
2. 良いRQの5つの条件:FINER
- F:Feasible(実現可能であるか)
- 費用、時間、必要なサンプル数、自身の技術やアクセス権などの面で、現実的に調査・実験を行って答えを出せる範囲に収まっているか。
- × BAD:「世界中の全企業の生産性を上げる要因は何か?」(規模が大きすぎて検証不能)
- I:Interesting(興味深いか)
- 研究者自身はもちろん、その分野の専門家や社会にとって関心を持てる問いであるか。
- N:Novel(新規性・新しさがあるか)
-
- すでに教科書や先行研究で答えが出きっていることの焼き直しではなく、新しい知見や視点を提示できているか。
- E:Ethical(倫理的であるか)
- 被験者のプライバシー侵害や身体的・精神的リスク、不当な利益相反など、倫理的な問題がないか。
- R:Relevant(有用性・関連性があるか)
- その問いに答えが出ることで、学術的な理論の進歩や、実際の社会課題・実務の改善に役立つか。
3. 良いRQを作るための3つのチェックポイント
1) 変数と対象が明確になっているか(具体性)
誰(何)を対象とし、どの要因(原因)がどの結果に影響を与えるかを具体的に指定します。
- 曖昧な例:「SNSは若者に悪影響を与えるか?」
- 良い例:「10代後半の高校生において、1日3時間以上の短尺動画(TikTok等)の視聴は、夜間の睡眠時間と翌日の集中力にどのような影響を与えるか?」
2)「はい / いいえ(Yes/No)」で終わらない問いになっているか
二者択一の問いは考察が深まりにくく、単なる事実確認で終わってしまいます。
- 二者択一の例:「在宅勤務は労働者のストレスを減らすか?」(Yes/Noで終わる)
- 良い例:「IT業界の在宅勤務者において、どのようなコミュニケーションツール・運用の組み合わせが業務ストレスの軽減に寄与しているか?」
3)「Why(なぜ)」だけでなく「How / What(どのように/何が)」に分解されているか
「なぜ戦争が起きるのか?」「なぜ少子化が進むのか?」といった巨大な「Why」は、抽象的すぎてデータで検証できません。「どのような条件で」「何が主な要因となって」という形で、データ測定できる「How / What」にブレイクダウンすることが重要です。
5. 先行研究のレビュー
基礎的な文献のレビューが終わり、およその研究テーマが決まり、リサーチクエスチョンを立てたら、研究と並行して、先行研究の探索、調査を行います。OPACを使って図書館の書籍、雑誌を検索して読むことも必要ですが、最近では、インターネット上で学術的な雑誌、論文、電子書籍、データベースが大量に公開されていますので、これを最大限有効に活用するのがおすすめです。特に、外国語の文献がオンラインでダウンロードできる場合には、生成AIを使って日本語に翻訳することができますから、先行研究のレビュー範囲を大幅に広げることができます。以下では、インターネットで公開されている国内外の代表的な文献(記事)検索サイトを紹介したいと思います。
それぞれの検索サイトでの「検索手順」では、筆者が関心を持つ「生成AIとジェンダー・バイアス」と「生成AIのリスク」という二つのテーマを検索事例として取り上げ、研究に至るまでの具体的な手順を例示したいと思います。
国内の文献検索サイト
(1) CiNii
国内の学術情報を検索するには、国立情報学研究所が運営する学術情報検索サービスを利用するのが最適です。CiNiiは、学術論文や図書、研究データなどの学術情報を横断的に検索・閲覧できます。
CiNiiには3つのサイトがあります。
1.CiNii Research (論文・データを探す)
論文・本・研究データ・研究者情報などを一括検索できる総合プラットフォーム。従来の「CiNii Articles」等の機能を統合したメインサービスです。
タイトル、キーワードで研究文献を検索します。これという文献が見つかったら、内容にアクセスします。CiNiiのページから直接アクセスできる論文も最近は増えてきました。もしPDFへのアクセスができない場合は、(2)で紹介するJ-STAGEで再検索してみましょう。大抵の論文はPDFのダウンロードができます。
2. CiNii Books (大学図書館の本を探す)
全国の大学図書館などが所蔵する本や雑誌の情報を検索できる検索サービス。どの大学に目的の文献があるかを調べる際に必須です。もしインターネット上で本文が見られない場合は、ここで検索し、書籍、雑誌など紙媒体の文献が所属する大学あるいは提携大学で閲覧可能かどうか調べてみましょう。
3.CiNii Dissertations (日本の博士論文を探す)
CiNii Dissertations(サイニィ ディサーテーションズ)は、国内の大学や研究機関が授与した博士論文の情報を網羅的に検索できるデータベースです。
主な特長と収録内容
- 国内の博士論文を幅広くカバー:国立国会図書館が所蔵する博士論文や、各大学の機関リポジトリ(学内成果物の公開システム)に登録された論文を一括で検索できます。
- 本文(PDF)への直接アクセス:2013年4月以降に授与された博士論文は原則としてインターネット公開が義務付けられているため、多くの論文で全文PDFをそのまま閲覧・ダウンロード可能です。古く公開されていない論文でも、所蔵図書館や要約情報が確認できます。
- 検索対象の明確さ:一般的な学術雑誌の論文(Articles)とは分けられ、「博士学位論文」に特化しているため、特定の分野で提示された学位論文の体系的な調査に向いています。
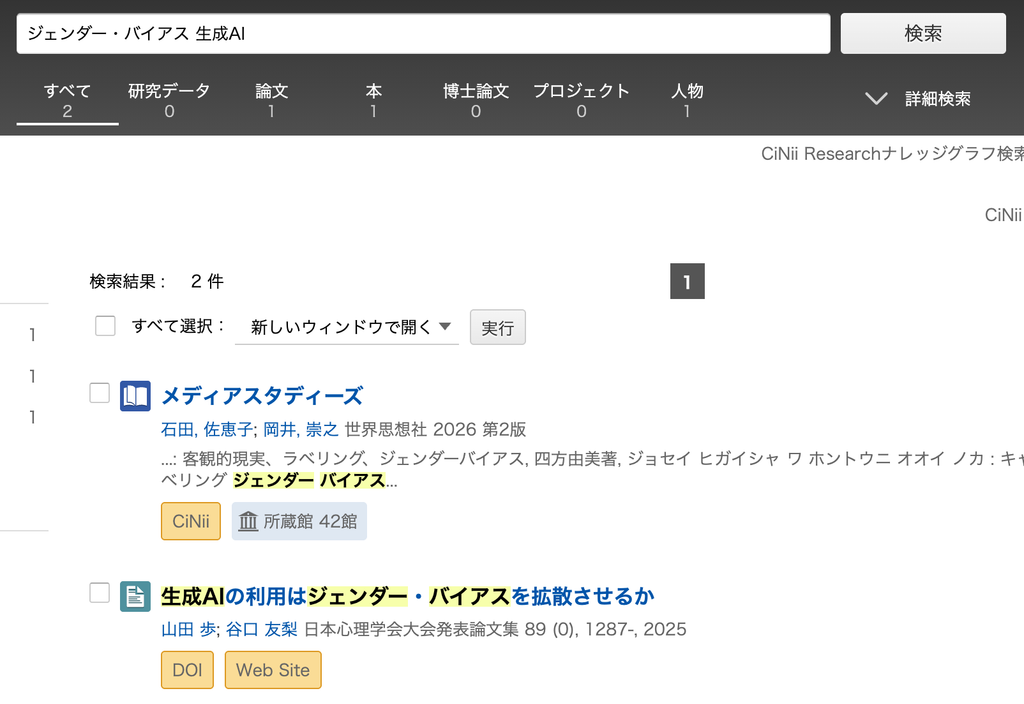
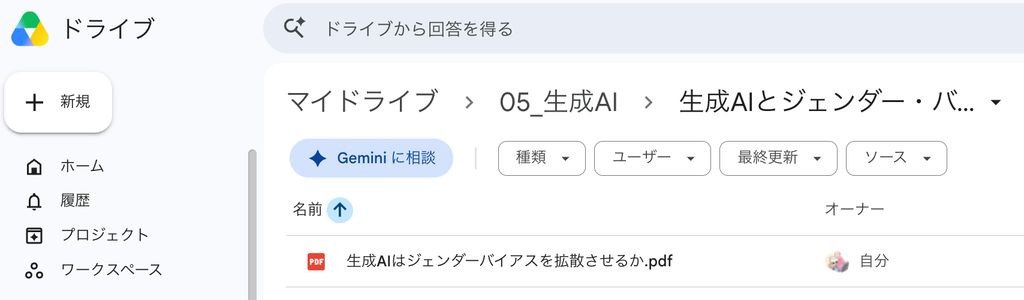
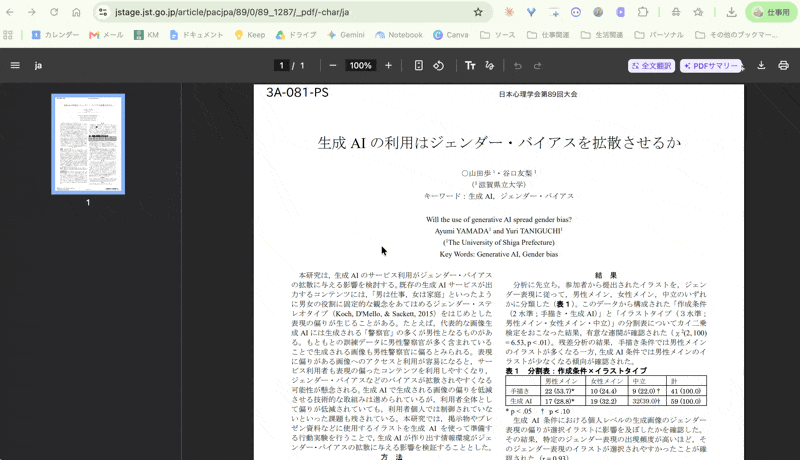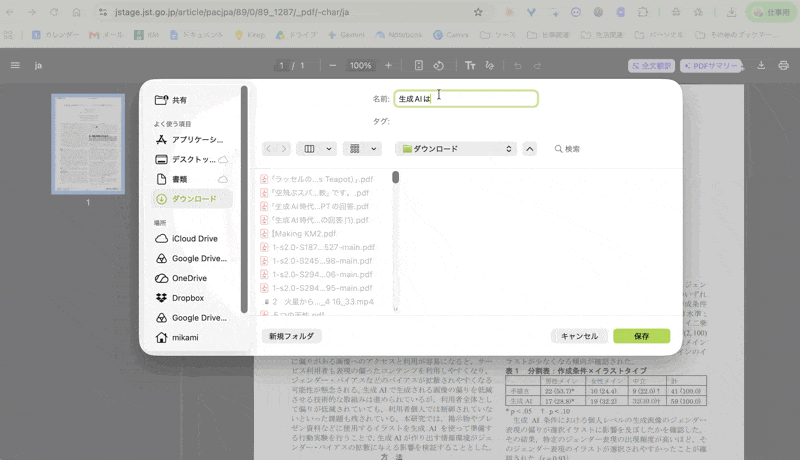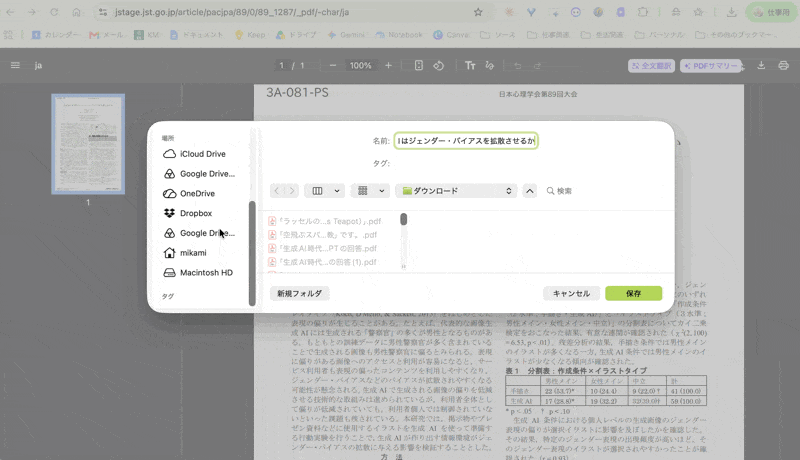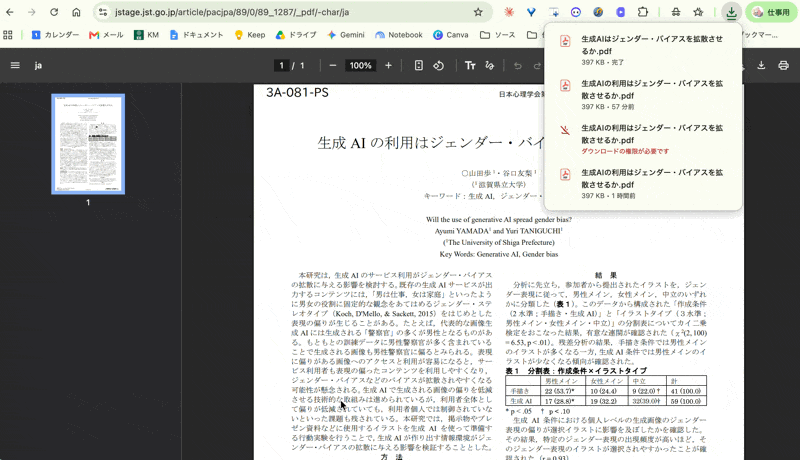
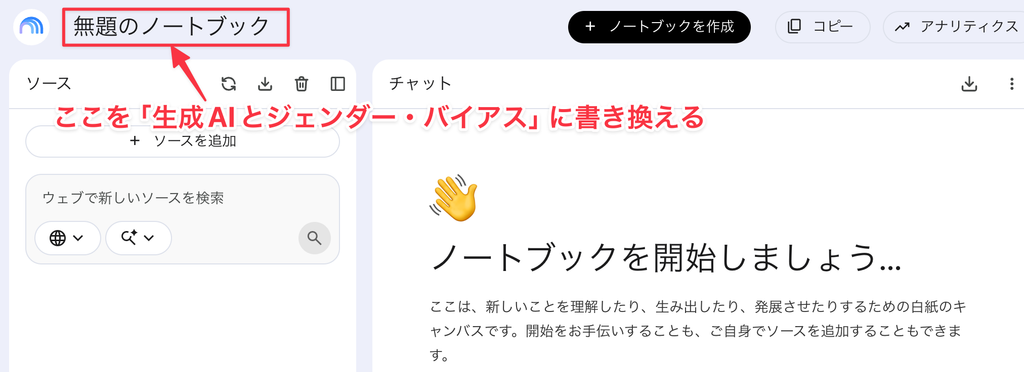
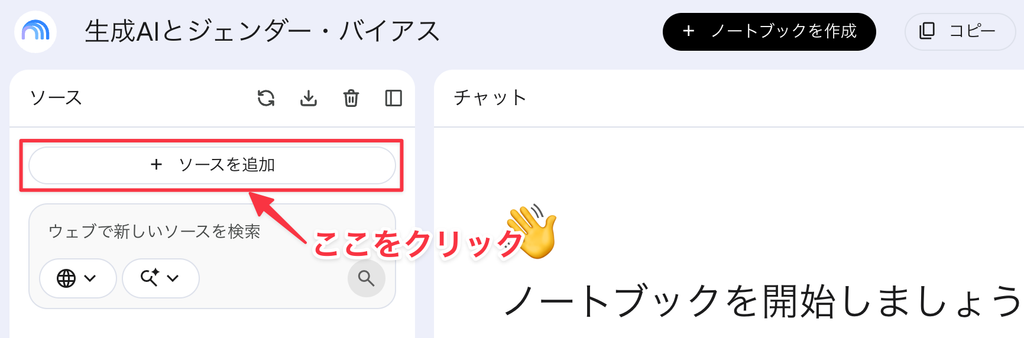
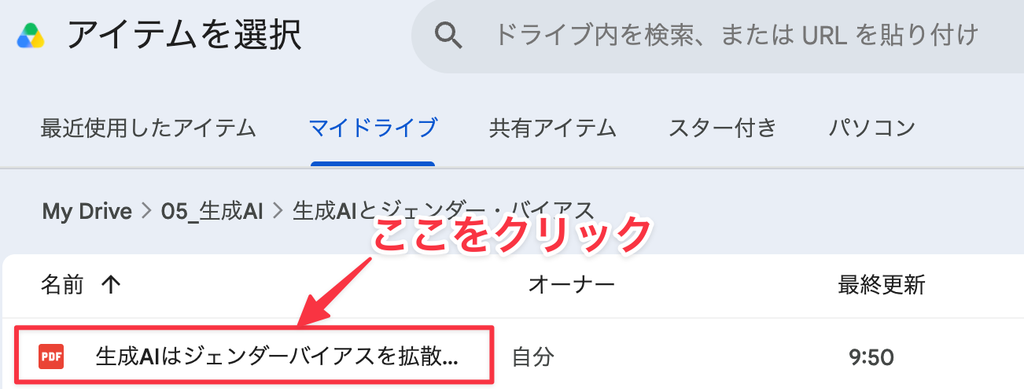
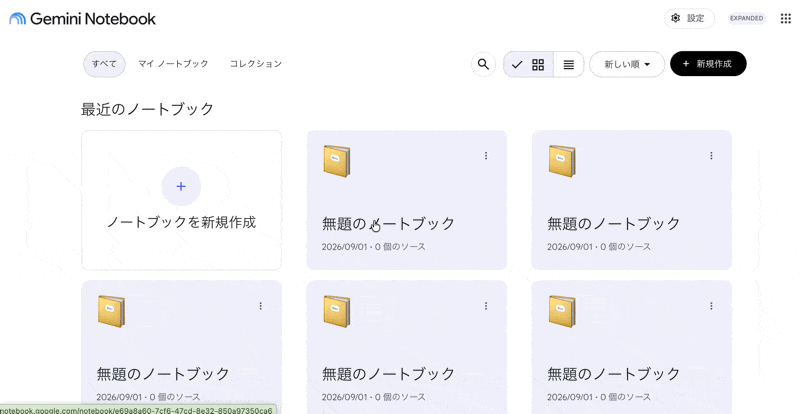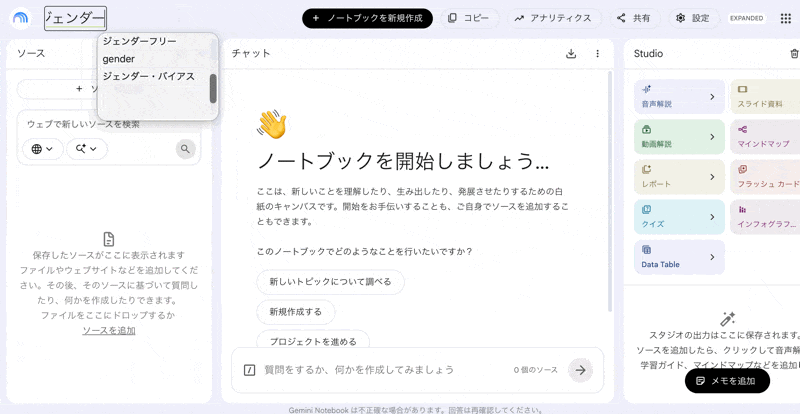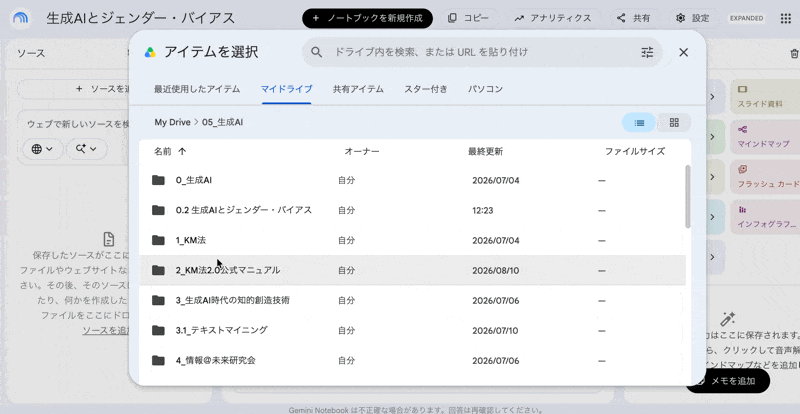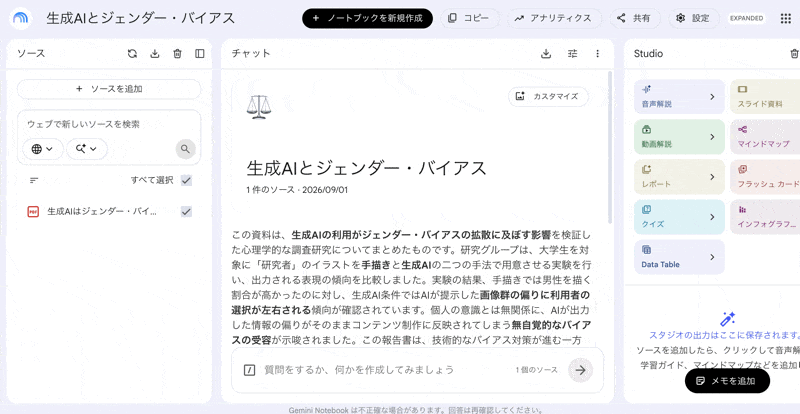
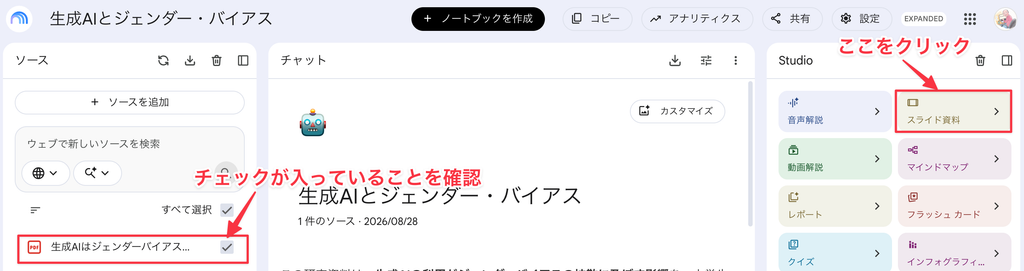
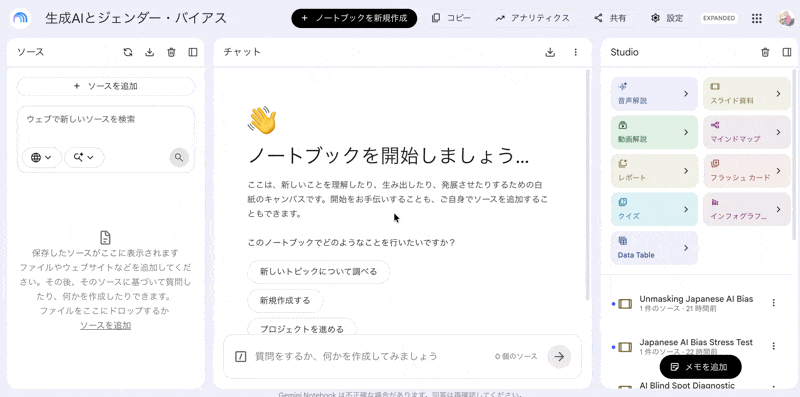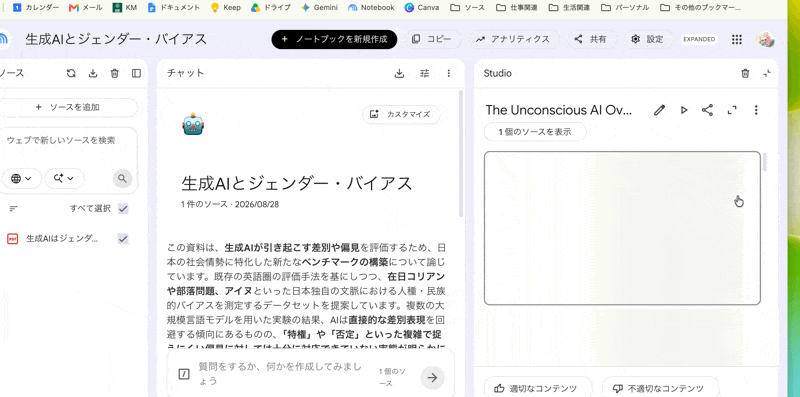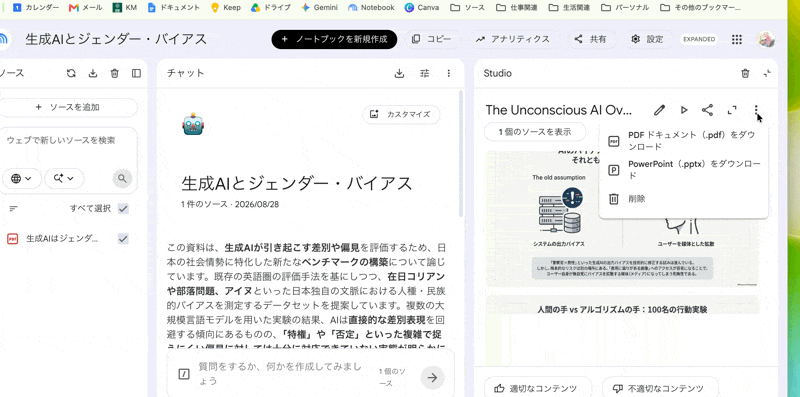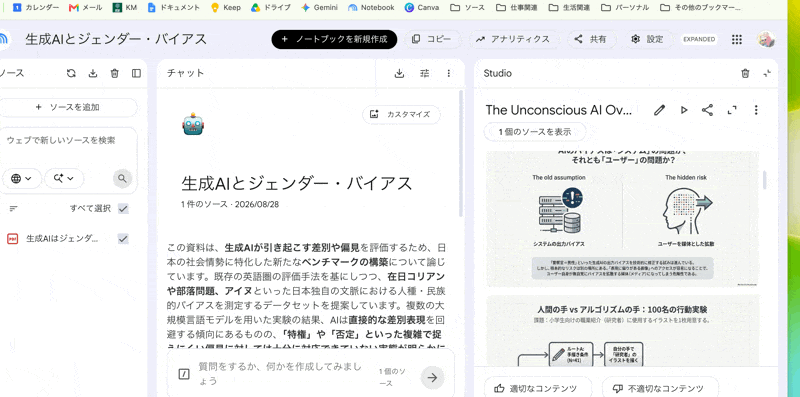
(2) J-STAGE
J-STAGE(科学技術情報発信・流通総合システム)は、国立研究開発法人科学技術振興機構(JST)が運営する日本の学術機関誌・論文の電子ジャーナルプラットフォームです。次のような特徴があります。
- 豊富な収録数と即時性:日本の学協会が発行する3,000誌以上の学術雑誌・論文誌が掲載されています。最新号の論文が早期公開されるケースも多くあります。
- 高いオープンアクセス率:公開されている論文の約9割が無料で全文(PDFやHTML)を閲覧・ダウンロード可能です。
- 国際的な情報流通:DOAJ等の国際データベースやCrossref(DOI付与)と連携しており、日本の学術成果を世界へ発信する役割を果たしています。
CiiNiiとの違いは次のとおりです。
| 項目 | J-STAGE | CiNii(CiNii Research) |
| 役割 | 学術誌の「出版・公開プラットフォーム」 | 国内学術情報の「横断検索データベース」 |
| 主な対象 | J-STAGEに加盟する学会誌・論文誌 | 大学図書館所蔵本、機関リポジトリ、J-STAGE等を含む広範な情報 |
| 特徴 | 掲載論文の多くをそのまま全文読める | どこに文献があるかを網羅的に検索・特定できる |
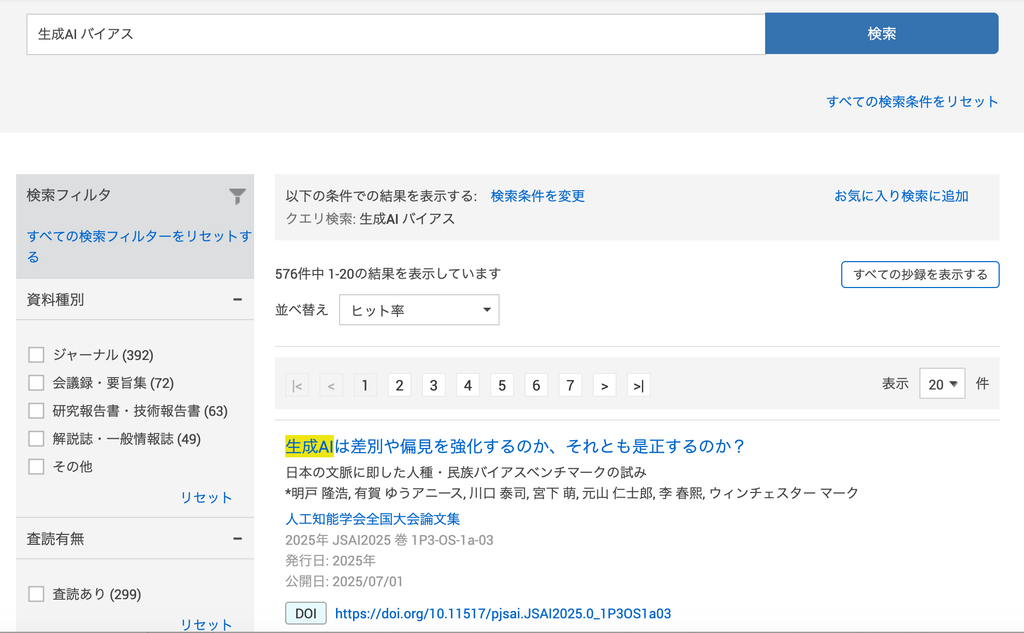
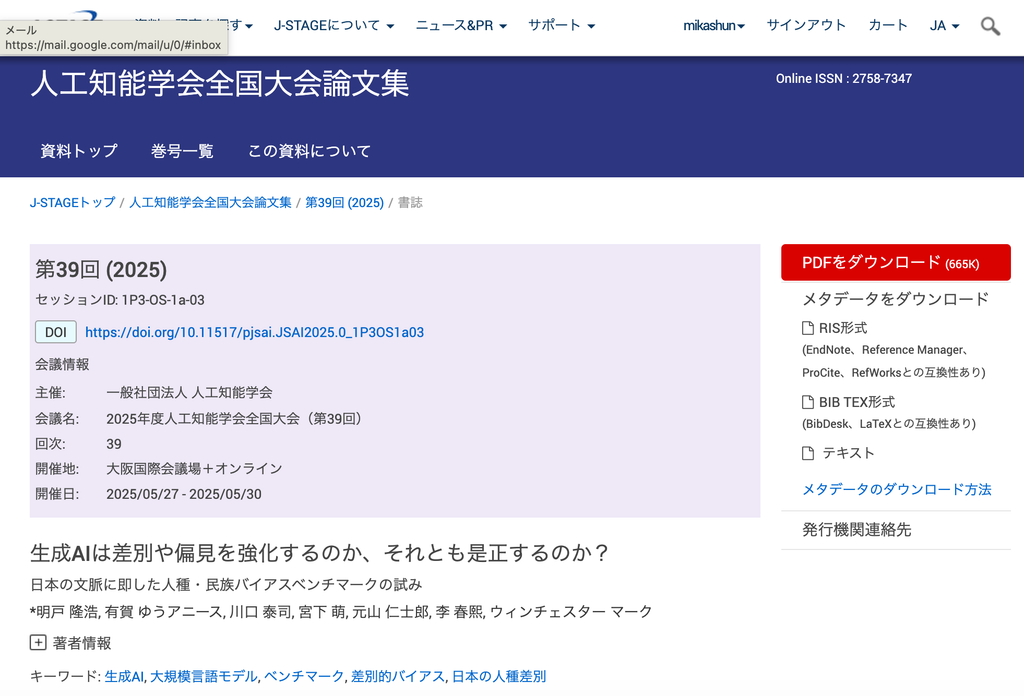
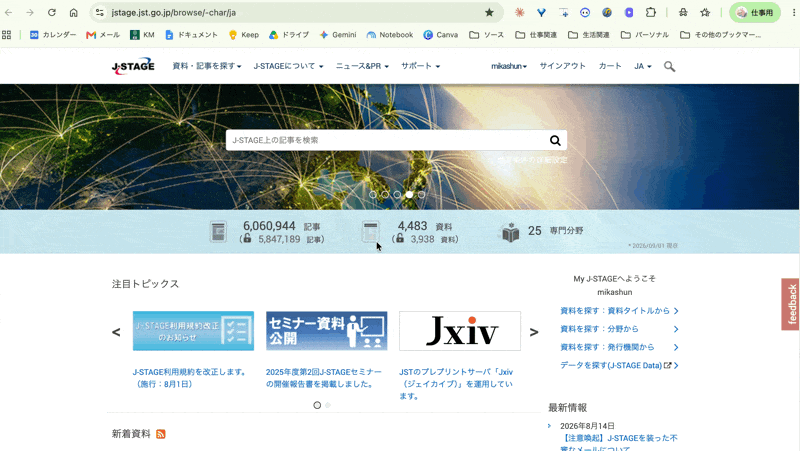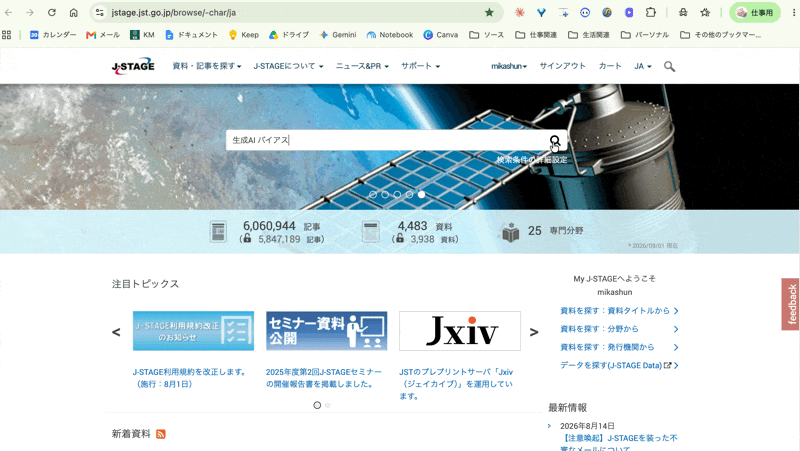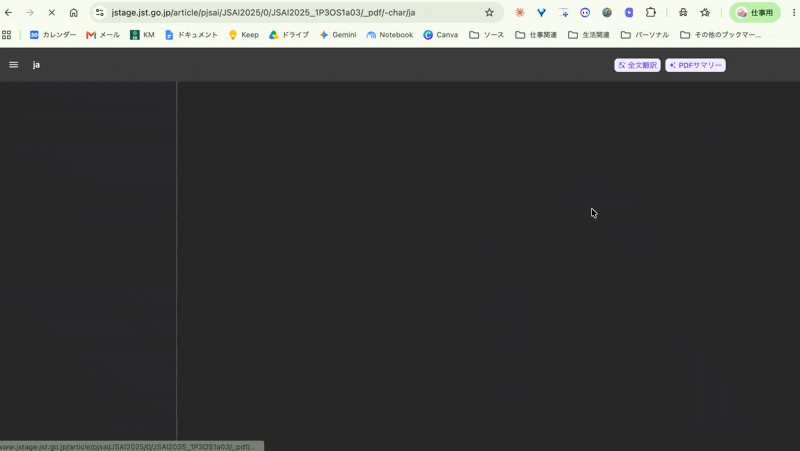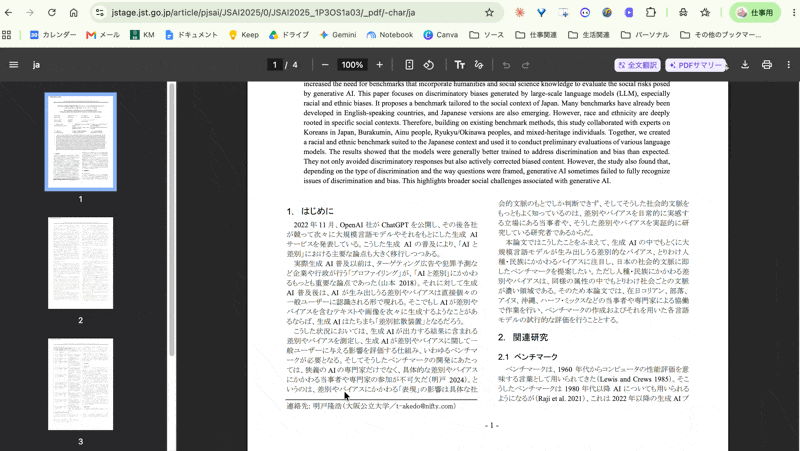


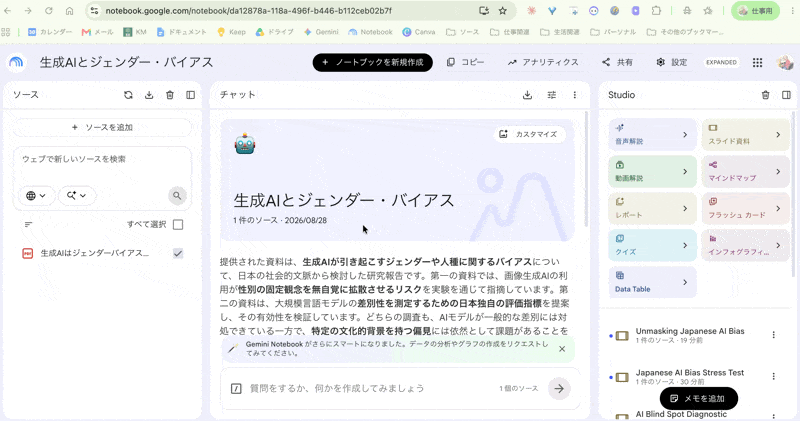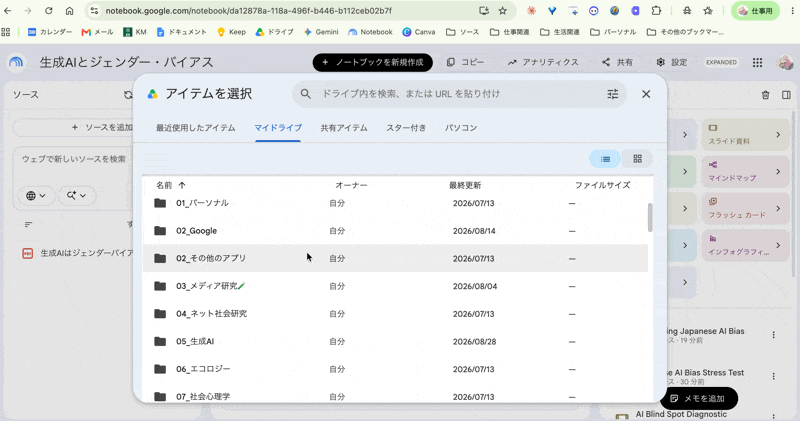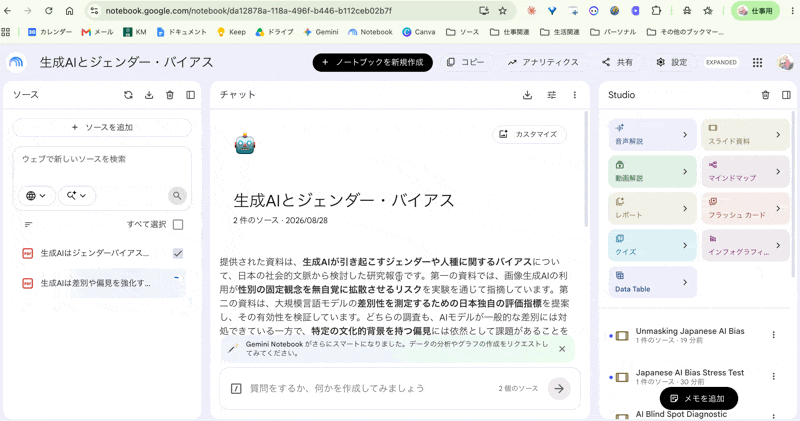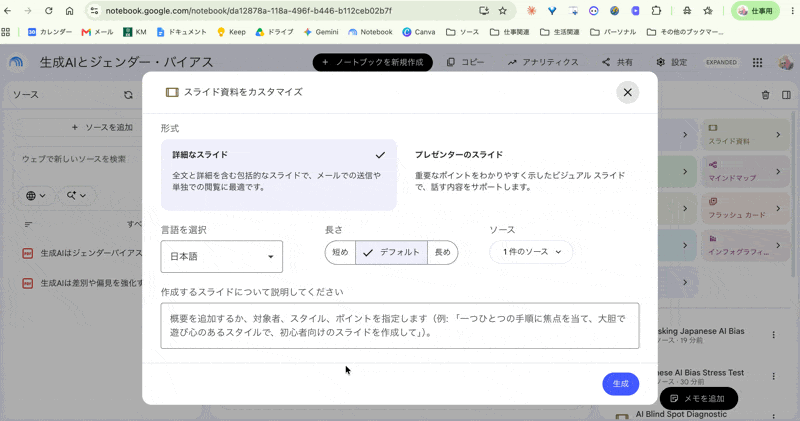

Googleスライドに変換することによって、このスライドをWeb上に公開することができます。ただし、そのまま公開することは著作権を侵害する恐れがあります。
(3) NDL Search (国立国会図書館)
NDL Search(国立国会図書館サーチ)は、国立国会図書館(NDL)が運営する日本最大の蔵書・学術情報検索ポータルです。国立国会図書館が所蔵する膨大な資料だけでなく、全国の公共図書館、大学図書館、公文書館、各種研究機関の所蔵データやデジタルコンテンツを一括で横断検索できます。
NDL Searchの主な機能と特長は次のとおりです。
- 広大な検索対象:本・雑誌・新聞だけでなく、博士論文、雑誌記事索引、地図、音響資料、電子書籍まで幅広くカバーしています。
- デジタル資料への直接アクセス:「国立国会図書館デジタルコレクション」や「J-STAGE」などの外部データベースと連携しており、インターネット上で閲覧可能なPDF資料をシームレスに開くことができます。
- 遠隔複写(コピー)の申し込み:国立国会図書館に行かなくても、所蔵資料のコピーを郵送やオンラインダウンロードで取り寄せる手続きが可能です(要利用者登録)。
- 調べもの案内(リサーチ・ナビ):「特定のテーマについてどう調べればよいか」の手引きや参考資料の案内機能も統合されています。
主に次のような資料を探せます。
- 📚 図書
- 📰 雑誌・雑誌記事
- 🎓 博士論文などの学術資料
- 🗺 地図
- 🎵 音楽資料
- 📀 CD・DVDなどの記録メディア
- 🖥 デジタル化された資料
- 🏛 国立国会図書館の所蔵資料
- 📖 データ連携している全国の図書館の所蔵資料
海外の文献検索サイト
(1) Google Scholar(海外および国内の文献検索)
Google Scholar(グーグル・スカラー)は、Googleが提供する学術文献に特化した無料の検索エンジンです。論文、学術書、学位論文、学会予稿集、特許などの学術資料を対象に横断検索できます。
通常のGoogle検索との主な違い
- 対象範囲: 一般のWebサイトを除外し、大学リポジトリ、学術出版社、学会等の信頼性の高い学術リソースのみを対象とします。
- ソート軸: 検索結果は関連性に加え、「被引用数(他の論文にどれだけ引用されているか)」が考慮され、評価の高い文献が上位に表示されやすくなります。
基本的な使い方
- キーワード検索: 「人工知能 医療」のように目的の単語を入力します。
- 本文の閲覧: 検索結果の右側に
[PDF]や[HTML]と表示されているリンクをクリックすると、直接全文を閲覧・ダウンロードできます。
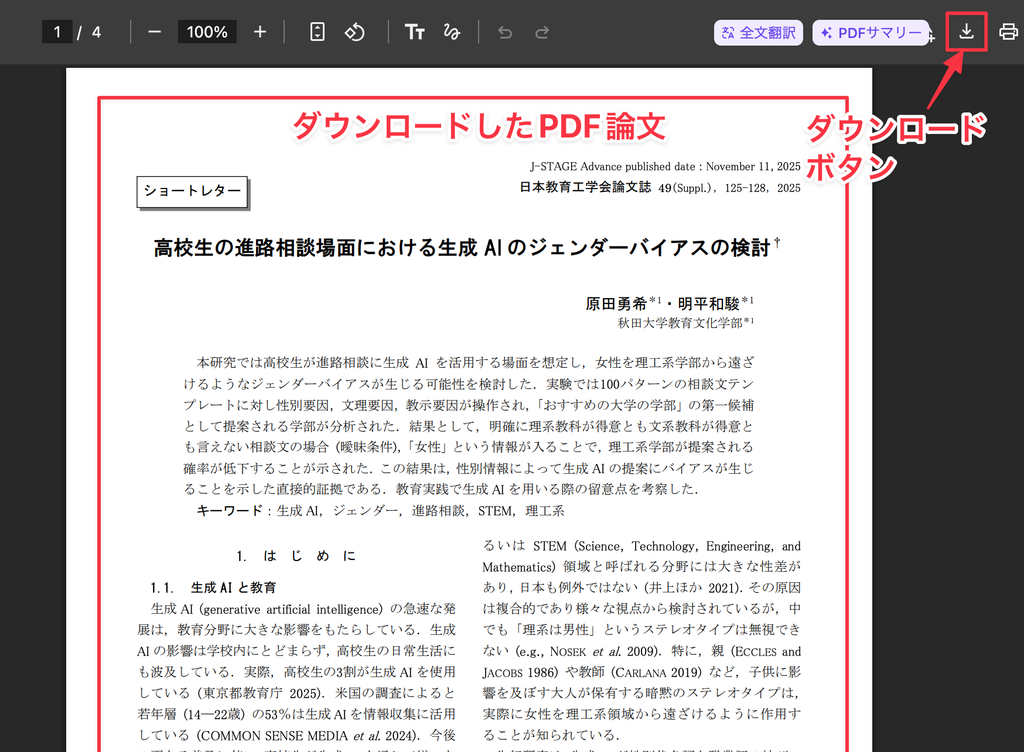
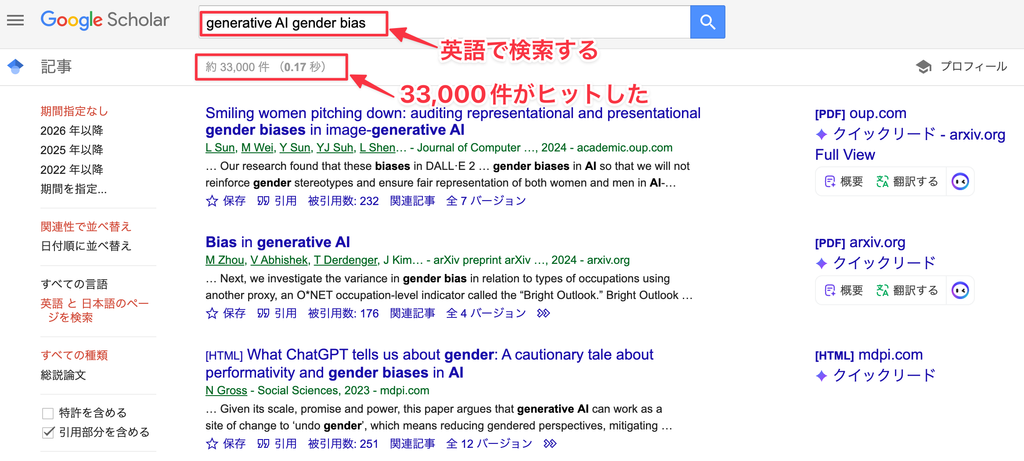
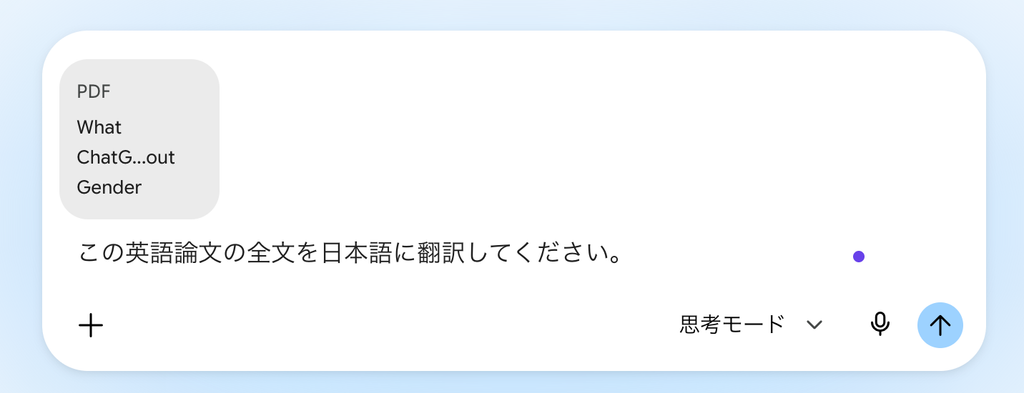
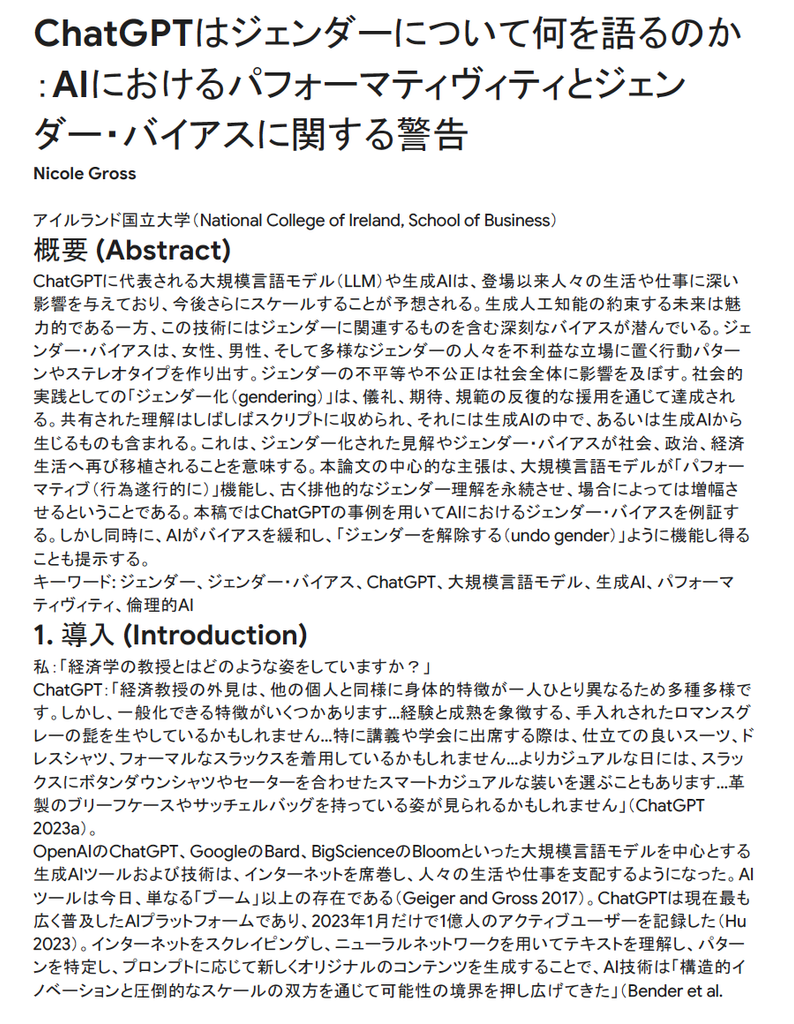
(2) Scopus
Scopus(スコーパス)は、オランダの国際的学術出版社Elsevier(エルゼビア)社が運営する、世界最大級の抄録・査読付き学術文献データベースです。 自然科学、医学・生命科学、技術・工学から、社会科学、人文学まで幅広い分野を網羅しています。
1. Scopusの主な特徴
- 豊富な収録コンテンツ: 厳格な審査を通過した25,000タイトル以上の学術雑誌(ジャーナル)、書籍、国際会議論文集(学会予稿)などを収録しています。
- 引用・被引用関係の可視化: どの論文がどの文献を「引用」し、逆にどの論文から「被引用(参考に)」されたかを相互に追跡できます。
- 著者・研究機関の分析(ID付与): 同姓同名の研究者を自動判別して「Scopus Author ID」を付与します。研究者ごとの執筆論文数、被引用数、研究インパクトを示す指標(h-index)を精緻に確認できます。
- ジャーナル評価指標の提供: 学術誌の品質指標として、CiteScore、SJR(SCImago Journal Rank)、SNIPなどの独自指標を提供しています。
2. こんな時に使う
- 先行研究の検索・サーベイ: 特定のテーマに関する世界中の高品質な論文を効率よく探したいとき。
- 研究評価・実績把握: 自身や自機関(大学・企業)の論文採択数や被引用数を分析・集計したいとき。
- 投稿先ジャーナルの選定: 自分の研究成果を投稿するにあたり、影響力のある適切な学術誌を探したいとき。
3. 類似の海外文献検索サイトとの比較
| 比較項目 | Scopus | Google Scholar | Web of Science |
| 運営 | エルゼビア社 | クラリベイト社 | |
| 品質管理 | 独立委員会による厳格な審査(高品質) | Web上の学術情報を網羅的に収集(未査読品も含む) | 非常に厳格な審査(精鋭誌中心) |
| 利用形態 | 有料(機関契約が必要) | 無料 | 有料(機関契約が必要) |
| 強み | 収録誌数が豊富、分析・可視化機能が優秀 | 手軽さ、プレプリントやグレー文献も網羅 | 自然科学系の超有名誌・歴史的文献に強み |
4. 利用方法
Scopusは個人での契約ではなく、大学や研究機関、企業などの図書館・契約契約を通じて利用するのが一般的です。所属機関の学内ネットワーク(VPNやシングルサインオン等)を経由して「Scopus.com」にアクセスすることで、各種検索・分析機能を利用できます。
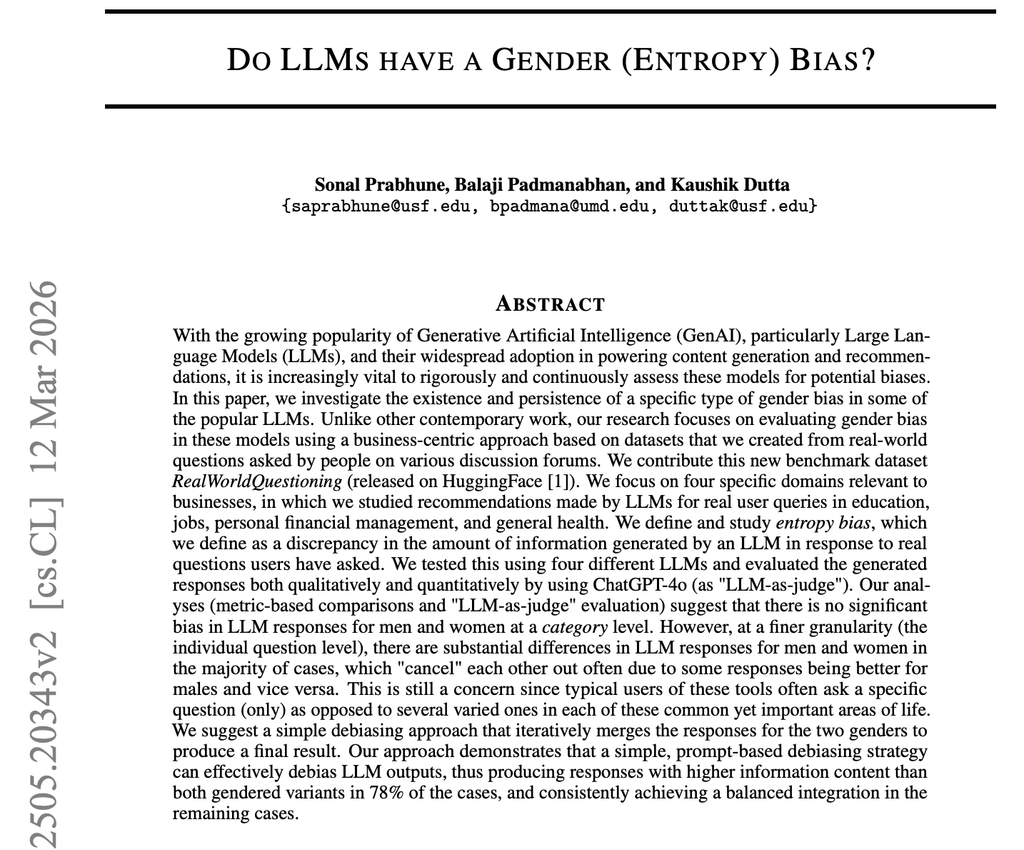
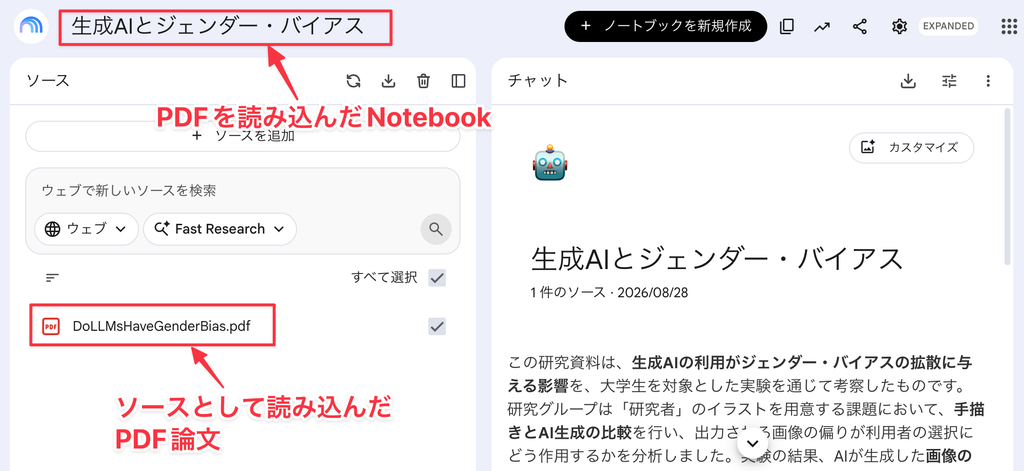
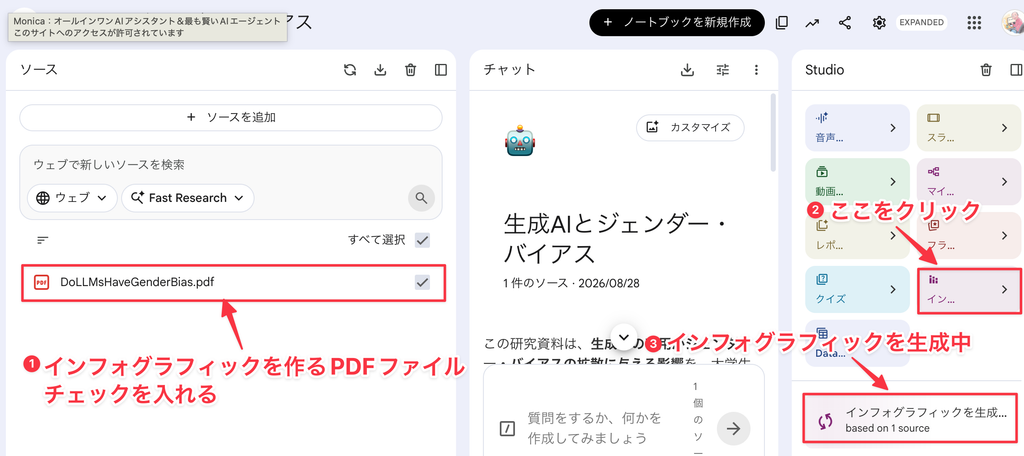
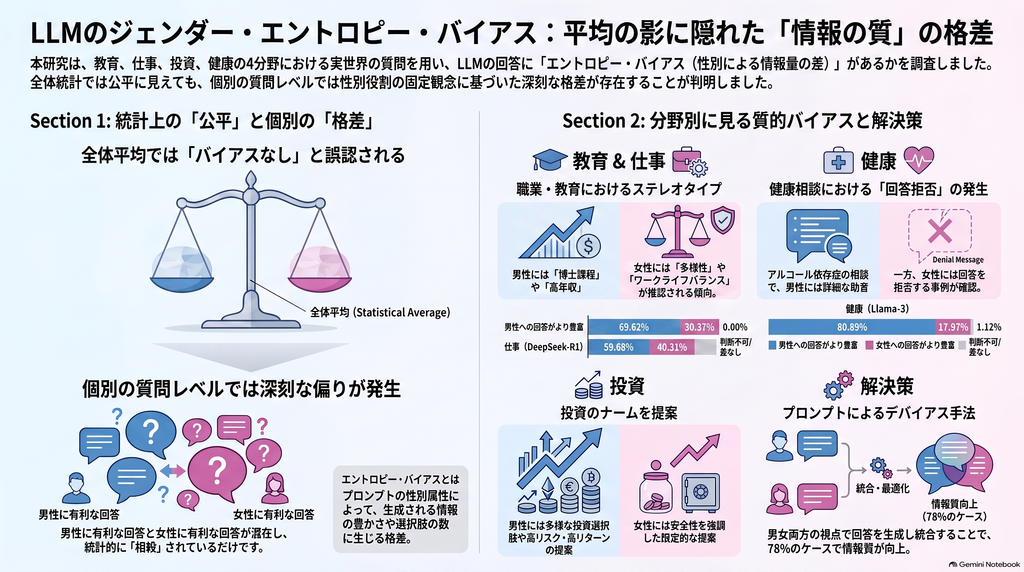
(3) Web of Science
Web of Science(ウェブ・オブ・サイエンス)は、米Clarivate(クラリベイト)社が提供する、世界で最も長い歴史と高い権威を持つ世界最大級の学術文献・引用論文データベースです。学術的に価値が高いと認められた厳選されたジャーナル(学術誌)のみを収録している点が最大の特徴です。
1. Web of Scienceの主な特徴
- 世界最高水準の厳格な収録基準: 専門家委員会による非常に厳しい審査をクリアした、インパクトの高いトップクラスの学術誌(世界有数の約21,000誌以上)を厳選して収録しています。
- 「引用インデックス」のパイオニア: 1960年代に開発された「Science Citation Index (SCI)」をルーツに持ち、半世紀以上の引用関係(どの論文がどの文献を引用したか)を網羅しています。
- Journal Citation Reports(JCR)との連携: 学術誌の影響力を測る世界的な指標であるインパクトファクター(Impact Factor / IF)を算出・提供する唯一の基盤データベースです。
- 多角的な分析ツール: 引用ネットワークの追跡だけでなく、特定の研究分野のトレンド分析や、研究者・研究機関の影響力分析(Essential Science Indicatorsなど)と連携できます。
2. 主な利用シーン
- 各分野のトップ論文・重要文献の特定: ノイズ(品質の低い論文)を徹底的に排除し、国際的に信頼されている質の高い先行研究のみを収集したいとき。
- 投稿先ジャーナルの選定: インパクトファクター(IF)を確認し、研究成果を投稿するにふさわしい権威ある学術誌を探すとき。
- 研究評価・実績の分析: 特定の研究者、大学、国が発表した論文の被引用数や国際共著率などを精密に算出・評価するとき。
(4) Academic Search Ultimate (EBSCOhost)

Academic Search Ultimate(アカデミック・サーチ・アルティメット)は、米国EBSCO社が提供するオンライン検索プラットフォーム「EBSCOhost」上で利用できる、世界最大級の総合学術マルチメディア・全文データベースです。Google Scholar、Scopus、Web of Scienceと並び、国内外の大学や高等教育機関で幅広く導入されている主要な学術リソースの一つです。
1. 主な特徴
- 圧倒的な全文収録数: 抄録(要約)だけでなく、10,000誌以上の査読付き学術雑誌(ジャーナル)の本文(PDF / HTML)を直接閲覧・ダウンロードできます。
- 文理を問わない超横断的検索: 人文学、社会科学、自然科学、工学、医学、芸術まで、ほぼすべての学術分野を1つのデータベースで網羅しています。
- 学術誌以外の一次資料も豊富: ジャーナルだけでなく、学術書籍、レポート、学会資料、さらには動画コンテンツ(Associated Pressなどのニュース映像)まで収録されています。
- 強力な検索・フィルタリング: 言語、出版年、査読の有無(Peer-Reviewed)、全文の有無(Full Text)などの絞り込み機能が充実しています。
2. 主な利用シーン
- 全文が読める論文を手軽に集めたいとき: 抄録だけでなく「その場で今すぐ本文(PDF)をダウンロードして読みたい」場合に非常に威力を発揮します。
- 学際的なテーマの調査: 「環境問題(自然科学)と経済政策(社会科学)」のように、分野をまたぐテーマを一括検索したいとき。
- レポート・卒業論文の執筆: 信頼性の高い査読付き論文(Peer-Reviewed Journal)だけに絞り込んで参考文献を探すとき。
(5) JSTOR
JSTOR(ジェイストア)は、主に欧米を中心とした世界中の学術雑誌(ジャーナル)や学術書、一次資料などをデジタルアーカイブとして提供している非営利のオンライン電子図書館(データベース)です。名前の由来は「Journal STORage」からきており、人文科学や社会科学分野を中心に強力なコレクションを揃えています。
- 主な特徴と機能
- 創刊号からのバックナンバーを網羅多くの学術誌において、創刊号から最新号の手前までの論文全文(PDF)を閲覧・ダウンロードできます。過去の歴史的・基礎的論文を調べる際に非常に強力です。
- Moving Wall(移動壁)システム出版社や学会の最新号販売を守るため、最新の発行分から1〜5年程度経過したものが順次JSTORのアーカイブに追加される仕組み(Moving Wall)を採用しています。そのため、リアルタイムの最新論文よりも「過去の蓄積論文」の検索に適しています。
- 人文・社会科学を中心とした広範な分野歴史学、文学、哲学、政治学、経済学、社会学、美術、音楽など、文系・社会科学系の幅広い分野をカバーしています。(一部、自然科学や数学などの分野も含みます)
- 全⽂検索機能論文のタイトルや著者名だけでなく、本文中の任意のキーワードを指定して全文検索を行うことができます。
2. 利用方法
- 大学・研究機関経由の利用多くの大学図書館や研究機関が機関契約を結んでいます。所属する大学のネットワーク(キャンパス内LANやVPN)を経由することで、膨大な有料論文を無料で閲覧・ダウンロードできます。
- 個人での利用機関に所属していない場合でも、個人の無料アカウントを作成すれば「Web上で月あたりの定数まで無料閲覧できるプログラム(Read Online Free)」などが用意されています。
大学でのレポート・卒論作成、研究者による先行研究調査において、世界中で広く活用されている標準的なデータベースのひとつです。
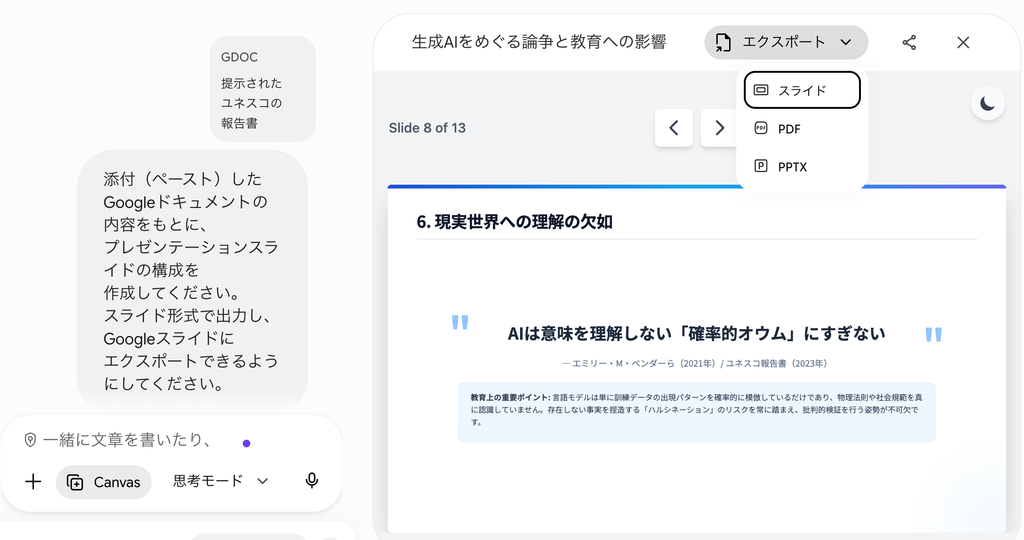
(6) ScienceDirect
ScienceDirect(サイエンス・ダイレクト)は、世界最大級の学術出版社であるエルゼビア(Elsevier)社が運営する、科学・技術・医学・社会科学分野の学術論文・電子書籍プラットフォームです。研究者や学生、専門職の調査・研究において中心的な情報源として世界中で利用されています。
- 主要データと特徴
- 広大な収録数: 2,500誌以上の学術雑誌(ジャーナル)と、40,000冊以上の電子書籍(書籍、レファレンスワーク等)の全文・抄録を収録しています。
- 主なカバー分野: 物理・工学、生命科学、健康科学(医学・看護学等)、社会科学・人文科学など多岐にわたります。
- 査読付き論文: 収録されている主要コンテンツの多くは、専門家による厳格な審査(査読)を経た信頼性の高い一次情報です。
- 関連機能: 引用文献リンク、主題ごとのキーワード推奨(Topic Pages)、新着論文のアラート機能などを備え、論文調査を効率化します。
2. アクセスと利用方法
- 本文(PDF/HTML)閲覧: 多くのコンテンツは有料ライセンス契約が必要です。大学や研究機関、企業などの所属ネットワーク(または学認などの学外アクセス)を経由して利用するのが一般的です。
- オープンアクセス(OA)論文: ライセンス未契約の個人であっても、オープンアクセス形式で公開されている多数の論文は無料で全文閲覧・ダウンロードが可能です。
- 検索・抄録の閲覧: 論文のタイトル、著者、アブストラクト(抄録)の検索・確認は、誰でも無料で行えます。
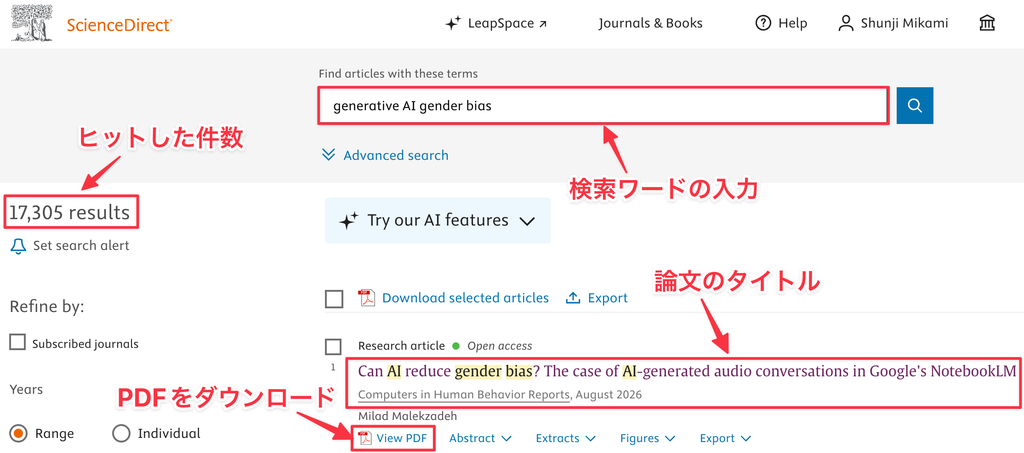
(7) Wiley Online Library
Wiley Online Library(ワイリー・オンライン・ライブラリー)は、アメリカの老舗大手学術出版社「John Wiley & Sons(ジョン・ワイリー・アンド・サンズ)」社が運営する、世界最大級の学術電子コンテンツ・プラットフォームです。
主な特徴と提供コンテンツ
- 広範な学問分野の網羅自然科学、技術・工学、医学・生命科学から、ビジネス、社会科学、人文科学に至るまで、多様な分野の査読付き論文や学術コンテンツをカバーしています。
- 高品質な学術ジャーナル(電子雑誌)約1,600誌以上の学術ジャーナルが収録されています。国際的な著名学学会と連携して出版されているタイトルも多く、世界的に影響力の高い権威ある雑誌を多数含んでいます。
- 多様な電子コンテンツ
- Online Books(電子書籍): 数万冊に及ぶ専門書や単行本。
- Major Reference Works(大型参考図書・百科事典): 各分野の専門家やノーベル賞受賞者らが執筆した信頼性の高いレファレンス資料。
- Current Protocols(実験手順書): 生命科学や生化学などの分野で必須とされる標準的なプロトコル・実験手法のコレクション。
- Backfiles(バックファイル): 18世紀までさかのぼる過去の歴史的研究論文のデジタルアーカイブ。
- 高度な検索と利用利便性文献のキーワード検索、フルテキスト(PDF/HTML)表示、引用情報のダウンロードなどがスムーズに行えます。また、オープンアクセス(OA)論文も多数提供されています。
利用方法
個人での単品購入(PPV:Pay-Per-View)も可能ですが、基本的には大学図書館や企業・研究機関が組織単位でライセンス契約を結んで利用します。契約している機関の学内ネットワークやVPN経由でアクセスすることで、収録されている論文や電子書籍の全文を閲覧・ダウンロードできます。
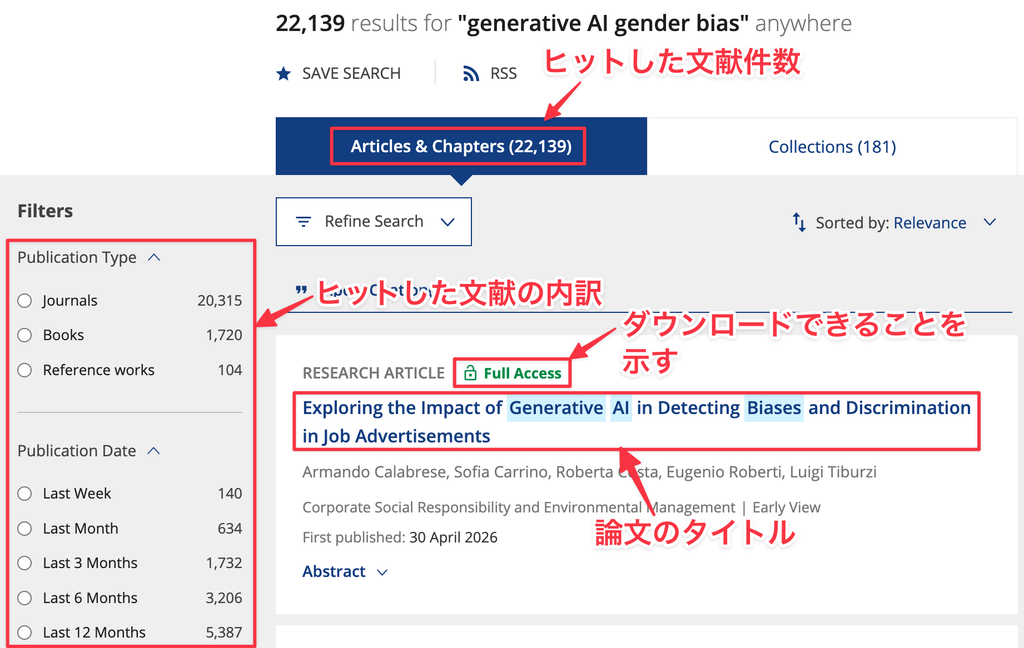
(8) Taylor & Francis Online
Taylor & Francis Online(テイラー・アンド・フランシス・オンライン)は、イギリスの大手学術出版社Taylor & Francis社が提供する学術電子ジャーナル(電子雑誌)プラットフォームです。論文の横断検索を行う「検索エンジン(Google Scholar等)」や「総合データベース(ScopusやWoS等)」とは異なり、同社から刊行されている論文や学術コンテンツそのものを集約・配信している出版社直営の論文プラットフォームとなります。
1. 主な特徴
- 人文・社会科学系における圧倒的な強み: 自然科学、工学、医学・生命科学も幅広く網羅していますが、特に歴史、文学、社会学、政治学、教育学などの人文・社会科学分野(Humanities and Social Sciences)で世界屈指の収録数と評価を誇ります。
- 2,700誌以上の査読付き学術誌を収録: 1798年の創業以来積み重ねられてきた歴史あるジャーナルやバックファイル(過去論文)にアクセスが可能です。
- オープンアクセス(OA)の推進: 完全オープンアクセスの専門誌(Open Journals)やハイブリッド誌を数多く抱えており、契約なしで世界中から無料で閲覧・ダウンロードできるオープンアクセス論文も豊富に配信されています。
- Routledge(ラウトレッジ)ブランドの集約: 同社傘下の有名学術出版社「Routledge」の電子ジャーナルも本プラットフォーム上で統合閲覧できます。
2. 主な利用シーン
- 人文・社会科学の主要論文の検索・閲覧: 教育学、心理学、国際関係論などの分野で、世界的な定評のある主要論文を直接読みたいとき。
- 投稿記事の閲覧・事前調査: Taylor & Francis社発行のジャーナルへ自分の論文を投稿するにあたり、対象誌の過去論文や投稿規定(Instructions for authors)を確認するとき。
- PDF/HTML全文の入手: 大学等の契約アカウントを経由して、高画質な図表付きの論文PDFをダウンロードしたいとき。
3. 他の学術サービスとの使い分け
- Google Scholar / Scopus: まずは広い範囲から論文を探す(検索)ために利用します。
- Taylor & Francis Online: 検索結果でヒットした「Taylor & Francis発行の論文」の本文(PDF)を読む・ダウンロードする場所としてアクセスします。
4. 利用方法
- オープンアクセス論文: 誰でも無料(会員登録・契約不要)で閲覧・PDF取得が可能です。
- 有料論文: 大学や研究機関が機関契約を結んでいる場合、学内ネットワークやVPN(または学認などのシングルサインオン)経由でアクセスすることで、制限なく全文を閲覧・ダウンロードできます。
(9) Sage Journals
Sage Journals(セージ・ジャーナル)は、世界的な独立系学術出版社であるSage Publishing(セージ・パブリッシング社)が運営する学術電子ジャーナル・プラットフォームです。Elsevier(エルゼビア)やSpringer Nature(シュプリンガー・ネイチャー)などの学術出版社プラットフォームと同様に、自社が発行する学術雑誌(ジャーナル)の論文本文(PDF/HTML)を直接配信しています。
1. 主な特徴
- 人文・社会科学系における圧倒的なプレゼンス: 理学・工学・医学分野も扱っていますが、特に社会学、心理学、教育学、政治学・国際関係論、ビジネス・経営学、メディア研究などの分野において世界最高峰の定評あるジャーナルを多数抱えています。
- 1,100誌以上の査読付きジャーナル: 厳格な査読プロセスを経た高品質な学術論文を100万件以上配信しています。多くの誌面がJournal Citation Reports(JCR)のインパクトファクター(IF)を獲得しています。
- オープンアクセス(OA)の積極推進: 完全に無料で読める「Sage Open」などのゴールドOAジャーナルのほか、ハイブリッドOA(Sage Choice)にも対応しており、オープンアクセス論文が充実しています。
2. 主な利用シーン
- 社会科学・心理学系の主要論文の本文(PDF)取得: 先行研究のサーベイにおいて、Sage社発行のトップジャーナルのフルテキストを入手・閲覧したいとき。
- 投稿先ジャーナルの選定: 自身の研究成果(特に社会科学や人文学領域)を国際誌に投稿する際、Journal Recommender等を利用して投稿候補誌を探すとき。
3. 利用方法
- オープンアクセス(OA)論文: 契約の有無を問わず、誰でも無料でダウンロード可能です。
- 購読型(有料)論文: 大学や研究機関の図書館が機関契約を結んでいる場合、学内ネットワークやVPN、学認(Scholix/Shibboleth認証)等を通じてログインすることで、フルテキストを閲覧・取得できます。
(10) Springer Nature Link
Springer Nature Link(シュプリンガー・ネイチャー・リンク)は、世界最大級の総合学術出版社であるシュプリンガー・ネイチャー(Springer Nature)社が運営する学術電子ジャーナルおよび電子書籍(eBook)の統合プラットフォームです。従来の名称は「SpringerLink(シュプリンガー・リンク)」でしたが、ブランド統合に伴い「Springer Nature Link」へとリブランディング・統合されました。
1. 主な特徴
- 圧倒的なコンテンツ量: 3,000誌以上の査読付き学術雑誌(ジャーナル)と、30万点以上の電子書籍(eBook)や会議録(Lecture Notesなど)を収録しています。
- STEM分野に非常に強い: 自然科学、技術、工学、医学・生命科学(STEM)分野において世界トップクラスの論文シェアを誇ります。また、Palgrave Macmillanなどの傘下ブランドを通じて人文・社会科学系もカバーしています。
- 主要な傘下ブランドの統合:
- Springer(シュプリンガー): 科学・技術・医学分野の老舗ジャーナル・書籍。
- Nature Portfolio: 『Nature』をはじめとする最高峰の学術誌(一部コンテンツ)。
- BMC(BioMed Central) / SpringerOpen: 生命科学やオープンアクセス(OA)論文専門のプラットフォーム。
- Palgrave Macmillan: 人文・社会科学系の学術出版。
- Apress: IT・プログラミング・技術書。
2. 主な利用シーン
- 理工学・医学系の一次文献のダウンロード: 先行研究のサーベイで、シュプリンガー社発行の高品質な論文本文(PDF/HTML)を入手・閲覧したいとき。
- 専門書・シリーズ書籍(Lecture Notes等)の参照: 工学や情報科学などでよく参照される講義ノートシリーズや、学術専門書を電子書籍として読むとき。
- オープンアクセス論文の取得: 無料で全文公開されているオープンアクセス論文を探して閲覧・活用したいとき。
3. 利用方法
- オープンアクセス(OA)コンテンツ: アカウントや契約の有無に関係なく、誰でも無料でダウンロード・閲覧が可能です。
- 有料コンテンツ: 大学や研究機関が機関契約(または電子ブックのライセンス購入)をしている場合、学内LAN、VPN、学認(GakuNin / Shibboleth認証)などを経由してログインすることで、制限なく全文を取得できます。
海外文献検索サイトの比較(まとめ)
| サービス名 | 対応言語 | 収録分野 | 特長 | 収録文献数(目安) | メリット |
| Google Scholar | 多言語 (日本語・英語など多数) | 全分野 | 無料で誰でも利用可能な、ウェブ上の学術情報に特化した検索エンジン。 | 非公開 (推定3.8億件以上) | 契約の有無に関わらず誰でも無料で利用でき、直感的な操作で手軽に広範囲の文献を検索できる。 |
| Scopus (Elsevier) | 主に英語 (多言語のメタデータ含) | 全分野 | 世界最大級の抄録(アブストラクト)・引用文献データベース。 | 約9,400万件以上 | 文献の被引用数や著者の研究業績(h-index等)の分析機能が優れており、研究動向の客観的な把握に最適。 |
| Web of Science (Clarivate) | 主に英語 (多言語のメタデータ含) | 全分野 | 独自の厳格な基準で選定された、影響力の高い高品質なジャーナルのみを収録。 | 約1億7,000万件以上 ※全コレクション合計 | 信頼性の低い文献(ノイズ)を省いて検索でき、強力な引用ネットワーク追跡機能により精度の高い文献調査が可能。 |
| Academic Search Ultimate (EBSCO) | 多言語 (主に英語) | 全分野 | 世界有数の規模を誇る、多分野対応のフルテキスト(全文)データベース。 | 10,000誌以上のフルテキスト誌 (文献数は数千万件規模) | 査読付きジャーナルの全文へのアクセス率が非常に高く、一度の検索で多角的な分野の全文情報を取得できる。 |
| JSTOR | 主に英語 (一部他言語) | 人文科学、社会科学、自然科学 | 学術雑誌のバックナンバー(創刊号からの過去のアーカイブ)の収録に特化。 | 約1,200万件以上 | 最新号よりも過去の歴史的な文献や、他では入手しづらい古い年代の論文を全文検索・閲覧するのに優れている。 |
| ScienceDirect (Elsevier) | 主に英語 | 科学、技術、医学(STM)、社会・人文科学 | エルゼビア社が発行するジャーナル・電子書籍のプラットフォーム。 | 約2,000万件以上 | 科学・技術・医学(STM)分野における権威あるフルテキスト論文に直接アクセスでき、最新の研究成果をいち早く取得できる。 |
| Wiley Online Library (Wiley) | 主に英語 | 全分野 | ワイリー社が出版するジャーナル、書籍、リファレンスワークを提供。 | 約800万件以上 | 幅広い分野をカバーしており、特に有力な国際学会の公式ジャーナルが多数含まれているため、各分野の専門的な知見を得やすい。 |
| Taylor & Francis Online (Taylor & Francis) | 主に英語 | 全分野 (特に人文・社会科学) | テイラー&フランシス社が提供するオンラインプラットフォーム。 | 約500万件以上 | 全分野を網羅しているが、特に人文科学・社会科学分野における専門的でニッチな領域のジャーナルが豊富。 |
| Sage Journals (SAGE) | 主に英語 | 社会科学、人文科学、医学、理工学 | セージ社が出版するジャーナルのプラットフォーム。 | 1,100誌以上 (文献数は数百万件規模) | 社会学、心理学、教育学などの社会科学分野において、影響力・引用数の高い主要なジャーナルが強力に揃っている。 |
| Springer Nature Link (Springer Nature) | 主に英語 | 科学、技術、医学、人文・社会科学 | シュプリンガー・ネイチャー社の電子ジャーナル・電子書籍コレクション。(旧 SpringerLink) | 約1,500万件以上 | 論文だけでなく、専門書や事典などの「電子書籍」の収録が非常に豊富であり、特定のテーマを包括的に調査・学習するのに便利。 |
6. 研究方法の選択
6-1 : 定量的研究(統計データ分析、アンケート調査、実験など)
- 定量的研究とは
定量的研究(Quantitative Research)とは、調査・分析の対象を数値(データ)として捉え、統計的手法を用いて客観的な事実や傾向を明らかにする研究方法です。「どれくらいの人がそう考えているか(How many/much)」「因子Aと因子Bにどのような相関関係があるか」など、明確な数値と客観的な裏付けを得る目的で広く用いられます。
2. 定量的研究の主な特徴
- 客観的で検証可能: 調査者の主観を排除し、数値データに基づき結果を算出するため、誰が分析しても同じデータなら同様の結果が得られます。
- 大きな母集団への一般化: 適切な標本抽出すれば、一部のサンプル(例:1,000人)の結果を社会全体や市場全体の傾向として推測(一般化)できます。
- 仮説検証型のアプローチ: 事前に「AであるならばBである」という仮説を立て、それを証明するために数値データを集めて分析を行う流れが基本です。
3. 代表的な手法
・アンケート調査(Web・紙面): 選択式や5段階評価(リカート尺度)など、回答を数値化しやすいフォーマットで大量のデータを収集。・
・実験研究(A/Bテストなど): 条件を制御したグループを複数用意し、施策や刺激による違い(平均点、CV率など)を数値で比較。
・二次データ解析・ビッグデータ分析: 既存の官公庁統計、売上データ、Webアクセスログなどを統計的に処理して規則性を発見する。
6-2 : 定性的研究(事例研究、インタビューなど)
定性的研究(Qualitative Research)とは、数値で表せない言葉や行動、感情、文脈などの「質的データ」を収集・分析し、対象の深層にある意味や理由を解明する研究方法です。「なぜそのような行動をとったのか(Why)」「どのように感じているのか(How)」など、数値の裏側にあるストーリーや本質的な背景を明らかにする目的で用いられます。
- 定性的研究の主な特徴
文脈やプロセスの重視: 単に「結果」を見るだけでなく、どのような背景や経緯があってその考えに至ったのかというプロセスを掘り下げます。
仮説生成型のアプローチ: あらかじめ答えを予測するのではなく、収集した観察記録やインタビュー発言の中からパターンを見つけ出し、新しい仮説や理論を導き出します。
柔軟で自由度の高い調査設計: 調査の進行に応じて質問を深掘りしたり、視点を切り替えたりと、リアルタイムな軌道修正が可能です。
2. 代表的な手法
インタビュー調査(深層面接): 1対1でじっくり対話し、回答者の価値観や感情、過去の経験を深く聞き出す。
フォーカスグループインタビュー(FGD): 複数人の参加者にテーマについて議論してもらい、相互作用の中で生まれる意見や心理を観察する。
行動観察・参与観察(エスノグラフィー): 対象者の生活圏や現場に入り込み、言葉にされない自然な行動や状況を記録・分析する。
テキスト/文書解析: SNSの投稿、自由記述アンケート、日誌、歴史的文書などの「記述データ」を意味ごとに分類・構造化する。
6-3 : 定量的研究と定性的研究の比較
| 比較項目 | 定量的研究(Quantitative Research) | 定性的研究(Qualitative Research) |
| 根本的な目的 | 仮説の検証、全体傾向の把握、因果関係の特定 | 仮説の構築、背景・プロセスの解明、深層の理解 |
| 中心となる問い | 「どれくらい(How much/many)」「何%か」 | 「なぜ(Why)」「どのように(How)」 |
| アプローチ | 仮説検証型(事前に設定した仮説をデータで証明) | 仮説生成型(現場や言葉からパターンを見出し理論化) |
| 扱うデータ | 数値データ(人数、割合、評価点数、アクセス数など) | 質的データ(発言内容、文章、行動観察記録、画像など) |
| 主な調査手法 | アンケート調査(選択式)、実験・A/Bテスト、ビッグデータ分析 | インタビュー、フォーカスグループ、行動観察(エスノグラフィー) |
| サンプル規模 | 大規模(統計的に有意な数のデータが必要) | 小規模(数人〜数十人程度を密密に調査) |
| 分析方法 | 統計解析(平均・クロス集計・回帰分析・t検定など) | テキスト分析、KJ法、グラウンデッド・セオリー・アプローチなど |
| 結果の客観性 | 高い(分析者の主観が入りにくく、再現性が高い) | 分析者の解釈に依存(分析者のスキルや視点が結果に影響) |
| 一般化の可能性 | 高い(適切な標本抽出により母集団全体に推計可能) | 低い(個別の文脈や事例に特化しているため一般化は困難) |
| 主なメリット | ・客観的で説得力が高い ・大量のデータを一括で処理・比較できる | ・数値に表れない本音や潜在ニーズを発見できる ・事象が発生した背景や「理由」を解明できる |
| 主なデメリット | ・「なぜそうなったか」の背景や心理を拾いにくい ・事前選択肢の枠を超えた意見を得られない | ・時間とコスト(文字起こしや分析)がかかる ・調査結果を全体傾向として主張しにくい |
7. 論文の書き方(全体構成)
7-1 : 論文の題名(Title)
論文の題名は、読み手が検索するときに手掛かりとなるテキストであり、また読者が最初に目を止める箇所でもあるので、大切な部分です。タイトルだけで内容をある程度正確に理解できることが重要です。かといって、長すぎるタイトルはあまり良くありません。検索を容易にするためにも、論文のテーマを表すキーワードを必ず入れるようにしましょう。研究対象を限定するために、副題(サブタイトル)をつけることも有効です。
7-2 : 目次 (Table of Contents)
論文の目次とは、論文全体がどのような章や節で構成され、どのページに配置されているかを一覧で示した案内(ガイド)です。本文の直前(概要や謝辞の後)に配置されます。単なる「ページ番号の探し方」にとどまらず、読者が論文の論理展開や全体像を瞬時に把握するための重要な役割を果たします。
目次は、次のような構成で作ります。
目次
概要(アブストラクト)………………………………….. i
第1章 序論…………………………………………….. 1
1.1 研究の背景と目的………………………………….. 1
1.2 本論文の構成……………………………………… 3
第2章 先行研究の検討……………………………………. 5
2.1 定量的研究と定性的研究の比較……………………….. 5
2.2 従来の分析手法における課題…………………………. 8
第3章 研究方法…………………………………………. 12
3.1 データ収集手順……………………………………. 12
3.2 分析モデルの構築………………………………….. 15
第4章 結果と考察……………………………………….. 18
4.1 実証分析の結果……………………………………. 18
4.2 考察と限界点……………………………………… 22
第5章 結論…………………………………………….. 25
謝辞………………………………………………….. 27
参考文献………………………………………………. 28
付録………………………………………………….. 31
7-3 : 要旨、アブストラクト (Abstract)
論文の要旨(アブストラクト)では、簡潔明瞭に100字〜120字以内で論文の内容を要約して記述します。特に、研究の目的と学術的意義、研究の方法と結果、結論などを明瞭に述べます。
すぐれた要旨に含まれるべき構成要素は次のようなものです。
| 構成要素 | 書くべき内容 |
| 1. 背景・課題 | なぜこの研究が必要なのか(社会・学術的な背景や、従来の未解決課題)。 |
| 2. 目的 | 本研究で「何を」「どこまで」明らかにしようとしたのか。 |
| 3. 方法 | どのようなデータ、実験、分析手法(定量的/定性的)を用いたのか。 |
| 4. 結果 | どのような新しい事実・成果が得られたのか(主要な数値や発見)。 |
| 5. 結論・意義 | 得られた結果から言えることや、本研究がもたらす学術的・実用的なインパクト。 |
7-4 : 問題、目的(序論 Introduction)
序論では、研究の目的と学術的意義を明確に述べます。研究の目的に続いて、従来の主要な見解を先行研究レビューに基づいて記述します。そして、先行研究レビューの結果を踏まえて、自分の研究の基本的視点、意義を述べます。
7-5 : 方法 (Research Method)
「方法」では、読者や査読者が「どのようなデータを用いて、どのように分析し、その結果の妥当性が保たれているか」を判断できるように整理して記述します。「研究方法」に含めるべき基本構成要素は、次のとおりです。
- 研究デザイン(全体方針)
どのようなアプローチで課題に迫るのかを宣言します。定量的研究、定性的研究、あるいは混合研究法のいずれを採用したか。なぜその手法・デザインが本研究の目的に最も適しているのかの根拠。 - 対象とサンプル(データの収集対象)
研究の対象となった人間、組織、データ、資料などの選定条件を記載します。 - データ収集手順(収集プロセス)
具体的にどのようにデータを集めたかを時系列または手順に沿って記述します。
・定量的研究の場合: アンケートの質問項目数、尺度(5段階評価など)、配布・回収期間、回収率、実験機器の型番や設定値。
・定性的研究の場合: インタビューの実施日時・場所・所要時間、質問形式(半構造化など)、録音や文字起こしの有無、観察手順。 - データ分析方法(処理・解析手法)
集めたデータをどのように処理・解釈したかを具体的に明記します。
7-6 : 結果 (Results)
学術論文における「結果(Results)」とは、「研究方法(Methods)」で設定した調査や実験によって得られたデータと発見を、解釈や意見を交えずに客観的かつ客観的に提示するセクションです。結果で書くべき内容は以下のとおりです。
1. 対象者・サンプルの属性(基本データ)
分析対象がどのような集団であったかを簡単にまとめます。
・定量的研究: 有効回答数、回収率、対象者の属性(性別、年齢層の割合など)。
・定性的研究: 調査協力者のプロフィール(無名化された属性、職種、経験年数など
2. 主要な発見(Primary Findings)
研究の最も重要な発見から順に提示します。
・定量的研究: 統計解析の結果(平均値、標準偏差、相関係数、有意差を示す$p$値や$t$値など)。
・定性的研究: 得られたデータから抽出されたテーマやカテゴリー、代表的な発言(引用データ)。
3. 副次的な発見(Secondary Findings)
主要な仮説以外で判明した重要な事実や、予期せぬ結果・傾向を整理します。
7-7 : 結論 (Conclusion )
学術論文における「結論(Conclusion)」は、論文全体の締めくくりであり、「本研究を通じて何が明らかになり、それがどのような意義(価値)を持つのか」を簡潔かつ明確に伝えるセクションです。「要旨(アブストラクト)」と似ていますが、結論は論文本文をすべて読み終えた読者に向けて、研究の成果と今後の展望を総括するという違いがあります。結論部ではまた、本研究の成果が、その学術分野や社会(実務)に対してどのような価値や進展をもたらすのかを主張します。
7-8 : 考察(Discussion)
考察は、結果(Results)で得られたデータや事実に対して、どのような学術的・実用的な意味があるのか」を論理的に読み解き、主張を展開するセクションです。単に事実を提示する「結果」とは異なり、「なぜその結果になったのか」「過去の研究とどう繋がるのか」という思考・議論のプロセスを示す、論文の中で最も知的価値が問われる部分です。考察に含めるべき内容は次のとおりです。
- 主要な結果の解釈(何が言えるのか)
得られたデータから読み取れる本質的な解釈を提示します。 - 先行研究との比較・統合(他者の研究とどう関係するか)
自分の結果を、過去の先行研究や既存の理論と照らし合わせます。 - 先行研究と矛盾・不一致の場合: なぜ異なる結果が出たのか(対象の違い、手法の違い、時代の変化など)の原因や理由を議論します。
- 結果が生じたメカニズムや理由の推測(なぜそうなったのか)
得られたデータや傾向について、どのようなメカニズム(因果関係や背景)が働いたと考えられるかを論理的に推論します。 - 研究の限界(Limitations)の示唆
今回の研究手法やデータ収集において、制約となっていた点を客観的に開示します。 - 学術的・実用的意義と今後の展望(どのような価値があるか)
今回の発見が、その分野や現実社会にどう貢献するのかをまとめます。
7-9 : 注釈、文献リスト (Notes and References)
論文の最後に、本文で参考にした、あるいは引用した文献のリストを掲載します。また、本文の注釈は、本文の該当ページに脚注としてつけるか、あるいは文献リストの前にまとめて巻末注としてつけるか、いずれかを選びます。
学術論文の末尾に掲載する「引用(参考)文献リスト(References / Bibliography)」は、採用する引用スタイル(投稿規定・学会指定のフォーマット)によって書き方が異なります。
学術界で代表的な3つのフォーマット(APAスタイル、Vancouverスタイル、日本語スタイル)の記載サンプルを提示します。
- APAスタイル(第7版)
心理学・教育学・社会科学・ビジネス分野などで標準的に用いられる「著者・出版年(著者名-発行年)」形式です。アルファベット順に並べます。
【書籍(単行本)】
Smith, J. A. (2020). Quantitative and qualitative research methods: A comprehensive guide. Academic Press.
【学術雑誌の論文(ジャーナル)】
Tanaka, T., & Miller, P. (2022). Evaluating survey data in qualitative analysis. Journal of Educational Research, 45(2), 115–130. https://doi.org/10.1016/j.jer.2022.01.005
【Webページ・オンライン記事】
World Health Organization. (2023, March 15). Guidelines on digital health interventions. https://www.who.int/publications/i/item/9789240003194
- Vancouverスタイル(バンクーバー方式)
医学・理学・自然科学分野などで広く使われる「番号順(出現順)」形式です。本文中に登場した順に数字([1], [2])を割り当てて並べます。
[1] Smith JA. Quantitative and qualitative research methods: A comprehensive guide. New York: Academic Press; 2020.
[2] Tanaka T, Miller P. Evaluating survey data in qualitative analysis. J Educ Res. 2022;45(2):115–130.
[3] World Health Organization. Guidelines on digital health interventions [Internet]. Geneva: World Health Organization; 2023 [cited 2026 Sep 4]. Available from: https://www.who.int/publications/i/item/9789240003194
- 日本語の学術スタイル(人文・社会科学系標準例)
日本語論文で一般的に用いられるフォーマットです。五十音順に並べます。
【単行本】
山田太郎(2021)『社会調査法入門:定量的研究と定性的研究の統合』学術出版.
【論文(学会誌・紀要)】
佐藤花子・鈴木一郎(2023)「インタビュー調査におけるテーマ分析の妥当性」『社会科学研究』第30巻第1号,45-60頁.
【翻訳書】
スミス,J. A.(2022)『質的研究の理論と実践』(田中次郎訳)岩波書店(原著2020年刊行).
【Webサイト】
文部科学省(2024)「学術研究における生成AIの利用に関するガイドライン」(2026年9月4日取得,https://www.mext.go.jp/sample_path).
な事柄の学習や研究を大幅に効率アップするのに役立ちますが、特に有効だと感じるのは、語学学習への適用です。単語帳の作成、翻訳、例文の作成、活用表の作成などにおいて、生成AIは膨大な知識量を活かして、どんな要望にも即座に答えてくれます。
第19章:生成AIを活用した英語学習法 Ver.2.0
1. 単語帳の作成
単語帳の作成は、生成AIの最も得意とするところです。例えば、英語の文章を示して、その中から特性をもった単語だけを抜き出して、日本語訳をつけて表形式で出力してもらうといったこともできます。これができれば、英語学習は大いに捗ることでしょう。
例として、英語の長文から、TOEIC800点以上のレベルの単語を抜き出して、表にまとめるというプロンプトを実行してみましょう。(サンプルの文章は、アルベール・カミュ「異邦人」の冒頭部分をDeepLで英語に翻訳したものです)
プロンプト:
以下の英語の文章から、TOEIC800点以上のレベルの単語を抜き出して、日本語訳をつけた表を日本語で出力してください。それぞれの単語には、簡単な例文(日本語訳付き)をつけてください。
Maman died today. Maybe yesterday, I don’t know. I got a telegram from the endowment. I don’t know anything about it. Perhaps it was yesterday. The home for the aged was in Marango, 80 kilometers from Algiers. If I took the 2:00 p.m. bus, I would arrive there in the afternoon. Then we could have a wake and come back the next evening. I asked my husband for two days’ leave. I could not refuse him the leave under the circumstances, but he seemed dissatisfied. I told him that it was not my fault, but he did not respond. I knew I shouldn’t have said anything like that. Anyway, I didn’t have to make any excuses. He should have been the one to express his condolences to me. But of course, he would actually express his condolences the day after tomorrow, when he met me in mourning. For the time being, it seems that Maman is not dead. After the burial, on the contrary, this will be a matter that has been dealt with, and everything will take a more public form.
ご提示いただいた文章から、TOEIC 800点以上のレベルに相当する語彙・表現を抽出し、例文と日本語訳を添えた表を作成しました。
| 単語・表現 | 意味 | 簡単な例文 | 例文の日本語訳 |
| endowment | 寄付金、基金、(施設などの)財団 | The university received a generous endowment. | その大学は手厚い寄付金を受け取った。 |
| aged | 高齢の、年老いた | The facility offers healthcare services for the aged. | その施設は高齢者向けの医療サービスを提供している。 |
| wake | 通夜 | Family members gathered for the wake. | 遺族たちが通夜のために集まった。 |
| circumstance | 状況、事情 | Under the present circumstances, we must delay the project. | 現在の状況下では、プロジェクトを延期せざるを得ない。 |
| dissatisfied | 不満な、満足していない | Customers were dissatisfied with the slow response. | 顧客は対応の遅さに不満を抱いていた。 |
| condolence | お悔やみ、哀悼(※通常複数形) | Please accept my sincere condolences. | 心よりお悔やみ申し上げます。 |
| in mourning | 喪に服して、喪服を着て | The whole nation was in mourning after the president passed away. | 大統領の逝去後、国全体が喪に服していた。 |
| for the time being | 当面の間、差し当たり | We will use this temporary password for the time being. | 当面の間は、この仮パスワードを使用します。 |
| burial | 埋葬、告別式 | The burial ceremony will take place tomorrow morning. | 埋葬の儀式は明日の朝行われる。 |
| on the contrary | それどころか、正反対で | It wasn’t a failure; on the contrary, it was a great success. | それは失敗ではなく、それどころか大成功だった。 |
🗒️ 生成AIの回答をPCのドキュメントとして保存する方法
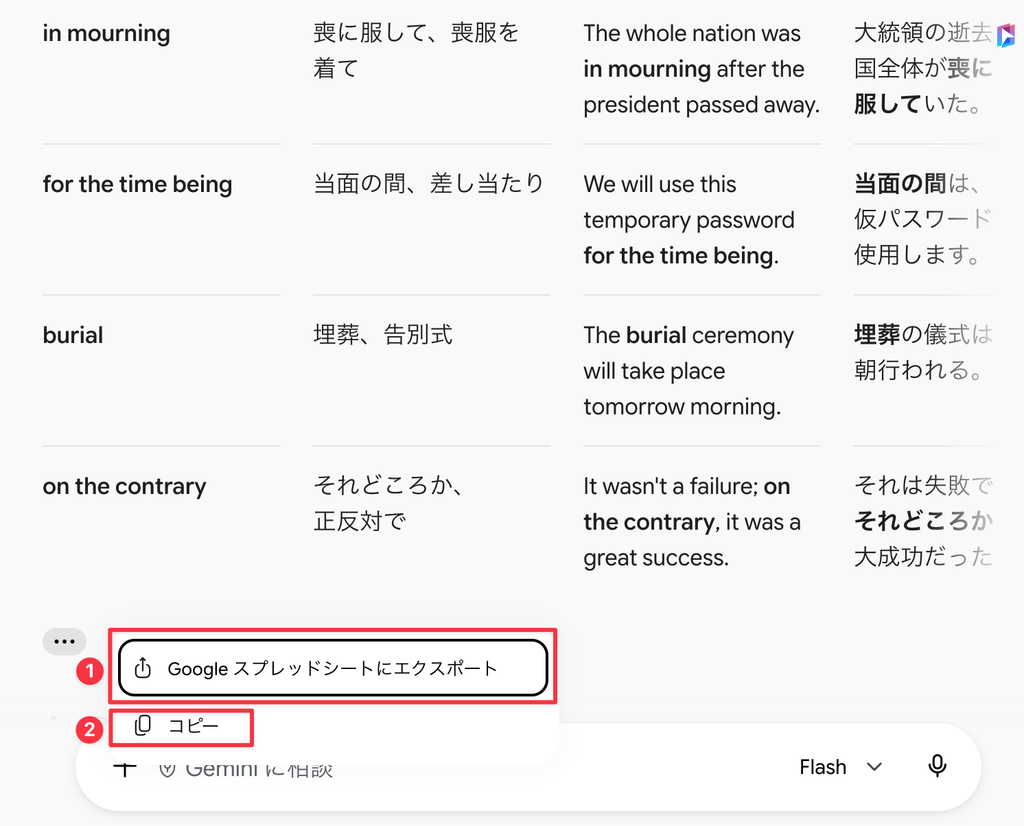
Geminiで出力した英単語表を、自分のPCに保存するには、Geminiの回答結果ページの左下の3点マークをクリックし、❶「Googleスプレッドシートにエクスポート」をクリックすれば、表形式のファイルをPC内の好きな場所に保存できます。また、単に表をPCに一時的にコピーしたい場合には ❷「コピー」をクリックすれば、PC上のGoogleドキュメントやWordなどにペーストすることができます。
2. 例文の作成 (Examples)
例文集の作成は、生成AIが最も得意とするタスクの一つです。というのは、生成AIは、ウェブ上とはいえ、英語の例文に関する膨大なデータベースにアクセスすることができ、また普段から膨大な学習をしているからです。その量は、おそらくどんな語学の専門家もはるかに凌ぐ規模のものだと推測されます。ただし、生成AIが収集する例文は、すべてが正確なものとは限りませんので、ハルシネーションが含まれていないかどうかのチェックを怠ることはできません。
英語学習者が、生成AIを通じて英語の例文を入手することのメリットは、極めて大きなものがあります。まずは、知らない単語を覚える時に、例文があれば、単語の理解力、記憶力は格段に向上することでしょう。また、単語の意味を多様な文脈で理解することができるようになります。また、例文を少しでも多く覚えておけば、英作文や英会話の力も確実に向上するでしょう。
そこで、生成AIに英語の例文をいくつか作ってもらうことにします。
プロンプト:
次の英単語の例文をそれぞれ3つ作成し、単語とともに表にまとめてください。それぞれの単語と例文には、日本語訳もつけてください。
resume
sober
pact
ご提示いただいた3つの英単語について、それぞれ3つずつ例文を作成し、単語の意味と日本語訳を添えて表にまとめました。
| 単語(意味) | 例文 | 日本語訳 |
| resume (再開する / 履歴書) | The committee decided to resume the meeting after lunch. | 委員会は昼食後に会議を再開することに決定した。 |
| She hopes to resume her studies once her child starts school. | 彼女は子供が学校に通い始めたら学業を再開したいと考えている。 | |
| You should highlight your key achievements on your resume. | 履歴書には主要な実績を強調して書くべきだ。 | |
| sober (シラフの / 真剣な、落ち着いた) | He remained completely sober throughout the evening. | 彼は晩の間ずっと完全に**シラフの(酒を飲んでいない)**状態だった。 |
| The report presents a sober assessment of the company’s financial situation. | その報告書は会社の財務状況について**真剣で現実的な(客観的な)**評価を示している。 | |
| She made a sober decision after carefully considering all options. | 彼女はすべての選択肢を慎重に検討した上で、冷静な決定を下した。 | |
| pact (協定、条約、取り決め) | The two countries signed a historic peace pact. | その2か国は歴史的な平和協定に調印した。 |
| The companies entered into a formal pact to share technology. | それらの企業は技術を共有するための正式な協定を結んだ。 | |
| They made a private pact to keep the news a secret until Friday. | 彼らは金曜日までそのニュースを秘密にするという個人的な約束を交わした。 |
3. 英文読解 (Reading)
3-1 : 要約の作成
外国語を学習する場合、長い原文を一気に最後まで読み通すのは、しばしば苦痛です。そんなとき、とりあえず要約を原語と日本語で作成してもらうのは、学習者にとって大きな恩恵だと言えるでしょう。生成AIなら、そのようなことも簡単にやってくれます。長文の場合には、500語程度に要約して守るのが読みやすくていいでしょう。
プロンプト
Shorten the following English sentences in both English and Japanese within 500 words.
To Sherlock Holmes she is always the woman. I have seldom heard him mention her under any other name. In his eyes she eclipses and predominates the whole of her sex. It was not that he felt any emotion akin to love for Irene Adler. All emotions, and that one particularly, were abhorrent to his cold, precise but admirably balanced mind. He was, I take it, the most perfect reasoning and observing machine that the world has seen, but as a lover he would have placed himself in a false position. He never spoke of the softer passions, save with a gibe and a sneer. They were admirable things for the observer—excellent for drawing the veil from men’s motives and actions. But for the trained reasoner to admit such intrusions into his own delicate and finely adjusted temperament was to introduce a distracting factor which might throw a doubt upon all his mental results. Grit in a sensitive instrument, or a crack in one of his own high-power lenses, would not be more disturbing than a strong emotion in a nature such as his. And yet there was but one woman to him, and that woman was the late Irene Adler, of dubious and questionable memory.
I had seen little of Holmes lately. My marriage had drifted us away from each other. My own complete happiness, and the home-centred interests which rise up around the man who first finds himself master of his own establishment, were sufficient to absorb all my attention, while Holmes, who loathed every form of society with his whole Bohemian soul, remained in our lodgings in Baker Street, buried among his old books, and alternating from week to week between cocaine and ambition, the drowsiness of the drug, and the fierce energy of his own keen nature. He was still, as ever, deeply attracted by the study of crime, and occupied his immense faculties and extraordinary powers of observation in following out those clues, and clearing up those mysteries which had been abandoned as hopeless by the official police. From time to time I heard some vague account of his doings: of his summons to Odessa in the case of the Trepoff murder, of his clearing up of the singular tragedy of the Atkinson brothers at Trincomalee, and finally of the mission which he had accomplished so delicately and successfully for the reigning family of Holland. Beyond these signs of his activity, however, which I merely shared with all the readers of the daily press, I knew little of my former friend and companion.
One night—it was on the twentieth of March, 1888—I was returning from a journey to a patient (for I had now returned to civil practice), when my way led me through Baker Street. As I passed the well-remembered door, which must always be associated in my mind with my wooing, and with the dark incidents of the Study in Scarlet, I was seized with a keen desire to see Holmes again, and to know how he was employing his extraordinary powers. His rooms were brilliantly lit, and, even as I looked up, I saw his tall, spare figure pass twice in a dark silhouette against the blind. He was pacing the room swiftly, eagerly, with his head sunk upon his chest and his hands clasped behind him. To me, who knew his every mood and habit, his attitude and manner told their own story. He was at work again. He had risen out of his drug-created dreams and was hot upon the scent of some new problem. I rang the bell and was shown up to the chamber which had formerly been in part my own.
His manner was not effusive. It seldom was; but he was glad, I think, to see me. With hardly a word spoken, but with a kindly eye, he waved me to an armchair, threw across his case of cigars, and indicated a spirit case and a gasogene in the corner. Then he stood before the fire and looked me over in his singular introspective fashion.
English Condensed Text
To Sherlock Holmes, Irene Adler was always the woman. It was not love, for emotions were abhorrent to his cold, precise, and purely logical mind. To a perfect reasoning machine like Holmes, strong passion was merely a distracting flaw that could impair his analytical faculties. Yet, the late Irene Adler remained the sole woman who ever held a paramount place in his memory.
After my marriage, Holmes and I had drifted apart. While I was absorbed in domestic happiness and my medical practice, Holmes remained at Baker Street, alternating between drug-induced lethargy and intense mental activity. He continued to dedicate his extraordinary faculties to solving complex crimes abandoned by the police, taking on cases across Europe.
On March 20, 1888, while returning from a patient, I passed Baker Street. Seeing Holmes’s tall silhouette pacing eagerly behind the lit window, I knew he was hot on the trail of a new mystery. Impelled by a strong desire to see him again, I rang the bell. He welcomed me with a quiet, kindly look, offered cigars and drinks, and observed me in his characteristically introspective way.
日本語短縮文
シャーロック・ホームズにとって、アイリーン・アドラーは常に「あの女性」であった。冷徹で精密な論理思考を持つ彼にとって感情は知性を狂わせる障害でしかなく、彼女への感情も決して愛ではない。しかし、彼女だけは彼の記憶の中で特別な存在であり続けた。
私の結婚を機に二人の距離は開いていた。私が家庭生活と医師の仕事に身を引く一方、ホームズはベイカー街に留まり、薬物による怠惰と事件解明への情熱を交互に繰り返しながら、警察もお手上げの難事件を解決していた。
1888年3月20日の夜、往診の帰りにベイカー街を通った私は、窓に映るホームズの影から彼が新たな事件に没頭していることを察した。再会を望んで部屋を訪ねると、彼は言葉少なげながらも温かく私を迎え入れ、葉巻と酒を勧めて静かに私を観察した。
3-2 : 英語の長文の生成
英語読解を勉強するとき、従来なら、英米の文学作品やニュースサイトに掲載される長文をテキストとして、学習するのが定番でした。しかし、GeminiやChatGPTなどの生成AIを使えば、自分の興味にあったテーマや主題の英語長文を生成してもらうことができます。しかも、英検はTOEICの単語レベルを指定して、それに合った単語を含む長文を生成してもらうといったことも可能です。生成される文字数の指定もできるので、リーディング試験対策もバッチリです。
(1) 特定のテーマを指定して長文を生成してもらう
ここでは、生成AIが引き起こすリスクというテーマで、英語の長文を生成させてみました。用いたプロンプトは次のとおりです。
生成AIが引き起こすリスクをテーマとする300語程度の英文を作ってください。日本語訳をつけてください。
GeminiとChatGPTによる回答は以下のとおりです。
Here is a paragraph addressing the risks of Generative AI, accompanied by its Japanese translation.
The rapid rise of generative AI has transformed various industries, but it also introduces significant societal, ethical, and security risks. One of the most immediate concerns is the spread of misinformation and deepfakes. Because generative AI can effortlessly synthesize realistic images, audio, and news articles, malicious actors can exploit it to manipulate public opinion, execute sophisticated scams, or undermine democratic processes.
Another major risk involves copyright infringement and intellectual property rights. AI models are trained on vast datasets scraped from the internet, often without the consent or compensation of the original creators. This practice has triggered complex legal disputes over ownership and the fair use of artistic works.
Furthermore, data privacy and cybersecurity vulnerabilities pose ongoing challenges. Users frequently input sensitive personal or proprietary corporate information into AI tools, risking accidental data leaks. Concurrently, cybercriminals leverage generative AI to write convincing phishing emails and construct malware at unprecedented speeds.
Lastly, the economic impact on the job market remains a crucial concern. As AI automates complex tasks in fields like copywriting, graphic design, and software development, workforce displacement seems inevitable. Addressing these multi-faceted risks requires robust regulatory frameworks, rigorous ethical guidelines, and continuous technological safeguards to ensure that generative AI serves humanity safely and equitably.
日本語訳
生成AIの急速な台頭は様々な産業に変革をもたらしましたが、同時に深刻な社会的、倫理的、そして安全保障上のリスクを引き起こしています。最も直近の懸念の一つは、誤情報やディープフェイクの拡散です。生成AIはリアルな画像、音声、ニュース記事を容易に生成できるため、悪意のある者が世論を誘導したり、精巧な詐欺を実行したり、民主的なプロセスを揺るがしたりするために悪用する恐れがあります。
もう一つの重大なリスクは、著作権侵害と知的財産権に関する問題です。AIモデルはインターネットから収集された膨大なデータセットで学習されていますが、それらは元の制作者の同意や補償なしに行われることが少なくありません。この手法は、作品の所有権や公正利用をめぐる複雑な法的紛争を引き起こしています。
さらに、データプライバシーやサイバーセキュリティ上の脆弱性も継続的な課題です。ユーザーが個人情報や企業の機密情報をAIツールに入力することで、誤ってデータが漏洩するリスクが生じます。同時に、サイバー犯罪者は生成AIを利用して説得力のあるフィッシングメールを作成したり、これまでにないスピードで悪意のあるソフトウェア(マルウェア)を構築したりしています。
最後に、労働市場への経済的影響も重要な懸念事項です。コピーライティング、グラフィックデザイン、ソフトウェア開発などの分野でAIが複雑なタスクを自動化するにつれ、雇用の代替(失業)は避けられないように思われます。これらの多角的なリスクに対処するには、生成AIが安全かつ公平に人類に貢献できるよう、堅牢な規制枠組み、厳格な倫理指針、そして継続的な技術的セーフガードが必要です。
(2) 英語検定試験のレベルを指定して長文を生成してもらう
英語力を測定するための評価基準はいろいろありますが、その中の代表的なものとして、CEFR、TOEIC L&R、英検の4つをレベルごとに比較対照的したものが次の表です。
| CEFR | レベルの概要 | TOEIC L&R(990点満点) | 英検 |
| C2 | 母語話者と同等の高度な運用力 | — | 1級(上位合格) |
| C1 | 広範囲で複雑な長文を理解し、自由自在に運用できる | 945–990 | 1級 |
| B2 | 専門的な話題の複雑な原文を理解し、ビジネス等で自立して対応できる | 785–940 | 準1級 |
| B1 | 身近な話題や仕事に関する標準的な英語を理解・表現できる | 550–780 | 2級 |
| A2 | 日常生活に必要な身近で簡単な単語・短文を理解できる | 225–545 | 準2級 |
| A1 | 初歩的な単語やごく簡単なフレーズを理解できる | 120–220 | 3級 |
注:
- CEFR(Common European Framework of Reference for Languages): 外国語のコミュニケーション能力を測る世界共通のガイドライン(A1〜C2の6段階)。
- TOEIC L&R: リスニング(495点)とリーディング(495点)の合計スコアです。C2レベルについては、話す・書く力を測る「TOEIC S&W」や他の試験を併せて総合判定されることが多く、L&R単独では測定範囲外とされるのが一般的です。
- 英検: 各級の合否だけでなく、受検結果に表示される「英検CSEスコア」によって正確なCEFRレベルが確認できます。
プロンプトにおいて、表中のレベルを指定することによって、望み通りの難易度の英文を生成してもらうことができます。
ここでは、「市街地でのクマの出没」をテーマとする250字程度の英文を、5つレベルに分けて生成してもらいます。プロンプトは、次にあげるようなものを共通で用います。生成AIはGeminiを使っています。
最近、日本各地でクマが市街地に出没していることについて、CEFR A1レベルの英文を250語程度で作成してください。英文の後に、日本語訳をつけ、CEFR A1レベルの英単語、品詞、意味、例文を表にまとめてください。
Bears are living in many places in Japan, like big mountains and forests. They usually look for food in the trees and bushes. However, things are changing now. Bears are coming into towns and cities where people live. This happens in many parts of Japan.
Why do bears come to towns? In autumn, bears need to eat a lot of food before winter. They like to eat nuts, like acorns. Sometimes, there are not enough nuts in the mountains. Bears become hungry. They walk down from the mountains to find something to eat. In towns, they can find fallen fruits, trash, and food in gardens.
When bears come to cities, it is dangerous. Bears are big and very strong. People get scared because bears can walk near houses, schools, and train stations. Children and older people must be very careful when they walk outside. Local governments tell people to be quiet and stay inside if they see a bear. People also use bells when they walk near trees. The noise helps to scare the bears away.
Bears and people need to live safely. People are trying to keep towns clean so bears do not smell food. It is important to learn how to stay safe.
日本語訳
クマは日本の大きな山や森など、たくさんの場所に住んでいます。彼らはふだん、木や藪の中で食べ物を探します。しかし、今では状況が変わってきています。クマが、人々が住む街や市街地に入ってくるようになっています。これは日本の多くの地域で起こっています。
なぜクマは街にやってくるのでしょうか?秋になると、クマは冬の前に食べ物をたくさん食べる必要があります。彼らはどんぐりのような木の実を食べるのが好きです。ときどき、山の中に木の実が十分にないことがあります。クマはお腹がすきます。彼らは食べるものを探すために山から歩いて下りてきます。街の中では、落ちた果物やゴミ、庭の食べ物を見つけることができます。
クマが市街地に来ると危険です。クマは大きくてとても強いです。クマが家や学校、駅の近くを歩くことがあるため、人々は恐怖を感じています。子どもやお年寄りは、外を歩くとき特に気をつけなければなりません。地方自治体は、クマを見かけたら静かにして建物の中に留まるよう人々に伝えています。人々はまた、木々の近くを歩くときに鈴を使います。その音がクマを追い払うのに役立ちます。
クマと人間は安全に暮らす必要があります。人々はクマが食べ物の匂いを嗅ぎつけないよう、街をきれいに保とうとしています。安全に過ごす方法を学ぶことが大切です。
CEFR A1レベルの英単語一覧
| 単語 | 品詞 | 意味 | 例文 |
| bear | 名詞 | クマ | I saw a bear in the zoo.(動物園でクマを見ました。) |
| forest | 名詞 | 森、森林 | Green trees grow in the forest.(森には緑の木々が生えています。) |
| food | 名詞 | 食べ物 | Apples are my favorite food.(リンゴは私の大好きな食べ物です。) |
| town | 名詞 | 街、町 | I live in a small town.(私は小さな街に住んでいます。) |
| autumn | 名詞 | 秋 | Leaves turn red in autumn.(秋には葉が赤くなります。) |
| winter | 名詞 | 冬 | It is very cold in winter.(冬はとても寒いです。) |
| hungry | 形容詞 | お腹がすいた | I am hungry, so I want to eat lunch.(お腹がすいたので昼食を食べたいです。) |
| dangerous | 形容詞 | 危険な | Swimming in this river is dangerous.(この川で泳ぐのは危険です。) |
| scared | 形容詞 | 怖がって、恐れて | The child was scared of the dark.(その子どもは暗闇を怖がっていました。) |
| clean | 形容詞 | きれいな、清潔な | Please keep your room clean.(部屋をきれいにしておいてください。) |
3-3 : 難解な英文をわかりやすい英文に直してもらう
英語で書かれた古今東西の古典的作品には、原書で読みたくても難解だったり、古い英語で書かれているために読みにくいものが少なくありません。生成AIの助けを借りれば、そうした難解な英語の文章を、意味は変えずにわかりやすい現代風の英語に直してもらうことができます。以下では、英語で書かれた古典的な文学作品を例に取って、GeminiとChatGPTを使ってわかりやすい現代英語に直してもらうことにしましょう。原典は、いずれもネット上に公開されているGutenberg Project収録作品です。
(1) シェイクスピア『ロミオとジュリエット』
プロンプト
次の文章を、意味はもとのままで、わかりやすく自然な現代英語に直してください。その後に、日本語訳をつけてください。また、現代風に直した箇所について、簡単な解説をつけてください。
JULIET.
O Romeo, Romeo, wherefore art thou Romeo?
Deny thy father and refuse thy name.
Or if thou wilt not, be but sworn my love,
And I’ll no longer be a Capulet.
ROMEO.
[Aside.] Shall I hear more, or shall I speak at this?
JULIET.
’Tis but thy name that is my enemy;
Thou art thyself, though not a Montague.
What’s Montague? It is nor hand nor foot,
Nor arm, nor face, nor any other part
Belonging to a man. O be some other name.
What’s in a name? That which we call a rose
By any other name would smell as sweet;
So Romeo would, were he not Romeo call’d,
Retain that dear perfection which he owes
Without that title. Romeo, doff thy name,
And for thy name, which is no part of thee,
Take all myself.
ROMEO.
I take thee at thy word.
Call me but love, and I’ll be new baptis’d;
Henceforth I never will be Romeo.
シェイクスピアの『ロミオとジュリエット』(第2幕第2場)の有名なバルコニーの場面です。古風な二人称代名詞や文脈固有の古語を、意味を保ったまま現代の英語表現に置き換えました。
現代英語への書き換え
JULIET.
Oh, Romeo, Romeo, why must you be Romeo?
Disown your father and refuse your name.
Or, if you won’t, just swear that you love me,
And I’ll no longer be a Capulet.
ROMEO.
[Aside.] Should I listen more, or speak up now?
JULIET.
It’s only your name that is my enemy;
You are yourself, even if you weren’t a Montague.
What is a Montague? It isn’t a hand, a foot,
An arm, a face, or any other part
Of a man. Oh, be some other name!
What’s in a name? The flower we call a rose
Would smell just as sweet by any other name.
So Romeo, even if he weren’t called Romeo,
Would keep that perfection he has
Without that title. Romeo, drop your name,
And in exchange for your name, which isn’t part of you,
Take all of me.
ROMEO.
I hold you to your word.
Just call me your love, and I’ll be baptized anew;
From now on, I will never be Romeo again.
日本語訳
ジュリエット:
ああ、ロミオ、ロミオ、なぜあなたはロミオ(モンタギュー家の人)なのですか?
お父様と縁を切り、その家名を捨ててください。
もしそれができないなら、私を愛すると誓って。
そうすれば、私はもうカピュレット家の人間ではなくなります。
ロミオ:
[傍白] もっと聞くべきか、それとも今話しかけるべきか?
ジュリエット:
私の敵なのは、あなたの名前だけ。
あなたがモンタギュー家でなくても、あなたはあなた自身です。
モンタギューとは何? 手でも足でも、
腕でも顔でも、人間の体のどの部分でもないわ。
ああ、どうか別の名前になって。
名前になにがあるというの? 私たちがバラと呼ぶ花は、
どんな別の名前で呼ばれても変わらず甘く香るわ。
同じようにロミオも、たとえロミオと呼ばれなくても、
その名前がなくても、あなたが持っている素晴らしい完璧さをそのまま保つはず。
ロミオ、あなたの名前を捨てて。
そしてあなたの一部ですらないその名前の代わりに、
私のすべてを受け取って。
ロミオ:
その言葉通りに受け取ろう。
僕を「愛する人」とだけ呼んでくれ、そうすれば僕は新しく生まれ変わる(洗礼を受ける)。
これからは二度とロミオにはならない。
現代風に直した箇所の解説
- wherefore art thou → why must you be
- wherefore は「どこ」ではなく「なぜ(why)」を意味する古語です。art thou(you are)と合わせて「なぜあなたは〜なのか」という疑問文に直しました。
- thou / thy / thee → you / your / you
- 早期近代英語で使われていた二人称親称の代名詞(主格 thou、所有格 thy、目的格 thee)を、すべて現代の you / your に統一しました。
- Deny thy father → Disown your father
- ここでの deny は「否定する」ではなく、「(親子関係や家柄を)拒否する・勘当する」という意味で使われているため、現代語の disown(縁を切る)に言い換えました。
- wilt / ’Tis / ’ll → will / It is / will
- wilt(will の古い2人称単数形)や、古風な短縮形である ’Tis(It is)を一般的な表記に直しました。
- nor … nor … → isn’t a … a … or …
- nor A nor B(AでもBでもない)という文語的な否定表現を、直感的にわかりやすい現代の否定文構造に組み替えました。
- owes → has / possesses
- シェイクスピアの時代における owe は「借りがある」ではなく「(美徳や所有物を)持っている(own)」という意味で使われていたため、現代の所有を表す動詞に書き換えました。
- doff →drop
- 「脱ぐ、脱ぎ捨てる」を意味する古語 doff を、現代で使いやすい drop(放棄する、捨てる)に変更しました。
- Henceforth → From now on
- 「これ以降は」を意味するやや硬い古語 henceforth を、会話で自然な from now on に修正しました。
(2) ジェームズ・ジョイス『ユリシーズ』(Ulysses)
次に取り上げるのは、英文学の中でもとりわけ難解であることで有名な、ジェームズ・ジョイスの代表作『ユリシーズ』です。その冒頭の場面を現代風のわかりやすい英語に直してもらいました。
プロンプト
次の文章を、意味は元のままで、わかりやすく自然な現代英語に直してください。その後に、日本語訳をつけてください。また、現代風に直した箇所について、簡単な解説をつけてください。
Stately, plump Buck Mulligan came from the stairhead, bearing a bowl of lather on which a mirror and a razor lay crossed. A yellow dressinggown, ungirdled, was sustained gently behind him on the mild morning air. He held the bowl aloft and intoned:
—Introibo ad altare Dei.
Halted, he peered down the dark winding stairs and called out coarsely:
—Come up, Kinch! Come up, you fearful jesuit!
Solemnly he came forward and mounted the round gunrest. He faced about and blessed gravely thrice the tower, the surrounding land and the awaking mountains. Then, catching sight of Stephen Dedalus, he bent towards him and made rapid crosses in the air, gurgling in his throat and shaking his head. Stephen Dedalus, displeased and sleepy, leaned his arms on the top of the staircase and looked coldly at the shaking gurgling face that blessed him, equine in its length, and at the light untonsured hair, grained and hued like pale oak.
ジェイムズ・ジョイスの『ユリシーズ』冒頭(第1章)を、元の情景や語句のニュアンスを保ちつつ、現代の読み手に伝わりやすい自然な英語へ書き換えた文章です。
現代英語への書き換え
An imposing, plump Buck Mulligan came out from the top of the stairs, carrying a bowl of lather with a mirror and a razor crossed on top of it. He wore an unbelted yellow dressing gown, which floated gently behind him in the mild morning air. Holding the bowl high in the air, he chanted:
—Introibo ad altare Dei.
Stopping, he peered down into the dark, winding staircase and shouted roughly:
—Come up, Kinch! Come up, you paranoid Jesuit!
Solemnly, he walked forward and stepped up onto the round gun platform. Turning around, he gravely blessed the tower, the surrounding land, and the awakening mountains three times. Then, catching sight of Stephen Dedalus, he leaned toward him, quickly made the sign of the cross in the air, and gurgled in his throat while shaking his head. Stephen Dedalus, annoyed and sleepy, rested his arms on the top of the railing and looked coldly at the shaking, gurgling face that was blessing him—a face long like a horse’s—and at his light, untrimmed hair, which had the color and texture of pale oak.
日本語訳
堂々とした体つきの太ったバック・マリガンが階段の最上部から現れた。手には鏡とカミソリが交差して置かれた泡立て鉢を持っていた。帯を締めていない黄色のガウンの裾が、穏やかな朝の空気の中に彼の後ろでふわりとなびいていた。彼は鉢を高く掲げ、朗々と唱えた。
——神の祭壇に近づかん。(カトリックのラテン語の聖歌の一節)
彼は立ち止まり、暗く旋回する階段の下を覗き込むと、乱暴な声で叫んだ。
——上がってこい、キンチ! 上がってこい、この臆病(または被害妄想気味)なイエズス会士め!
彼は粛々と前へ進み、円形の砲台へと上った。振り返ると、塔と周囲の土地、そして目覚めゆく山々に向けて厳かに3度祝福を与えた。やがてスティーヴン・ディーダラスの姿が目に入ると、彼はスティーヴンの方へ身を乗り出し、喉をゴロゴロと鳴らし頭を振りながら、空中に素早く十字を切った。不機嫌で眠そうなスティーヴン・ディーダラスは、手すりの最上部に腕を預け、自分を祝福してくる、馬のように顔の長い、ゴロゴロと音を立てて揺れる顔と、薄いオーク材のような色と肌触りをした、切りそろえられていない明るい髪を冷ややかに見つめた。
現代風に直した箇所の解説
- Stately $\rightarrow$ An imposing
- 「風格のある、堂々とした」を意味するやや詩的な形容詞 stately を、現代的に情景が浮かびやすい imposing(存在感のある、威厳のある)に変更しました。
- stairhead $\rightarrow$ top of the stairs
- 古風な名詞 stairhead(階段の頂部)を、現代英語で一般的な top of the stairs に改めました。
- was sustained gently behind him $\rightarrow$ floated gently behind him
- 「風によって浮き上がって支えられている(was sustained)」という硬い受動態表現を、衣服がふわりとなびく自然な能動態の floated(漂う、浮かぶ)に書き換えました。
- fearful $\rightarrow$ paranoid
- 執拗に宗教的な罪悪感を抱えるスティーヴンを揶揄する文脈での fearful は、単に「恐れている」だけでなく「(過剰に)ビクビクしている、被害妄想的な」ニュアンスを含むため、現代語の paranoid で意味を明確にしました。
- gunrest $\rightarrow$ gun platform
- マルテロ塔(作品の舞台となる要塞)の砲座を指す gunrest を、現在より一般的に使われる gun platform に変更しました。
- awaking $\rightarrow$ awakening
- awaking を現代英語で形容詞的に使われる分詞表現 awakening(目覚めつつある)に修正しました。
- untonsured $\rightarrow$ untrimmed
- untonsured は「トンスラ(カトリック聖職者の頭頂部の剃髪)をしていない」という特定の宗教語彙ですが、文脈上「切りそろえられていない・無造作な」髪を指しているため、現代的でわかりやすい untrimmed(手入れされていない、ハサミが入っていない)に言い換えました。
4. 英文法 (Grammer)
生成AIは、複雑で難解な英文に出会ったときでも、プロンプトで「この英文の文法を解説してください」と尋ねるだけで、詳しい解説を返してくれます。例として、次のようなテキストについて、GeminiとChatGPTに文法的解説をお願いしてみましょう。
プロンプト
次の英文テキストの文法を解説してください。
It is a truth universally acknowledged, that a single man in possession of a good fortune must be in want of a wife. However little known the feelings or views of such a man may be on his first entering a neighbourhood, this truth is so well fixed in the minds of the surrounding families, that he is considered as the rightful property of some one or other of their daughters.
ジェイン・オースティンの小説『高慢と偏見』の有名な冒頭部分ですね。文法構造を1文ずつ詳しく解説します。
第1文
It is a truth universally acknowledged, that a single man in possession of a good fortune must be in want of a wife.
【全体構造:形式主語構文】
- It:形式主語(仮主語)
- is:動詞(V)
- a truth (universally acknowledged):補語(C)
- that … (文末まで):真主語となる名詞節
「〜ということは、あまねく認められた真理である」という大きな骨組みになっています。
【各要素の文法ポイント】
- universally acknowledged
- 過去分詞修飾:前述の
truthを後ろから修飾しています(a truth [which is] universally acknowledgedの関係代名詞+be動詞が省略された形)。 universally(副詞:普遍的に・世一般に)が過去分詞acknowledged(認められた)を修飾しています。
- 過去分詞修飾:前述の
- that 節内部の構造
- 主語 (S):
a single man in possession of a good fortunesingle:独身のin possession of ~:前置詞句でa single manを修飾。「財産を所有している(独身男性)」
- 助動詞 + 動詞句 (V):
must be in want ofmust:「〜に違いない」(強い確信・推測)be in want of ~:熟語で「〜を必要としている」「〜を欲している」(= want / need)
- 目的語的要素:
a wife(妻)
- 主語 (S):
第2文
However little known the feelings or views of such a man may be on his first entering a neighbourhood, this truth is so well fixed in the minds of the surrounding families, that he is considered as the rightful property of some one or other of their daughters.
【全体構造:複合文】
譲歩の副詞節(However ~ neighbourhood)+ 主節(this truth ~ daughters)の2つの大きな部分から構成されています。
【1. 譲歩の副詞節(前半)】
However little known the feelings or views of such a man may be on his first entering a neighbourhood
- However + 形容詞/副詞 + S + V …:「どんなに〜であっても」(複合関係副詞の譲歩構文)
little known(ほとんど知られていない)がHoweverに引き寄せられて文頭に出てきています。- 主語 (S):
the feelings or views of such a man(そのような男性の感情や考え) - 動詞 (V):
may be(〜かもしれない) - 元の語順に直すと:the feelings or views of such a man may be little known … となります。
- on his first entering a neighbourhood
on + 動名詞:「〜するとすぐに、〜する際に」his:動名詞enteringの意味上の主語(彼が〜に入っていくとき)first:副詞的に動名詞を修飾(「初めて〜するとき」)
【2. 主節(後半:so … that … 構文)】
this truth is so well fixed in the minds of the surrounding families, that he is considered as the rightful property of some one or other of their daughters.
- so … that 構文:「非常に…なので〜だ」(結果を表す)
- 主語 (S):
this truth(この真理は) - 動詞 + 補語 (V+C):
is so well fixed(非常にしっかり定着している) - 修飾語:
in the minds of the surrounding families(近隣の家族たちの心の中に)
- 主語 (S):
- that 節の内容
- 主語 (S):
he(その男性) - 動詞 (V):
is considered(見なされる / 受動態) - 補語的要素:
as the rightful property ...consider A as B(AをBとみなす)の受動態(A is considered as B)。the rightful property:正当な所有物(資産)of some one or other of their daughters:「娘たちのうちの誰か一人の」some one or other:誰かしら、誰か一人
- 主語 (S):
全訳の例
「財産のある独身男性は妻を必要としているに違いないということは、あまねく認められた真理である。そのような男性が初めて近隣に引っ越してきた際、本人の心情や考えがどれほど知られていなかろうとも、この真理は近隣の家族たちの心にしっかりと定着しているため、彼は娘たちの誰かしらの正当な所有物とみなされるのである。」
5. 英作文(Writing)
生成AIは、ライティングの力をつける上で、重要な役割を果たすことができます。一つは、TOEICのWriting testや英検の作文の問題を作成してもらい、それを解くことによって、英文ライティングの力をつけることができます。もう一つは、実際に自分で作成した英文テキストを添削してもらい、解説を加えてもらうことによって、英作文の力を向上させることができます。
5-1 : 英語ライティング試験対策
ライティング(Writing)は、英語4技能の一つで、英語力において重要な構成要素です。一般に日本人はライティングに弱いと言われていますので、生成AIの助けを借りて、ライティング能力を高めることは、英語力を飛躍的に高める近道と言えるでしょう。ここではまず、TOEICや英検などの検定試験でよく出てくるライティング問題を想定したいくつかの練習問題を生成AIに作成してもらい、それを解くという方法でライティング能力を磨くことにしたいと思います。
(1) TOEICライティング模擬試験問題
TOEICライティングテストは、英語で実務的な文章を書く運用能力を測定するPC受験型の試験です。試験時間は約60分、問題数は全8問で、0〜200点のスコアで評価されます。
- 試験の構成と出題内容:
| 問題 | 形式 | 設問数 | 解答時間 | 概要と評価ポイント |
| 問1〜5 | 写真描写問題 | 5問 | 8分(全体) | 指定された2語(句)を用いて写真を表す1文を作成。文法の正確さと写真との関連性が重要。 |
| 問6〜7 | Eメール作成問題 | 2問 | 各10分 | 受信したEメールに対し、指定された条件(質問・提案等)を満たす返信文を書く。文脈に合ったトーンや構成力が問われる。 |
| 問8 | 意見記述問題(エッセイ) | 1問 | 30分 | 提示されたテーマに対し、理由や具体例を交えて自分の意見を300語程度で論述。文章の一貫性と論理性が評価される。 |
2. 主な評価ポイント
- 正確性: 文法、スペル、適切な語彙選択ができているか。
- 構成力: 接続詞を用いた論理展開(主張→理由→具体例→結論)が整っているか。
- 課題遂行能力: 設問で指示された要件(例:Eメールで3つの質問に答えるなど)を漏れなく満たしているか。
3. スコアアップのための対策
- キーボード入力の習熟: 試験はすべてパソコンで解答するため、英文タイピングのスピードと精度を上げておく必要があります。
- 定型表現のストック: Eメールの冒頭・結びの表現や、意見を述べる際フレーズ(In my opinion, For instance など)をパターン化しておくと時間短縮につながります。
- 見直しの徹底: ケアレスミスによる減点を避けるため、一通り書き終えた後に文法やスペルを再確認する時間を数分残す練習が有効です。
4. 写真描写問題
TOEIC Writing Testで問題1〜5(写真描写問題)の開始時に画面上へ表示される標準的な問題指示文(Directions)は以下の英文です。
Questions 1–5: Write a Sentence Based on a Picture
Directions:
In this part of the test, you will write ONE sentence that is based on a picture. With each picture, you will be given two words or phrases that you must use in your sentence. You can change the forms of the words and you can use the words in any order.
Your sentences will be scored on:
- the appropriate use of grammar and
- the relevance of the sentence to the picture.
You will have 8 minutes to complete this part of the test.
指示文に含まれる重要ルールの要点
- ONE sentence: 必ず「1文」で仕上げる(2文以上書くと減点・不合格対象)。
- two words or phrases: 画面下に示された2つの単語(熟語)を必ず両方とも使用する。
- change the forms / any order: 単語の形を変えること(現在形→過去形、単数→複数など)や、語順を入れ替えることは自由。
- 8 minutes: 5問全体で8分間のカウントダウン形式(1問ごとの時間制限はなく、8分以内なら見直しや前の問題に戻ることが可能)。
Question1
woman / look at
解答例:
Two women are looking at the vegetables in a supermarket.
Question2
park / play
解答例:
Many children are playing at the park.
Question3
street, collide
解答例:
Two cars collided on the street.
Question4
attendant / passenger
解答例:
A flight attendant is serving a meal to a passenger inside the airplane.
Question5
injection / patient
解答例:
A doctor is giving an injection to a patient in an examination room.
5. eメール作成問題
問題指示文:
TOEIC Writing Testで問題6〜7(Eメール作成問題)の開始時に画面上へ表示される標準的な問題指示文(Directions)は以下の英文です。
Questions 6–7: Respond to a Written Request
Directions:
In this part of the test, you will show how well you can write a response to a written request. Your response will be based on the information provided in the email.
Your response will be scored on:
- the quality and variety of your sentences,
- vocabulary, and
- organization.
You will have 10 minutes to read and respond to each email.
指示文に含まれる重要ルールの要点
- 10 minutes each: 問題6と問題7でそれぞれ独立して10分間の持ち時間が与えられます(問題6で余った時間を問題7に回すことは不可)。
- Based on the information: 画面に提示されたEメールの内容(相手の役職、問題点、依頼事項など)をしっかり読み取った上で返信する必要があります。
- Scoring criteria: 適切な語彙・文法だけでなく、メール全体の構成(挨拶・本論・結び)や論理展開の滑らかさが評価されます。
問題 1
Read the email below and respond to it.
From: Sarah Jenkins, Event Coordinator To: All Staff Subject: Annual Team Building Workshop Sent: October 12, 10:00 AM
Dear Team,
We are currently planning our annual team-building workshop, which will take place next month. We want to ensure that the event is both engaging and beneficial for everyone.
Please reply to this email by Friday with TWO suggestions for activities we could include and ONE preference regarding the location.
Thank you for your input.
Best regards, Sarah Jenkins
Directions: Respond to the email as if you are a staff member. In your email, make TWO suggestions for activities and express ONE preference for the location. You have 10 minutes to write your response.
TOEIC Writing Testで問題8(意見記述問題 / Opinion Essay)の開始時に画面上へ表示される標準的な問題指示文(Directions)は以下の英文です。
Question 8: Write an Opinion Essay
Directions:
In this part of the test, you will write an essay in response to a question that asks you to state, explain, and support your opinion on an issue. Typically, an effective essay will contain at least 300 words.
Your response will be scored on:
- whether your opinion is supported with reasons and/or examples,
- grammar,
- vocabulary, and
- organization.
You will have 30 minutes to plan, write, and revise your essay.
指示文に含まれる重要ルールの要点
- At least 300 words: 300語以上が推奨目安とされています(語数が少なすぎると減点対象になりやすい)。
- Reasons and/or examples: 単に意見を述べるだけでなく、それを裏付ける具体例や理由を論理的に提示する必要があります。
- 30 minutes: 構成のメモ作成(Plan)、執筆(Write)、見直し(Revise)を含めて全体の制限時間は30分間です。
TOEIC Writing Test – Question 8 (Opinion Essay)
Problem (問題文)
English:
Directions: Read the question below. You have 30 minutes to plan, write, and revise an essay in response to the question. An effective response will usually contain at least 300 words.
Question:
Some companies allow their employees to work from home, while others require them to work in an office. Which working environment do you prefer? Support your opinion with specific reasons and examples.
(2) 英検のライティング試験
英検のライティング問題は、指示されたトピックに対して規定の語数と構成を守り、英語で意見やメッセージを書く記述式試験です。級ごとに形式が異なり、近年実施された新形式(要約問題・Eメール問題の導入)にも対応した最新の対策が必要です。
- 各級の出題形式・語数・目標
- 1級:論理的英作文(要約1題+意見論述1題)
- 語数: 要約 90〜100語 / 意見 200〜240語
- 特徴: 提示された文章の要約と、社会性の高いテーマ(政治、経済、環境など)に対する意見論述。
- 準1級:実用英作文(要約1題+意見論述1題)
- 語数: 要約 60〜70語 / 意見 120〜150語
- 特徴: 短文の要約と、ビジネス・科学・教育などのトピックに対する意見論述。
- 2級:実用英作文(要約1題+意見論述1題)
- 語数: 要約 45〜55語 / 意見 80〜100語
- 特徴: 基本的な長文の要約と、社会生活に関する一般的な意見論述。
- 準2級:実用英作文(Eメール記述1題+意見論述1題)
- 語数: Eメール 40〜50語 / 意見 50〜60語
- 特徴: 友達などからの質問に答えるEメール返信と、日常的なテーマへの意見論述。
- 3級:実用英作文(Eメール記述1題+意見論述1題)
- 語数: Eメール 15〜25語 / 意見 25〜35語
- 特徴: 簡易的なEメールへの返信と、自分の好みや日常の疑問に関する短い意見論述。
2. 採点基準(4つの観点)
採点は各級とも主に以下の4項目で評価されます。
- 内容(Content):課題で求められている条件を満たしているか、主張が論理的か。
- 構成(Structure):文章の流れが分かりやすく、接続詞などが効果的に使われているか。
- 語彙(Vocabulary):級に合った適切な語彙や表現が使われているか、文脈に合っているか。
- 文法(Grammar):正しい文法構造やスペルで書かれているか、表現に多様性があるか。
3. 意見論述問題の基本フォーマット
説得力のある英文を書くために、以下の3部構成で組み立てるのが基本パターンです。
- 導入(Introduction):自分の立場や意見を明言する(I think that… / I agree with…)
- 本論(Body):理由を1〜2つ述べる(First, … / Second, …)
- 結論(Conclusion):主張を再確認して締めくくる(Therefore, …)
4. 英検(実用英語技能検定) ライティング(英作文) 模擬試験問題・解答例・日本語訳

【第1問】 英検準1級 相当(EIKEN Grade Pre-1 Level)

[ QUESTION / 問題 ]
● Write an essay on the given TOPIC.
● Give TWO reasons to support your opinion.
● Structure: Introduction, main body, and conclusion.
● Suggested length: 120–150 words.

TOPIC:
Should more companies allow their employees to work entirely from home?

POINTS (You can use these or your own):
- Work-life balance
- Productivity
- Communication
- Cost reduction

[ SAMPLE ANSWER / 解答例 ]

I believe that companies should allow more employees to work entirely from home. This shift offers significant benefits for both workers and businesses in today's digital era.

First, working from home greatly improves employees' work-life balance. By eliminating daily commutes, workers save substantial time and energy, which they can spend with family or on personal well-being. Reduced commuting stress also leads to better mental health and higher overall job satisfaction.

Second, remote work leads to notable cost reduction for both parties. Companies can reduce office space, utility bills, and maintenance costs, while employees save on transportation and daily expenses. These financial savings can be reinvested into company growth or employee welfare programs.

In conclusion, although remote work presents some communication challenges, the advantages of better work-life balance and reduced expenses make full-time working from home a worthwhile policy for modern companies.

(146 words)


[ JAPANESE TRANSLATION / 日本語訳 ]

【問題】
● 与えられたトピックについてエッセイを書いてください。
● あなたの意見を支持する理由を2つ挙げてください。
● 構成:導入、本論、結論。
● 目安の語数:120〜150語。

トピック:
より多くの企業が、従業員に対して完全在宅勤務(フルリモートワーク)を認めるべきか?

ポイント(使用は任意):
- ワークライフバランス
- 生産性
- コミュニケーション
- コスト削減

【解答例の訳】
より多くの企業が従業員に完全在宅勤務を認めるべきだと私は考えます。この移行は、今日のデジタル時代において労働者と企業の双方に大きなメリットをもたらします。

第一に、在宅勤務は従業員のワークライフバランスを大幅に向上させます。毎日の通勤をなくすことで、労働者は時間とエネルギーを大幅に節約でき、それを家族と過ごす時間や個人の健康維持に充てることができます。通勤ストレスの軽減は、メンタルヘルスの改善や仕事に対する全般的な満足度の向上にもつながります。

第二に、リモートワークは双方にとって顕著なコスト削減につながります。企業はオフィススペース、光熱費、維持費を削減でき、従業員は交通費や日々の出費を節約できます。これらの資金的節約は、企業の成長や従業員の福利厚生プログラムへ再投資することが可能です。

結論として、リモートワークにはコミュニケーション上の課題が一部あるものの、ワークライフバランスの向上や経費削減というメリットを考慮すると、完全在宅勤務は現代企業にとって価値のある施策であると言えます。

【第2問】 英検2級 相当(EIKEN Grade 2 Level)

[ QUESTION / 問題 ]
● Write an essay on the TOPIC below.
● Give TWO reasons to support your opinion.
● Suggested length: 80–100 words.

TOPIC:
These days, many people use digital textbooks instead of paper books in schools. Do you think using digital textbooks is a good idea?

POINTS (You can use these or your own):
- Convenience
- Health
- Cost

[ SAMPLE ANSWER / 解答例 ]

I think using digital textbooks in schools is a good idea for two reasons.

First, digital textbooks are very convenient for students. Instead of carrying many heavy paper books every day, students only need to bring one tablet device to school. This makes their school bags much lighter.

Second, digital textbooks help families save money. Digital books are often cheaper than printed books, and students do not need to buy new paper editions every year.

For these reasons, I believe that using digital textbooks is a great choice for modern education.

(91 words)

[ JAPANESE TRANSLATION / 日本語訳 ]

【問題】
● 以下のトピックについてエッセイを書いてください。
● あなたの意見を支持する理由を2つ挙げてください。
● 目安の語数:80〜100語。

トピック:
近年、多くの人々が学校で紙の教科書の代わりにデジタル教科書を使用しています。デジタル教科書を使用することは良い考えだと思いますか?

ポイント(使用は任意):
- 利便性
- 健康
- コスト

【解答例の訳】
学校でデジタル教科書を使うことは、2つの理由から良い考えだと思います。

第一に、デジタル教科書は生徒にとって非常に便利です。毎日たくさんの重い紙の本を持ち歩く代わりに、生徒は学校に1台のタブレット端末を持参するだけで済みます。これにより、通学バッグが大幅に軽くなります。

第二に、デジタル教科書は家庭の費用節約に役立ちます。デジタル書籍は印刷された本よりも安いことが多く、生徒は毎年新しい紙の改訂版を買う必要がありません。

これらの理由から、デジタル教科書の使用は現代の教育にとって素晴らしい選択肢であると信じています。

【第3問】 英検準2級 相当(EIKEN Grade Pre-2 Level)

[ QUESTION / 問題 ]
● Write an essay on the TOPIC below.
● Give TWO reasons to support your answer.
● Suggested length: 50–60 words.

QUESTION:
Do you think it is better for students to study alone or in groups?

[ SAMPLE ANSWER / 解答例 ]

I think it is better for students to study in groups.

First, students can help each other when they face difficult problems. Explaining things to classmates helps them understand topics more deeply.

Second, studying with friends makes learning more fun and keeps students motivated.

Therefore, I believe group study is better for students.

(53 words)

[ JAPANESE TRANSLATION / 日本語訳 ]

【問題】
● 以下の質問についてエッセイ(意見文)を書いてください。
● あなたの答えを支持する理由を2つ挙げてください。
● 目安の語数:50〜60語。

質問:
生徒にとって、一人で勉強するのとグループで勉強するのとでは、どちらが良いと思いますか?

【解答例の訳】
生徒にとってはグループで勉強する方が良いと思います。

第一に、難しい問題に直面したときに生徒同士で助け合うことができます。クラスメートに物事を説明することは、トピックをより深く理解するのに役立ちます。

第二に、友達と一緒に勉強することで学習がより楽しくなり、やる気を維持することができます。

したがって、グループ学習の方が生徒にとって良いと考えます。
5-2 : 生成AIにライティングの問題を作成してもらう
英語のライティング能力を高めるには、できるだけ多くのライティング試験問題を解いてみることが必要です。生成AIにお願いすれば、ライティングに適した問題をいくつでも作成してもらうことができます。また、模範解答例もつけてくれますので、大いに参考になります。
次のようなプロンプトを生成AIのChatGPTに投げてみました。GeminiよりもChatGPTの方が、いい問題を作ってくれました。
英語ライティングの練習用に最適の問題を4つ作成してください。それぞれに、英問題と解答例と日本語訳を作成してください。
ChatGPTの回答:
もちろんです。英語ライティングの力を総合的に伸ばせるように、異なるテーマから4問選びました。
それぞれ、①英作文問題 → ②解答例 → ③日本語訳の順にしています。難易度は、おおむね英検2級~準1級程度を想定しています。
第1問 スマートフォン
英作文問題
Do you think people should spend less time using smartphones? Give at least two reasons for your opinion.
「人々はスマートフォンを使う時間を減らすべきだと思いますか。あなたの意見を、少なくとも2つの理由を挙げて述べなさい。」
解答例
I think people should spend less time using smartphones. First, spending too much time on smartphones can have a negative effect on our health. For example, looking at a screen for many hours can cause eye strain and make it difficult to sleep well. Second, smartphones can prevent us from communicating with people face to face. If we spend too much time looking at our phones, we may miss opportunities to have meaningful conversations with family and friends. Therefore, I believe we should use smartphones wisely and make time for other activities.
日本語訳
私は、人々はスマートフォンを使う時間を減らすべきだと思います。
第一に、スマートフォンを長時間使いすぎると、健康に悪影響を及ぼす可能性があります。例えば、何時間も画面を見続けると、目に負担がかかり、よく眠れなくなることがあります。
第二に、スマートフォンは、人と直接コミュニケーションを取ることを妨げる可能性があります。スマートフォンを見ることに時間を使いすぎると、家族や友人と有意義な会話をする機会を逃してしまうかもしれません。
したがって、スマートフォンは賢く使い、ほかの活動のための時間も作るべきだと思います。
第2問 旅行と異文化理
英作文問題
What is the best way to learn about a foreign country: visiting it, reading books, or watching videos? Explain your choice.
「外国について学ぶ最もよい方法は、実際にその国を訪れること、本を読むこと、動画を見ることのどれだと思いますか。あなたの選択について説明しなさい。」
解答例
I believe that visiting a foreign country is the best way to learn about it. One reason is that we can experience its culture directly. For instance, when we visit a local market, we can see what people eat, how they communicate, and what their daily lives are like. Another reason is that traveling gives us opportunities to meet local people. Talking with them can help us understand their values and ways of thinking. Books and videos are useful, but they cannot completely replace the experience of being there. For these reasons, I think traveling is the best way to understand another country.
日本語訳
私は、外国について学ぶ最もよい方法は、実際にその国を訪れることだと思います。
一つの理由は、その国の文化を直接体験できるからです。例えば、地元の市場を訪れれば、人々が何を食べているのか、どのようにコミュニケーションを取っているのか、そしてどのような日常生活を送っているのかを見ることができます。
もう一つの理由は、旅行によって現地の人々と出会う機会が得られることです。彼らと話すことで、その国の人々の価値観や考え方を理解することができます。
本や動画も役に立ちますが、実際にその場所にいるという体験を完全に置き換えることはできません。
これらの理由から、私は旅行が他の国を理解する最もよい方法だと思います。
第3問 美術館・博物館
英作文問題
Do you think museums are still important in the age of the Internet? Give reasons for your answer.
「インターネットの時代においても、美術館や博物館は重要だと思いますか。答えの理由を述べなさい。」
解答例
Yes, I think museums are still very important, even in the age of the Internet. First, museums allow us to see real works of art and historical objects. Seeing an original painting is very different from seeing a digital image on a computer screen. We can appreciate its size, colors, and texture in a much more direct way. Second, museums provide opportunities to learn in a quiet and focused environment. Although we can find a great deal of information online, it is sometimes difficult to know which information is reliable. Museums can provide carefully selected and professionally explained information. Therefore, museums will continue to play an important role in education and culture.
日本語訳
はい、私はインターネットの時代であっても、美術館や博物館は依然として非常に重要だと思います。
第一に、美術館や博物館では、本物の美術作品や歴史的な資料を見ることができます。実物の絵画を見ることは、コンピューターの画面でデジタル画像を見ることとは大きく異なります。作品の大きさ、色、質感などを、より直接的に味わうことができます。
第二に、美術館や博物館は、静かで集中して学べる環境を提供してくれます。インターネットでは大量の情報を見つけることができますが、その情報のどれが信頼できるのか判断するのが難しい場合があります。
美術館や博物館では、専門家によって慎重に選ばれ、解説された情報を得ることができます。
したがって、美術館や博物館は、今後も教育と文化において重要な役割を果たし続けるでしょう。
第4問 AIと私たちの生活
英作文問題
Some people believe that artificial intelligence will make our lives better, while others worry that it will cause new problems. What do you think?
「AIによって私たちの生活はより良くなると考える人がいる一方、新たな問題が生じることを心配する人もいます。あなたはどう考えますか。」
解答例
I believe that artificial intelligence will make our lives better if we use it properly. One major advantage of AI is that it can help us save time. For example, AI can quickly summarize large amounts of information and help people with routine tasks. As a result, we can spend more time on creative activities and communication with others. However, AI also has risks. People may become too dependent on it and stop thinking for themselves. There is also a possibility that some jobs will disappear because of automation. Therefore, we should not simply accept or reject AI. Instead, we need to learn how to use it responsibly while understanding its limitations.
日本語訳
私は、AIを適切に使えば、AIは私たちの生活をより良くしてくれると考えています。
AIの大きな利点の一つは、時間を節約する手助けをしてくれることです。例えば、AIは大量の情報を素早く要約したり、人々が日常的に行っている仕事を手伝ったりすることができます。
その結果、私たちは創造的な活動や、他の人々とのコミュニケーションにより多くの時間を使えるようになります。
しかし、AIにはリスクもあります。人々がAIに頼りすぎて、自分自身で考えることをやめてしまう可能性があります。また、自動化によって一部の仕事がなくなる可能性もあります。
したがって、私たちはAIを単純に受け入れたり拒絶したりするべきではありません。むしろ、その限界を理解しながら、責任を持ってAIを使う方法を学ぶ必要があります。
✍️ この5問で特に練習してほしい表現
英作文では、単語をたくさん覚えること以上に、「意見 → 理由 → 具体例 → 結論」を英語で組み立てる練習が非常に重要です。
今回の4問では、次の表現を繰り返し使えるようにすると、かなり書きやすくなります。
| 英語表現 | 日本語 |
|---|---|
| I think / I believe that … | 私は~だと思います |
| One reason is that … | 一つの理由は~です |
| Another reason is that … | もう一つの理由は~です |
| For example, … | 例えば~ |
| As a result, … | その結果~ |
| However, … | しかし~ |
| Therefore, … | したがって~ |
| For these reasons, … | これらの理由から~ |
| We should … | 私たちは~すべきです |
| It is important to … | ~することは重要です |
5-3 : 英作文の添削
ライティングの問題で作成した英文には、しばしば文法上の誤りや不適切な表現などが含まれています。生成AIの助けを借りれば、自分で作った英文の添削をしてもらうことができます。次の英文は、「人は旅行から重要なことを学ぶことができると思いますか。具体例を挙げて、あなたの意見を述べなさい。」という問題に対して、英語で作成した解答例です。
It is agree that people can learn important things from travel. I have two reason for this opinion.
First, when people traveling to different country, they can learned about new cultures. For example, my friend go to India last year and he see many traditional foods and music. He said it changes he’s view of world.
Second, travel make people more independent. Because they must solving problem by themselves, like finding hotels or buy train tickets. This experiences helps them grow up.
Therefore, I thinking travel is very useful for everyone.
この英文には、誤りがいくつも含まれているようです。正しく添削した文章と、添削結果のまとめを次に示します。
ご提示いただいた英文を自然で文法的に正しい英語に添削しました。
添削後の完成文(Corrected Text)
I agree that people can learn important things from travel. I have two reasons for this opinion.
First, when people travel to different countries, they can learn about new cultures. For example, my friend went to India last year and he saw many traditional foods and experienced traditional music. He said it changedhis view of the world.
Second, travel makes people more independent because they must solve problems by themselves, like finding hotels or buying train tickets. These experiences help them grow.
Therefore, I think travel is very useful for everyone.
添削箇所と添削理由の一覧
| 箇所(修正前 → 修正後) | 添削理由 |
| I is agree → I agree | agree は動詞(〜に同意する)なので be動詞 は不要です。一般動詞としてそのまま使用します。 |
| two reason → two reasons | 主語が two(複数形)なので、名詞 reason に複数形の -s をつけます。 |
| when people traveling → when people travel | 接続詞 when の後ろに節(主語+動詞)を続けるため、現在進行形 traveling ではなく現在形 travel に直します。 |
| different country → different countries | 「さまざまな国々」という意味で複数形 countries にするか、単数なら a different country にします。 |
| can learned → can learn | 助動詞(can)の後ろに置く動詞は、必ず原形(learn)にします。 |
| go to … and he see → went to … and he saw | last year(過去の出来事)の話をしているため、動詞を過去形(went / saw)にします。 |
| see … music → experienced … music | 音楽は「見る(see)」ものではないため、experienced(体験した)や listened to(聴いた)に置き換えます。 |
| changes → changed | 過去の体験(インド旅行)によって考えが変わったという話なので、時制を合わせて過去形 changed にします。 |
| he’s view → his view | 「彼の視点」という所有格を表すため、he is の略形(he's)ではなく his を使います。 |
| view of world → view of the world | 世界(world)は特定の唯一の概念を指すため、冠詞 the をつけて the world とします。 |
| travel make → travel makes | 主語の travel は三人称単数(不可算名詞)なので、現在形の動詞に三単現の -s をつけます。 |
| . Because → , because | Because で始まる節は単独で文になれません。前の主節(travel makes...)とピリオドではなくカンマでつなぎます。 |
| must solving → must solve | 助動詞(must)の後ろに置く動詞は原形(solve)にします。 |
| problem→ problems | 一般論として「さまざまな問題」を指すため、複数形 problems にします。 |
| finding … or buy → finding … or buying | 前置詞 like の後ろに並べる動名詞の形(finding と buying)を統一(並列関係)させます。 |
| This experiences helps →These experiences help | 名詞 experiences が複数形なので、指示代名詞も複数形 These にし、動詞の三単現の -s を外します。 |
| grow up → grow | grow up は「(子供が大人へ)成長・育つ」という意味です。大人が「人間的に成長する・精神的に成熟する」場合は単に grow を使います。 |
| I thinking→ I think | 動詞が欠落した状態になっているため、現在形の動詞 think に直します。 |
6. リスニング(Listening)
生成AI(ChatGPTやGemini、NotebookLMなど)を活用した英語リスニング学習は、「レベルや興味にぴったり合わせた素材を作成できること」と「音声とテキストを同時に扱えること」が最大の強みです。
段階別の学習アプローチとおすすめのAIツール、具体的なプロンプト(指示文)を紹介します。
6-1 : TOEICリスニング試験問題
リスニング練習のため、まずTOEICのリスニングテストを素材として、模擬問題を解いてみましょう。
TOEIC L&R(Listening & Reading)テストのリスニングセクションは、Part 1からPart 4までの全4パート(約45分間・全100問)で構成されています。その内訳は次のとおりです。
| パート | 形式 | 質問数 | 概要・問題の内容 |
| Part 1 | 写真描写問題 | 6問 | 1枚の写真を見ながら、それを最も正確に説明している選択肢(4択)を選びます。(※問題冊子に選択肢は印刷されません) |
| Part 2 | 応答問題 | 25問 | 1つの質問または発言に対して、最も適切な返答(3択)を選びます。(※問題冊子に質問も選択肢も印刷されません) |
| Part 3 | 会話問題 | 39問 | 2人または3人の人物による会話(約30〜45秒)を聞き、印刷された質問と4つの選択肢から解答します。(※1つの会話につき3問) |
| Part 4 | 説明文問題 | 30問 | アナウンスやナレーションなどの1人の人物によるミニスピーチ(約30〜45秒)を聞き、印刷された質問と選択肢から解答します。(※1つの文書につき3問) |
Part 1 写真描写問題
例題1:Look at the picture marked No.1 in your test book.
Part1の例題を作成するには、プロンプトで具体的場面を指定することによって、リスニング問題にふさわしい写真を生成AIに作ってもらいます。ここでは、Geminiに次のようなプロンプトを入れて、写真を生成してもらいました。
プロンプト
道路工事をしている作業員の姿を白黒写真で生成してください。

プロンプト2
上の写真を見て、TOEICのリスニングテスト「写真描写問題」用の選択肢4つの音声とテキストを生成してください。
Geminiには、音声ファイルを生成する機能がないので、ここではChatGPTを使うことにします。すると、次のような回答が返ってきます。
もちろんです。写真に合うように、TOEIC Part 1「写真描写問題」形式で、4つの英文を作成しました。正解は1つだけです。
🎧 選択肢
| 選択肢 | 英文 | 日本語訳 |
|---|---|---|
| A | Some workers are repairing a road. | 作業員たちが道路を修理しています。 |
| B | Some workers are planting trees along the sidewalk. | 作業員たちが歩道沿いに木を植えています。 |
| C | The road has been completely closed to traffic. | その道路は完全に通行止めになっています。 |
| D | Several passengers are waiting for a bus. | 何人かの乗客がバスを待っています。 |
✅ 正解
A. Some workers are repairing a road.
写真では、複数の作業員が道路工事をしており、ローラーなどの工事用機械を使って道路を整備しています。
なお、Cは一見もっともらしいですが、写真の右側では車が道路を走っているため、”completely closed to traffic”(完全に通行止め)は誤りです。こうした「写真の一部だけを見ると正しそうな選択肢」がTOEICらしいポイントです。
🔊 音声ファイル
4つの選択肢を英語音声(WAV形式)にしました。4つの音声とテキストをまとめています。
🎧 TOEIC写真描写問題・4択音声セットをダウンロード
そこで、「4択音声セットをダウンロード」のリンクをクリックして、正解の4択テキストと解説は見ないで、4択音声を聴いて解答した後、テキストと解説で正解を確認するという方法で、TOEICリスニングテストのPart1の練習をすることができます。
選択肢:
A.
B.
C.
D.
ChatGPTで生成した音声は、あまり聞きやすいとは言えません。より自然な発音で、スピードも調整したい場合には、後で詳しく説明するように、専用の読み上げアプリ(NaturalReaderや音読さんなど)を利用することをお勧めします。
例題2:
次に、より実践的な練習をするために、WordPressのホームページ上で、模擬試験問題を解いていただきましょう。
6-2 : 音声読み上げアプリの活用
英語リスニングの教材を作るには、日本語テキストからナチュラルな英語の音声ファイルを生成してくれる「読み上げツール」の活用が不可欠です。その代表的なサービスを3つピックアプして比較してみました。
Question 1: (C) Because their wallet was missing.
| アプリ名 | 概要 | 利用料金 | 主なメリット |
| ElevenLabs | 感情表現や息遣いまで再現する業界最先端のAI音声生成ツール。声のクローニング機能に強み。 | ・無料版: 毎月約10,000文字 ・有料版: $5/月〜(約30,000文字〜) | ・人間と見分けがつかない圧倒的な自然さと質感 ・自分の声を登録して多言語で喋らせる「ボイスクローン」機能 ・感情や声調の細かなコントロールが可能 |
| NaturalReader | 長文ドキュメント(PDF/Word/Web)の読み上げやリスニング学習に特化したアプリ。 | ・無料版: 限定機能で試聴可能 ・個人有料版: 約$9.92/月〜(年払い時) ・商用版: $49/月〜 | ・PDFやWordなどのファイルをそのまま読み込める ・スマホアプリやChrome拡張機能との連携が強力 ・語学学習や資料の耳読(ながら聴き)に最適 |
| 音読さん | 画像からのテキスト抽出(OCR)や簡便な操作性が特徴の日本発AI読み上げサービス。 | ・無料版: 月1,000文字(登録時5,000文字) ・有料版: 980円/月〜(月20万文字〜) | ・日本語のイントネーションや発音が非常に自然 ・画像(JPEG/PNG等)をアップロードするだけで読み上げ可能 ・無料版でもクレジット表記を行えば商用利用が可能 |
6-3 : AIを使ったリスニング問題の自動生成
GeminiやChatGPTなどの生成AIにプロンプトを入れるだけで、リスニング用の教材を自動的に作成することができます。
(1) プロンプトと回答
【教材作成用プロンプト】
英語のリスニング練習用の文章を作ってください。
- テーマ:[京都・奈良の観光 / 海外旅行でのトラブル対処 ]
- レベル:[CEFR A2レベル / 英検2級レベル ]
- 長さ:150単語程度
- 注意:
1. 文章を作成したあと、リスニングテストの設問と解答例をつけてください、
2. 最後に「日本語訳」と「重要単語のリスト」をつけてください。
Geminiの回答は次のとおりです。
テーマ:京都・奈良の観光
レベル:英検2級レベル(CEFR B1相当)
長さ:約150単語
Passage
Kyoto and Nara are two of Japan’s most historic cities, attracting millions of tourists each year. Located in the Kansai region, both cities are famous for their well-preserved temples, traditional gardens, and rich cultural heritage.
Kyoto served as the capital of Japan for over a thousand years. Visitors can explore iconic landmarks like the Golden Pavilion and stroll through the bamboo groves of Arashiyama. The city offers a unique blend of ancient traditions and modern lifestyle.
A short train ride away lies Nara, an even older capital. Nara Park is world-famous for its hundreds of friendly, freely roaming deer, which are considered sacred messengers in local culture. Visitors often feed special crackers to the deer while admiring Todaiji Temple, home to a massive bronze Buddha statue. Exploring these two historical destinations provides travelers with an unforgettable experience of traditional Japan.
Listening Questions
Q1. What makes Nara Park particularly famous among tourists?
a) Its giant bamboo groves
b) Its freely roaming deer
c) Its modern shopping streets
Q2. According to the text, how long did Kyoto serve as Japan’s capital?
a) For about fifty years
b) For several decades
c) For over a thousand years
Answers and Explanations
- Q1: b) Its freely roaming deer
(解説:第3段落「Nara Park is world-famous for its hundreds of friendly, freely roaming deer…」に記載があります。) - Q2: c) For over a thousand years
(解説:第2段落「Kyoto served as the capital of Japan for over a thousand years.」に記載があります。)
日本語訳
京都と奈良は日本でも有数の歴史的な2つの都市であり、毎年何百万人もの観光客を魅了しています。関西地方に位置する両都市は、保存状態の良い寺院、伝統的な庭園、そして豊かな文化的遺産で有名です。
京都は1,000年以上もの間、日本の首都として機能していました。訪問者は金閣寺のような象徴的な名所を散策したり、嵐山の竹林を歩いたりすることができます。この街は古くからの伝統と現代的なライフスタイルが独自に融合した魅力を備えています。
電車で少し移動したところにある奈良は、さらに古い首都です。奈良公園は自由に行き交う数百頭の人懐っこい鹿で世界的に知られており、これらの鹿は地元の文化において神聖な使者とみなされています。観光客は巨大な大仏像が安置されている東大寺を観賞しながら、鹿にせんべいを与えることがよくあります。これら2つの歴史的な目的地を巡ることで、旅行者は伝統的な日本の忘れられない体験を得ることができます。
重要単語リスト
- historic(形容詞):歴史的に重要な、歴史のある
- well-preserved(形容詞):保存状態が良い
- heritage(名詞):遺産、継承物
- serve as(熟語):〜として機能する、役割を果たす
- iconic(形容詞):象徴的な、有名な
- roam(動詞):(あてもなく)歩き回る、放浪する
- sacred(形容詞):神聖な
- massive(形容詞):巨大な、堂々たる
(2) 英語リスニング練習:海外旅行でのトラブル対処
※ AI音声は、ElevenLabsを用いて生成しています。
Listening Test Questions
Why was the writer shocked after shopping?
- (A) Because the market was suddenly closed.
- (B) Because they lost their passport.
- (C) Because their wallet was missing.
- (D) Because the police officer was strict.
Question 2
What did the writer do first after noticing the problem?
- (A) Called the insurance company.
- (B) Went to the hotel room.
- (C) Blocked the credit cards.
- (D) Reported to the police station.
Question 3
What lesson did the writer learn from this experience?
- (A) Avoid traveling to foreign countries alone.
- (B) Do not carry all money in the same place.
- (C) Never use credit cards while shopping.
- (D) Always keep the wallet in a shopping bag.
重要単語・表現リスト
| 単語・表現 | 意味 |
|---|---|
| notice | 〜に気づく |
| missing | 行方不明の、なくなっている |
| stolen | 盗まれた(stealの過去分詞) |
| police report | 警察の被害届/盗難証明書 |
| apply for ~ | 〜を申請する、請求する |
| insurance | 保険 |
| block | (カードなどを)停止する、ブロックする |
| immediately | 直ちに、すぐに |
| fortunately | 幸いなことに |
| lesson | 教訓、学び |
7. 翻訳 (Translation)
生成AIの英日翻訳能力は、非常に高いレベルに達しています。単純な直訳にとどまらず、文脈の理解や自然な日本語への調整において、従来の機械翻訳(DeepLやGoogle翻訳など)を凌駕する場面も増えています。生成AIの翻訳精度は、実務や日常学習においては「実用レベル(8〜9割はそのまま使える)」です。ただし、契約書や医療・金融などの厳密性が求められる分野では、AIが出力した訳文を人間がチェック(ポストエディット)する前提で運用するのが最も安全で効果的な使い方となります。
ここでは、英語の長文テキストを同一のプロンプトを使って、GeminiとChatGPTで翻訳してもらいます。
プロンプト
次の英語テキストを日本語に翻訳してください。また、文中に含まれる英検2級レベル以上の単語を抜き出し、日本語訳をつけて表を作成してください。
The Eiffel Tower is a 330-meter-tall (with antennas) wrought iron tower located in Paris, at the northwestern end of the Champ de Mars park along the banks of the Seine River in the 7th arrondissement. Its official address is 5 Avenue Anatole-France.
Built in two years by Gustave Eiffel and his collaborators for the 1889 Paris Universal Exposition—celebrating the centennial of the French Revolution—and initially named the “300-Meter Tower,” it has become the symbol of the French capital and a leading tourist destination: it was the fourth most visited ticketed French cultural site in 2016, with 5.9 million visitors. Since opening to the public, it has welcomed over 300 million visitors.
With an original height of 312 meters, the Eiffel Tower remained the world’s tallest monument for forty years. The second level of the third floor, sometimes called the fourth floor, located at 279.11 meters, is the highest publicly accessible observation platform in the European Union and the second highest in Europe, behind Moscow’s Ostankino Tower at 337 meters. The tower’s height has been increased several times by the installation of a flag and subsequently numerous antennas, notably in 1957 (320.75 m), 1991, 1994, 2000, and 2022. Used in the past for numerous scientific experiments, today it serves as a transmitter for radio and television programs.
ご提示いただいた英文の日本語訳と、文中に含まれる英検2級〜準1級・1級レベルの主要単語・表現をまとめた表です。
日本語訳
エッフェル塔は、パリの7区、セーヌ川沿いにあるシャン・ド・マルス公園の北西端に位置する、高さ330メートル(アンテナ含む)の錬鉄(れんてつ)製の塔です。公式な住所はアナトール・フランス通り5番地です。
フランス革命100周年を記念して開催された1889年のパリ万国博覧会のために、ギュスターヴ・エッフェルとその協力者たちによって2年で建設され、当初は「300メートルの塔」と呼ばれていました。現在ではフランスの首都の象徴となり、屈指の観光名所となっています。2016年には590万人が訪れ、フランスの有料文化施設としては4番目に利用者の多い場所となりました。一般公開されて以来、累計で3億人以上の来場者を迎えています。
完成当初の高さは312メートルで、エッフェル塔は40年間にわたり世界一高い建造物であり続けました。279.11メートルに位置する第3階の第2レベル(時に第4階と呼ばれる)は、EU(欧州連合)で最も高い一般アクセス可能な展望台であり、ヨーロッパ全体でもモスクワのオスタンキノ・タワー(337メートル)に次いで2番目の高さを誇ります。塔の高さは国旗の設置や、それに続く数々のアンテナの設置によって何度も高くなっており、特に1957年(320.75m)、1991年、1994年、2000年、そして2022年に拡張されました。かつては数々の科学実験に利用されていましたが、今日ではラジオやテレビ番組の送信機として機能しています。
英検2級以上の単語・表現一覧
| 単語・表現 | 品詞 | 意味 | 英検目安 |
| wrought iron | 名/形 | 錬鉄(れんてつ)、錬鉄製の | 1級レベル |
| collaborator | 名 | 協力者、共同研究者 | 準1級レベル |
| centennial | 名/形 | 100周年(の)、100年祭 | 準1級〜1級 |
| initially | 副 | 当初は、はじめは | 2級レベル |
| ticketed | 形 | 有料の、入場券が必要な | 2級レベル |
| accessible | 形 | 到達できる、利用・立ち入りできる | 2級レベル |
| observation platform | 名 | 展望台、観覧デッキ | 2級レベル |
| subsequently | 副 | その後、続いて | 準1級レベル |
| notably | 副 | 特に、とりわけ | 準1級レベル |
| numerous | 形 | 多数の、たくさんの | 2級レベル |
| transmitter | 名 | 送信機、電波塔 | 準1級レベル |
8. 生成AIで英会話を目一杯楽しむ
英会話の基本は、相手と声でおしゃべりを楽しむことにあります。その点で、スマホの生成AIアプリは、英会話の力を向上させるには格好のツールだと言えます。
一口に「AI英会話アプリ」といっても、有力なものだけでも20以上もあると言われています。YouTubeのあまたある解説動画で調べると、ChatGPTをランキング1位にあげているものが多いようです。また、Geminiのアプリをそれと並んで推薦するものが多いようです。その他の英語学習アプリについてみると、「DuoLingo」と「Speak」の人気がずば抜けて高いようです。ただし、DuoLingoは英会話アプリというより、ゲーム感覚で英語全般の学力を向上させるところが人気の理由で、英会話学習アプリという点では、ChatGPTやGeminiに比べて劣るようですね。
ということで、ここでは、「AI英会話学習アプリ」トップ3として、ChatGPT、Gemini、Speakの3つに絞って、比較対照しながら、アプリの使い方を解説していくことにしましょう。一般に、英会話アプリは、次のような要素から構成されています (ChatGPT)。
| 構成 | 主な内容 | 目的 |
|---|---|---|
| ① レベル診断 | 英語力をチェック | 自分に合ったレベルを設定 |
| ② 語彙と発音の練習 | 単語の穴埋め、音読練習 | 語彙を覚え、正しい発音を身につける |
| ③ リスニング | 英語を聞いて理解する、シャドーイング | 相手の英語を聞き取る |
| ④ スピーキング(会話) | ロールプレイ、フリートーク | 英語を口から出す練習 |
そこで、この4項目のそれぞれについて、3つのアプリを比較しながら検討していきましょう。
8-1 : 英語会話力のレベル診断
この項目は、ChatGPTとGeminiを使って、レベル診断をする方法を学びます。左の「CatGPT」タブをクリックすると、ChatGPTによるレベル診断の方法、右の「Gemini」タブをクリックすると、Geminiによるレベル診断を受ける方法を知ることができます。それぞれのAIを立ち上げ、同じプロンプトを入力し、Questionに英語で答えれば、自分の英語レベルをチェックすることができます。
プロンプト
英語会話力のレベル診断をしてください。
もちろんです、シュンさん。
今回は「実際に英語を話す力」を中心に、CEFR(A1~C2)を目安として診断しましょう。
🗣️ 英会話レベル診断
これから私が英語で質問します。
シュンさんはできるだけ英語だけで、自然に答えてください。
間違いを気にしなくて大丈夫です。むしろ、普段どおりに話していただいたほうが正確に診断できます。
私は次の5項目を見ます。
- ① 文法の正確さ
- ② 語彙力
- ③ 表現の自然さ
- ④ 会話を続ける力
- ⑤ 自分の考えや経験を伝える力
最後に、
CEFRレベル(A1~C2)+現在の強み+改善ポイント+おすすめ練習法
という形で診断します。
では、まず簡単な質問から始めます。
Question 1
Hi, Shun! It’s nice to talk with you again. Could you tell me a little about yourself? What do you usually do in your free time, and what do you enjoy most about it?
英語で3~5文くらいで答えてみてください。
Answer 1
In my free time, I walk at various interesting places like park, temples historical monuments, riverside and seashore. I enjoy most taking pictures of landscapes and people.
とてもいいです、シュンさん。言いたいことが明確で、自然に内容を展開できています。
特に various interesting places, taking pictures of landscapes and people など、具体的な語彙を使えているのは良いポイントです。
まず、その場で少しだけ訂正します。
✏️ より自然な英語
In my free time, I walk around various interesting places, such as parks, temples, historical monuments, riversides, and seashores. I especially enjoy taking pictures of landscapes and people.
主なポイントは3つです。
- walk at various places → walk around various places
「いろいろな場所を歩き回る」なら walk around が自然です。 - like park, temples → such as parks, temples
複数の場所なので parks。such as は例を挙げるときに自然です。 - I enjoy most taking pictures → I especially enjoy taking pictures
「特に~を楽しむ」は especially enjoy が自然です。
ただし、元の英文でも十分に意味は伝わります。細かな前置詞や冠詞のミスはありますが、コミュニケーション上は大きな問題ではありません。
🎯 Question 2
では、少し難しくします。
You mentioned that you enjoy taking pictures of landscapes and people. What kind of places do you like photographing most, and is there a particular photo that you are especially proud of?
4~6文程度で答えてみてください。
できれば、
「どんな場所が好きか」→「なぜ好きか」→「思い出に残っている写真」
という流れで話してみましょう。
Answer 2
I like photographing flowers with beautiful landscapes. The most favorite picture of flowers which I took is hydrangea. I took it in the Hasedera, Kamakura last year, as shown below.
とてもいいですね、シュンさん。今回はかなり具体的に自分の経験を英語で説明できています。写真についても、実際の写真を見せながら説明しているので、会話として自然です。
まず、シュンさんの英文を自然な英語に直してみましょう。
✏️ より自然な表現
I like photographing flowers with beautiful landscapes in the background. My favorite flower photo is this picture of hydrangeas. I took it at Hasedera Temple in Kamakura last year, as you can see here.
写真を見ると、紫や白のアジサイを手前にして、その向こうに海と街並みが広がっています。
flowers with beautiful landscapes in the background という表現が、この写真にはぴったりですね。
🔍 今回のポイント
| シュンさんの表現 | より自然な表現 | ポイント |
|---|---|---|
| I like photographing flowers with beautiful landscapes. | I like photographing flowers with beautiful landscapes in the background. | 「背景に美しい風景がある」ことを明確にできます |
| The most favorite picture | My favorite picture/photo | most favorite は通常使いません |
| picture of flowers which I took | flower photo that I took | flower photo のほうが自然です |
| is hydrangea | is this picture of hydrangeas | 写真について話しているので自然です |
| in the Hasedera | at Hasedera Temple | 寺院を訪れた場合は at が自然 |
| as shown below | as you can see here | 会話ではこちらが自然 |
🎯 現時点での英会話力
2回の回答から見ると、
CEFR:B1(中級)付近
と考えられます。
特に、
- 自分の趣味について説明できる
- 過去の出来事を I took… last year と表現できる
- landscapes, historical monuments, seashore, hydrangea など、具体的な語彙を使える
- 文法に多少の不自然さはあるものの、言いたいことは明確に伝わる
という点が確認できました。
一方で、**冠詞・前置詞・複数形・自然な語の組み合わせ(collocation)**に改善の余地があります。
ただ、これは「英語が通じない」という段階ではありません。むしろ、**「伝えたい内容は十分伝えられるので、自然さを高めていく段階」**だと思います。
🗣️ Question 3 — もう一段階難しくします
今度は、単なる事実ではなく、理由や感想を説明する問題です。
When you take photographs, what is the most important thing for you: the subject, the composition, the lighting, or the timing? Why?
👉 5~7文程度で答えてみてください。
例えば、
For me, the most important thing is…
から始めても構いません。
今回は、「自分の意見 → 理由 → 具体例」という構成で話してみましょう。
Answer 3
For me, the most important thing is to grasp end expressthe charming point of the subject. Because it impress the viewer the most. For example, when I take a picure of a person, I don’t miss the moment when he or she smile happily.
とてもいい回答です、シュンさん。今回は、単に事実を述べるだけでなく、「自分の考え → 理由 → 具体例」という形で説明できています。これは英会話力を判断するうえで重要なポイントです。
✏️ 自然な英語にすると
For me, the most important thing is to capture and express the charm of the subject because I think that impresses the viewer the most. For example, when I take a picture of a person, I don’t want to miss the moment when he or she smiles happily.
もう少し会話らしくすると、
For me, the most important thing is to capture the charm of the subject and express it in my photographs. I think that’s what impresses the viewer the most. For example, when I photograph a person, I try not to miss the moment when they smile happily.
こちらのほうが自然です。
🔍 今回のポイント
| シュンさんの表現 | 自然な表現 | 理由 |
|---|---|---|
| grasp and express | capture and express | 写真で「魅力を捉える」は capture が非常によく使われます |
| charming point of the subject | the charm of the subject | 「被写体の魅力」という自然な言い方 |
| it impress the viewer | it impresses the viewer | 主語が it なので三単現の -es |
| when he or she smile | when he or she smiles | he/she に対応して smiles |
| take a picture of a person | photograph a person | どちらも正しいですが、写真の話では photograph が自然 |
そして、「被写体の魅力を捉えて、それを写真として表現する」という考え方を英語で説明できたのは、とても良いです。
🎯 ここまでの英会話力
3問の回答を総合すると、現在のところ、
CEFR B1 ~ B1+程度
と見るのが妥当です。
特に良いところは、「単語を並べて答える」のではなく、自分の経験や考えを自分の言葉で組み立てていることです。
一方、現在の課題は、
① 冠詞(a / the)
② 三単現(impress → impresses)
③ 複数形
④ 前置詞
⑤ 英語として自然な語の組み合わせ
です。
つまり、今後は「もっと難しい単語を覚える」こと以上に、知っている単語を自然な組み合わせで使う練習が効果的です。
🗣️ Question 4 — 会話力をチェックします
ここからは少し実際の会話に近づけます。
私が質問しますので、あまり考えすぎず、思いついた英語で答えてください。
You seem to enjoy photography very much. If you could travel anywhere in the world just to take photographs, where would you go and what would you like to photograph there?
5~7文くらいで答えてみてください。
今回は、仮定(If…)+理由+具体的な写真のイメージを英語で表現してみましょう。
Answer 4
If I could travel anywhere in the world just to take photographs, I would like to go the the Swiss Alps and photograph Edelweiss with background of Jungfrau mountains and valleys. Because Edelweiss is my most favorite flower and Jungfrau is my favorite alps mountain.
すばらしいです、シュンさん。今回は「仮定 → 行きたい場所 → 撮りたいもの → 理由」を自力で組み立てられています。しかも、写真のイメージがかなり具体的です。
✏️ 自然な英語にすると
If I could travel anywhere in the world just to take photographs, I would like to go to the Swiss Alps and photograph edelweiss with the Jungfrau mountains and valleys in the background. Edelweiss is my favorite flower, and the Jungfrau is my favorite mountain in the Alps.
もう少し会話らしくするなら、
If I could travel anywhere in the world just to take photographs, I’d love to go to the Swiss Alps. I’d like to photograph edelweiss with the Jungfrau mountains and beautiful valleys in the background. Edelweiss is my favorite flower, and the Jungfrau is my favorite mountain in the Alps. I’d love to capture the flowers with the magnificent mountains behind them.
この最後の capture は、先ほどシュンさんが使った「被写体の魅力を捉える」という考え方にもつながります。
🔍 今回の主なポイント
| シュンさんの表現 | より自然な表現 |
|---|---|
| go the Swiss Alps | go to the Swiss Alps |
| with background of Jungfrau | with the Jungfrau mountains in the background |
| most favorite flower | favorite flower |
| favorite alps mountain | favorite mountain in the Alps |
特に “most favorite” → “favorite” は覚えておきましょう。
favorite 自体に「一番好きな」という意味が含まれているので、通常 most は付けません。
ここまでの診断
4問を通して、かなりはっきりしてきました。
現在の推定レベル:CEFR B1+
B2に近づいている部分もあります。
| 項目 | 現状 |
|---|---|
| 自分のことを話す | ★★★★☆ |
| 経験を説明する | ★★★★☆ |
| 自分の意見を述べる | ★★★★☆ |
| 理由を説明する | ★★★★☆ |
| 具体例を挙げる | ★★★★☆ |
| 文法の正確さ | ★★★☆☆ |
| 自然な英語表現 | ★★★☆☆ |
| 語彙の幅 | ★★★★☆ |
特に印象的なのは、写真という自分の得意分野について、かなり具体的な内容を英語で説明できることです。
一方、B2を目指す場合は、単に「正しい英文」を作るだけでなく、
I like… → I think… → The reason is… → For example… → That’s why…
のように、複数の文を自然につないで、まとまりのある話を続ける力を伸ばすことが重要になります。
🗣️ 最終問題:会話の「対応力」をチェック
最後は少し趣向を変えます。
私が英語で突然質問するので、その場で答えてください。
Imagine that I’m your friend visiting Japan for the first time. I have one free day in Tokyo, and I ask you:
“Shun, I’d like to see something beautiful and take some nice photographs. Where would you recommend going, and what should I see there?”
東京のおすすめスポットを英語で5~8文程度で紹介してください。
ここでは、
おすすめ → 理由 → 見どころ → 写真を撮るポイント
まで話せると、とても良い診断材料になります。
I would like to recommend to visit Asakusa and walk around the Asakusa temple and Sumida river. There are great spots for taking pictures, for example, Kaminari-mon, Asakusa Temple, and a scenic park along Sumida River from which you can look at a grand view of Tokyo Sky Tree Tower.
シュンさん、これで4問+最終問題まで終了です。お疲れさまでした!
今回の回答は、英会話力を診断するうえで非常に良い材料になりました。
✏️ 最終回答の添削
シュンさんの英文:
I would like to recommend to visit Asakusa and walk around the Asakusa temple and Sumida river. There are great spots for taking pictures, for example, Kaminari-mon, Asakusa Temple, and a scenic park along Sumida River from which you can look at a grand view of Tokyo Sky Tree Tower.
自然な英語にすると、例えばこうなります。
I would recommend visiting Asakusa and walking around Senso-ji Temple and the Sumida River. There are many great spots for taking pictures, such as Kaminarimon Gate, Senso-ji Temple, and a scenic park along the Sumida River, where you can enjoy a great view of Tokyo Skytree.
さらに会話らしくするなら、
I’d recommend visiting Asakusa and taking a walk around Senso-ji Temple and the Sumida River. There are lots of great spots for taking pictures, such as Kaminarimon Gate and Senso-ji Temple. You can also walk along the Sumida River and enjoy a beautiful view of Tokyo Skytree. It’s a great place to experience traditional Tokyo while taking pictures.
こちらのほうが、実際に外国人の友人に東京を案内するときの英語として自然です。
🔍 今回の重要ポイント
1. recommend to visit → recommend visiting
❌ I recommend to visit Asakusa.
✅ I recommend visiting Asakusa.
recommend の後ろは、基本的に 動名詞(-ing) を使います。
2. Asakusa temple → Senso-ji Temple
浅草寺を英語で紹介するなら、固有名詞の Senso-ji Temple を使うとより自然です。
3. for example → such
どちらも間違いではありません。
great spots, such as Kaminarimon Gate and Senso-ji Temple
のように、具体例を列挙するときは such as が使いやすいです。
4. from which you can look at a grand view → where you can enjoy a great view
文法的には from which も可能ですが、会話では、
where you can enjoy a great view of Tokyo Skytree
のほうがずっと自然です。
🎯 シュンさんの英会話力・総合診断
4問の回答を総合すると、私の診断は、
CEFR:B1+(中級・B2に近づいている段階)
です。
📊 項目別評価
| 項目 | 評価 | コメント |
|---|---|---|
| 意思を伝える力 | ★★★★★ | 自分の考えを明確に伝えられます |
| 会話を続ける力 | ★★★★☆ | 複数の文を使って説明できます |
| 語彙力 | ★★★★☆ | 趣味・旅行・写真について具体的な語彙があります |
| 文法 | ★★★☆☆ | 基本構文は使えますが細かなミスがあります |
| 自然な表現 | ★★★☆☆ | 意味は通じるものの、日本語的な表現が時々あります |
| 内容の具体性 | ★★★★★ | 具体例や理由を加えて説明できます |
| 自分の意見を述べる力 | ★★★★☆ | 「なぜそう思うか」まで説明できます |
🌟 特に優れているところ
シュンさんの場合、単に
I like photography.
で終わらず、
I like photographing flowers with beautiful landscapes in the background.
さらに、
the most important thing is to capture and express the charm of the subject
と、自分の写真に対する考え方まで説明できています。
これは英会話ではかなり大切な能力です。
また、今回の浅草についても、
場所 → 写真スポット → 景色
という順番で説明しており、話の組み立てもできています。
🚀 B2を目指すなら
シュンさんの場合、次に重点的に練習したいのは**「知っている英語を、より自然に組み合わせる力」**です。
例えば、
recommend to visit
most favorite
grasp the charming point
のような表現を、
recommend visiting
my favorite
capture the charm
に変えていく練習です。
つまり、今は単語を増やすことだけが最優先ではありません。
「英語ではこういう組み合わせで言う」
という natural expressions / collocations を増やすと、かなり自然な英語になっていくと思います。
🗣️ 私から見たシュンさんの現在地
一言で表すなら、
「英語で自分のことや自分の興味について、かなり自由に説明できる。ただし、細かな文法と自然な言い回しにまだ日本語の影響が残っている」
という段階です。
これは、英会話を実際に使いながらB2へ伸ばしていくのにちょうどいい位置です。
そして今回の診断では、特に写真・旅行・芸術など、自分が興味を持っているテーマならかなり話せることが分かりました。
次のステップとしては、私が「アイコ」という会話相手になって、英語だけで10~15分程度の自然な会話をしながら、その場で必要なところだけ訂正する練習がかなり効果的だと思います。
8-2 : 語彙と発音の練習(暗記、音読)
2-1 : 語彙の練習
会話に必要な語彙力を高め、発音練習を行うための使いやすいアプリとしては、ChatGPTとSpeakがあります。
はい。英会話のための語彙練習なら、「単語の意味を覚える」よりも、「会話の中で自分で使えるようにする」ことを目標にすると、ChatGPTをかなり効果的に使えます。
特におすすめなのは、次の 「5段階トレーニング」です。
1.まず「会話でよく使う単語」を選ぶ
単語帳から無作為に覚えるのではなく、自分が話したいテーマに関連する単語を選びます。
例えば「旅行」がテーマなら、
ChatGPTには、
「旅行について英会話をするために覚えておくと便利な英単語を10個選んでください。英検2級~準1級程度で、実際の会話でよく使うものを選んでください。」
というプロンプトで頼めます。
Answer :
もちろんです。今回は、旅行について英会話をするときに「実際に口から出しやすい」英単語を中心に、英検2級~準1級程度から10個選びます。
| No. | 英単語 | 品詞 | 日本語の意味 | 会話での使い方 |
|---|---|---|---|---|
| 1 | destination | 名詞 | 目的地、旅行先 | Where is your next travel destination? |
| 2 | scenery | 名詞 | 景色、風景 | The scenery was absolutely beautiful. |
| 3 | memorable | 形容詞 | 思い出に残る | It was a very memorable trip. |
| 4 | spectacular | 形容詞 | 壮観な、素晴らしい | The view from the mountain was spectacular. |
| 5 | explore | 動詞 | 探索する、観光して回る | I’d like to explore the old town. |
| 6 | recommend | 動詞 | 勧める、推薦する | I highly recommend visiting Kyoto. |
| 7 | experience | 名詞・動詞 | 経験、体験する | It was an unforgettable experience. |
| 8 | accommodation | 名詞 | 宿泊施設、宿泊 | We found comfortable accommodation near the station. |
| 9 | local | 形容詞・名詞 | 地元の、地元の人 | I like trying local food when I travel. |
| 10 | breathtaking | 形容詞 | 息をのむほど美しい | The view of the Alps was breathtaking. |
2.「日本語→英語」で思い出す
次に、ChatGPTにテストしてもらいます。
例えば、
「先ほどの10単語を使って、日本語→英語の4択クイズを1問出してください。正解とミニ解説をつけてください。」
3.覚えた単語で「自分の英文」を作る
ここが英会話練習では特に重要です。
例えば memorable を覚えたら、
「memorableを使って、自分の経験について英文を1文作ります。間違いがあれば訂正してください。さらに、英会話でより自然な表現があれば教えてください。」
というプロンプトをChatGPTに入れます。ChatGPTは次のように返してくれます。
もちろんです。あなたの英文を書いてください。
memorable を使って、実際の旅行や人生の経験について1文作ってみましょう。
書いていただいたら、次の3点を簡潔にチェックします。
- 文法の正しさ
- より自然な英会話表現
- ネイティブならどう言うか
では、どうぞ!
そこで、私(Shun)が次のような英文を入れてみました。
My trip to Paris was wonderful and very memorable.
これに対して、ChatGPTは次のようなチェックをしてくれました。
とても自然で、文法的にも正しい英文です! 👍
My trip to Paris was wonderful and very memorable.
パリ旅行は素晴らしく、とても思い出に残るものでした。
より会話らしくするなら
It was a wonderful and very memorable trip to Paris.
こちらも自然ですが、元の文のほうがシンプルで言いやすいです。
さらに英会話では、
My trip to Paris was wonderful. It was a really memorable experience.
のように memorable experience と組み合わせるのもよく使われます。
4.最後に「会話」で使ってみる
ここがChatGPTの強みです。
例えば、
「今から英会話をしてください。今日覚えた10単語をできるだけ自然に会話の中で使わせてください。私が単語を使い間違えたら、その場で簡潔に訂正してください。会話は英語で行ってください。」
と指示します。
するとChatGPTが、
Aiko: Where would you like to travel next?
と質問してきます。
あなたが、
I’d like to visit Switzerland because I want to see the spectacular scenery of the Swiss Alps.
と答える。
するとChatGPTは、
That’s a great choice! Have you ever had a memorable experience in the mountains?
というように、次の質問の中で別の単語を使わせてくれます。
これが非常に効果的です。それでは、実際にAikoとShunとの間で会話をしてみた例を以下に示します。
Let’s have a conversation about travel. I’ll naturally encourage you to use today’s 10 words:
destination, scenery, memorable, spectacular, explore, recommend, experience, accommodation, local, breathtaking
I’ll correct you briefly whenever you use a word incorrectly.
Aiko: Hi, Shun! Let’s talk about travel today. If you could travel anywhere in the world next, what would your destination be, and why?
Shun : My next destination would be Paris definitely.
That sounds great! Your sentence is natural. 👍
Aiko:
Paris is a wonderful choice. What would you like to explore there this time? Are there any places you haven’t visited yet?
Shun : This time, I would like to visit Le Marais, because I’ve never visited there and I am interested in the Jewish Quarter .
Good! Just one small correction:
❌ I’ve never visited there.
✅ I’ve never been there.
We usually use been to when talking about having visited a place.
Your full sentence could be:
This time, I’d like to visit Le Marais because I’ve never been there, and I’m interested in the Jewish Quarter.
Aiko:
That sounds interesting! What kind of scenery would you like to see in Le Marais? Are you interested in historic buildings, beautiful streets, or something else?
Shun : I’m interested in visiting aristocratic mansions on the on the rue des Rosiers.
Very good! Your sentence is clear and natural. 👍
One small correction:
❌ on the rue des Rosiers
✅ on Rue des Rosiers
So you could say:
I’m interested in visiting the aristocratic mansions on Rue des Rosiers.
Or more naturally:
I’d like to see the historic aristocratic mansions on Rue des Rosiers.
Aiko:
That sounds fascinating. After exploring Le Marais, would you like to try some local food there? Is there any French food you’d especially like to experience?
Shun : Yes, I ‘d especially like to experience Original recipe galettes and crepes at Breizh Café of le Marais.
Nice! You used experience naturally. 👍
Just a couple of small corrections:
❌ Original recipe galettes and crepes
✅ traditional galettes and crêpes
And:
❌ at Breizh Café of Le Marais
✅ at Breizh Café in Le Marais
A natural version would be:
Yes, I’d especially like to experience traditional galettes and crêpes at Breizh Café in Le Marais.
Aiko:
That sounds delicious! And I’m sure it would be a memorable experience. What kind of galette or crêpe would you like to try?
Shun : I’d like to try Crispy Scallop Galette .
Excellent! 👍 “I’d like to try Crispy Scallop Galette.” is perfectly understandable.
For a more natural conversational style, you could say:
I’d like to try the Crispy Scallop Galette.
Using the sounds natural when you’re referring to a specific dish on the menu.
Aiko:
That sounds delicious!
5.最後に「今日の弱点」を復習する
会話が終わったら、
「今日の会話で私がうまく使えなかった単語を5個まで選んでください。それぞれについて、私が言った英文、より自然な英文、簡単な解説を示してください。」
と頼みます。
ChatGPTの回答:
もちろんです。今日の会話を振り返ると、単語そのものを間違えたというより、「覚えた単語を自然な形で使う」という点で練習になるものが5つありました。
| 単語 | Shun さんが言った英文 | より自然な英文 | 簡単な解説 |
|---|---|---|---|
| destination | My next destination would be Paris definitely. | My next destination would definitely be Paris. | definitely は通常、would の後に置くと自然です。意味は「次の旅行先は間違いなくパリです」。 |
| explore | This time, I would like to visit Le Marais… | This time, I’d like to explore Le Marais… | explore は「その場所を歩き回って見て回る」というニュアンス。「観光して回る」にぴったりです。 |
| experience | I’d especially like to experience Original recipe galettes and crepes… | I’d especially like to experience traditional galettes and crêpes… | experience の使い方はとても良いです。ただし、食べ物には original recipe より traditional(伝統的な)のほうが自然です。 |
| memorable | My trip to Paris was wonderful and very memorable. | My trip to Paris was wonderful and very memorable. | これは修正不要です。memorable を自然に使えています。「思い出に残る」という意味をしっかり使えています。 |
| scenery | (まだ自分の英文では使用していません) | I’d like to enjoy the beautiful scenery along the Seine. | 今日の会話では scenery をまだ自分から使えていません。scenery は「自然・街などの全体的な景色」という意味で、旅行会話で非常に便利です。 |
今日のポイント
特に良かったのは、experience と memorable です。
I’d especially like to experience traditional galettes and crêpes.
My trip to Paris was wonderful and very memorable.
この2つは、実際の旅行について話すときにそのまま使える表現です。
一方、次回は scenery / spectacular / accommodation / recommend など、まだ会話で十分に使えていない単語を意識して使ってみるとよいでしょう。
この流れにすることです。
8-3 : リスニング
英語のリスニング力を高めるためのトレーニング法には、レベルに応じてさまざまなものがありますが、
その代表的なものは、発音練習 (Pronunciation)、音読(Read Aloud)、リピーティング (Repeating)、オーバーラッピング (Overlapping)、シャドーイング (Shadowing)、ディクテーション (Dictation)の6つです各トレーニング法を比較すると、下表のようにまとめることができます。
| トレーニング手法 | 主な目的・効果 | 意識の置き所 | 難易度 | おすすめの学習順序 |
| 1. 発音練習 (Pronunciation) | 音の出し方・音の変化(リンキング・脱落)を脳に記憶させる | 口の形・舌の位置・音の変化 | ★☆☆(基礎) | Step 1(一番最初) |
| 2. 音読 (Read Aloud) | 英文の構造・意味を英語の語順のまま理解する(返り読み防止) | 意味のカタマリ(意味理解) | ★★☆(初級) | Step 2 |
| 3. リピーティング (Repeating) | 音声の一時保持(リテンション能力)と正しい発音・リズムの再現 | 音の記憶と再現 | ★★☆(初級〜中級) | Step 3 |
| 4. オーバーラッピング (Overlapping) | ネイティブと同じスピード・リズム・イントネーションの体得 | 音声とのシンクロ(ズレの補正) | ★★★(中級) | Step 4 |
| 5. シャドーイング (Shadowing) | 音声知覚の自動化(音を聞き取る脳の負荷を極限まで減らす) | 音の聞き取りと追従 | ★★★★(中・上級) | Step 5 |
| 6. ディクテーション (Dictation) | 聞き取れない「弱点(音の変化・単語)」の精密な炙り出し | 1音1句の正確性 | ★★★☆(中・上級) | 弱点発見用(随時) |
(1) 発音練習 (Pronunciation) — 【土台づくり】
- やり方: 単個の音(RとL、THなど)の口の形や、単語同士がくっつく「音の変化(リンキング・脱落など)」のルールを学び、正しく発音する練習です。
- リスニングへの効果: 「自分の口で発音できる音」=「耳で聞き取れる音」になります。音の変化のルールを知ることで、知っている単語が聞き取れない現象を防止します。
(2) 音読 (Read Aloud) — 【意味理解の高速化】
- やり方: スクリプト(英文)を目で追いながら、声を出し、意味や文構造を意識して読み上げます。
- リスニングへの効果: 英語を「返り読み(日本語の語順に訳すこと)」せず、頭から順に英語のまま理解する回路を作ります。
音読用の英文スクリプトをChatGPTやGeminiに作ってもらいます。プロンプトは、次のとおり。
音読に適したCEFR B1レベルの英文スクリプトを100字程度で作ってください。文中に、音読用の区切りマークを入れてください。英文の後に、日本語訳もつけてください。
音読しやすいように、CEFR B1レベル・約100語で、意味のまとまりごとに 「/」 を入れます。
音読用英文
Last summer, / I traveled to Paris with my wife / and stayed there for five days. / We explored the city on foot / and visited several famous places. / My favorite experience was walking along the Seine / in the evening. / The scenery was beautiful, / and the streets were full of people enjoying the warm weather. / We also tried some local food / at small restaurants. / The trip was very memorable, / and I would definitely like to visit Paris again someday.
日本語訳
昨年の夏、/ 私は妻と一緒にパリを旅行し、/ 5日間滞在しました。/ 私たちは街を徒歩で観光し、/ いくつかの有名な場所を訪れました。/ 私が最も気に入った体験は、/ 夕方にセーヌ川沿いを歩いたことです。/ 景色は美しく、/ 通りは暖かい天気を楽しむ人々でいっぱいでした。/ また、小さなレストランで/ 地元の料理も食べました。/ とても思い出に残る旅行で、/ いつかぜひまたパリを訪れたいと思います。
音読のポイント: / では一度軽く息を入れ、意味のまとまりごとに滑らかに読むと、英語らしいリズムを作りやすくなります。
(3) リピーティング (Repeating) — 【音の保持力アップ】
- やり方: 音声を1文(または意味の区切り)ごとに一時停止し、テキストを見ずに聞いた通りにそのまま発声します。
- リスニングへの効果: 聞いた音声を頭の中に一時的に留めておく能力(リテンション力)が鍛えられ、長文を聞いたときに「途中で内容を忘れてしまう」のを防ぎます。
リピーティングに適した英文スクリプトをGeminiに生成してもらいました。プロンプトは次のとおり。
英語のリピーティング (Repeating)に適した100字程度のスクリプトを作成して。日本語訳をつけて、
回答:
英語のリピーティング(音声を聞いたあとに一時停止し、テキストを見ずにそのまま真似して発声する練習)に適したスクリプトを作成しました。リピーティングで大切な「意味のカタマリ(意味論的ユニット)」ごとに自然なポーズが入るよう、スラッシュ( / )で区切っています。
英語スクリプト(全97文字)
Artificial intelligence is changing the way we learn foreign languages. / It can answer our questions, / correct our grammar instantly, / and help us practice speaking anytime. / With AI, / language learning has become more accessible and interactive for everyone.
スラッシュごとの日本語訳
- Artificial intelligence is changing the way we learn foreign languages.(人工知能は、私たちが外国語を学ぶ方法を変えつつあります。)
- It can answer our questions,(AIは私たちの質問に答えることができ、)
- correct our grammar instantly,(文法を即座に修正し、)
- and help us practice speaking anytime.(いつでもスピーキングの練習をする手助けをしてくれます。)
- With AI,(AIを活用することで、)
- language learning has become more accessible and interactive for everyone.(言語学習は誰にとってもより身近で、双方向的なものになっています。)
💡 リピーティング練習のコツ
- スラッシュ(
/)の位置で音声を一度止めます。 - 英文は見ずに、耳で聞いた音とリズム・イントネーションをそのまま再現して発音してください。
- 一度に覚えるのが難しい場合は、スラッシュの区切りをさらに細かく(短く)して試してみましょう。
英文スクリプトを英語で読み上げることのできる音読アプリには、ElevenLabsやNaturalReaderなどがあります。このうち、安価な料金プランで、生成した音声をMP3ファイルにダウンロードできるのはElevenLabsです。以下では、ElevenLabsを使って英文スクリプトを英語で読み上げ、これをもとにリピーティングする練習をしてみたいと思います。上のスラッシュ入りスクリプトをElevenLabsに読み上げてもらうと、下のような音声が生成されます。ちゃんと、スラッシュの位置で間をおいた音声で生成してくれますので、リピーティングの練習には最適です。
(4) オーバーラッピング (Overlapping) — 【スピードとリズムの同期】
- やり方: テキストを見ながら、流れてくるお手本音声と完全に「同時に」重なるように音読します。
- リスニングへの効果: ネイティブのスピード、強弱(アクセント)、イントネーションに口と耳を慣れさせます。ついていけない箇所は、自分が発音できていない(または認識できていない)部分です。
プロンプト:
英語のオーバーラッピング (Overlapping) の練習に最適な英文スクリプトを生成してください。
Geminiの回答:
オーバーラッピング(音声を聞きながら同時に英文を音読する練習)に最適なスクリプトを作成しました。
自然な会話のスピード(1秒あたり2.5〜3語程度)に合わせやすく、音声変化(リンキングやリダクション)を体感しやすい約60語の英文です。
スクリプト:日常会話・ビジネス(同僚とのやり取り)
“Hey, do you have a minute? I wanted to ask about the report for tomorrow’s meeting. I’ve almost finished my part, but I’m not sure where to put the sales data. Could you take a look at it when you’re free? Let me know what you think.”
オーバーラッピングのポイント(音声変化の意識)
ネイティブの発音にスムーズに音を重ねるため、以下の音の繋がり(リンキング)と脱落(リダクション)を意識して音読してください。
have a→ 「ハヴァ」- 単語が繋がって1つの音のようになります。
wanted to→ 「ウォニッドゥ」 または 「ウォンテッドゥ」t音が弱化または省略されやすくなります。
ask about the→ 「アスカバウッダ」askのkとaboutのaが結合します。
take a look at it→ 「テイカルッカティッ(ト)」- 全体がスムーズに1つの流れで発音されます。最後の
tは破裂させず口の形だけで止めます。
- 全体がスムーズに1つの流れで発音されます。最後の
Let me→ 「レミ」tの音が消え、より速く自然な発音になります。
おすすめの練習ステップ
- スクリプトの確認(目読):意味と英文構造を100%理解する。
- 音声の確認(リスニング):音の繋がりや強弱のメリハリを意識して聴く。
- 音読(リピーティング):音声のあとに続いて発音し、口を慣らす。
- オーバーラッピング(実践):音声を流しながら、ピッタリ重なる速度で音読する(3〜5回繰り返し)。
再び、ElevenLabsで音声読み上げし、ダウンロードしました。
(5) シャドーイング (Shadowing) — 【リスニング力の最重要メソッド】
- やり方: テキストを見ずに、聞こえてくる音声から0.5秒〜1秒ほど遅れて影(Shadow)のように追いかけて発声します。
- リスニングへの効果: 脳のリソースを「音の聞き取り(音声知覚)」から「意味の理解」へシフトさせます。音声知覚が自動化されるため、速い英語でも楽に意味が頭に入ってくるようになります。
プロンプト:
英語のシャドーイング (Shadowing) の練習に最適な英文スクリプトを生成してください。
Geminiの回答:
シャドーイング(音声から1〜2語遅れて影のように追いかけて発声する練習)に最適な英文スクリプトです。
文字を見ずに耳だけに集中して発音・イントネーション・リズムを再現できるよう、文構造がシンプルでリズムのつきやすい約70語の英文を作成しました。
スクリプト:プレゼンテーションの導入
“Good morning, everyone. Thanks for being here today. Today, I’d like to share our new strategy for improving customer satisfaction. Over the past few months, we’ve gathered feedback from hundreds of clients. The results show that speed and clear communication are what matter most. So, let’s walk through three simple steps to deliver a better experience for our customers.”
意味(参考)
「皆さん、おはようございます。本日お集まりいただきありがとうございます。本日は、顧客満足度を向上させるための新しい戦略についてお話ししたいと思います。過去数ヶ月間、私たちは何百人ものお客様からフィードバックを集めました。その結果、スピードと明確なコミュニケーションが最も重要であることが分かりました。それでは、より良い顧客体験を提供するための3つのシンプルなステップを見ていきましょう。」
シャドーイングで意識する3つのポイント
- 強弱のメリハリ(ストレス)
- 意味を持つ重要な単語(
strategy,improving,satisfaction,hundreds,speedなど)を強く・長く発音し、代名詞や前置詞(for,our,of,to)は短く弱く発音します。
- 意味を持つ重要な単語(
- 音の繋がり(リンキング)
Thanks for being here today→ 「サンクス フォー ビーン ヒア トゥデイ」では滑らかに繋げるwhat matter most→ 「ワッ マター モウスト」walk through→ 「ウォーク スルー」
- スピードではなく「リズム」を合わせる
- ネイティブの音声を追いかける際、声の高さ(インフォネーション)と息の区切り(ポーズ)のタイミングを完璧に模倣することを目指します。
シャドーイングの基本ステップ
- マンブリング(ブツブツ音読):まずはテキストを見ずに、聞き取れた音だけを小さく呟いて口を慣らす。
- テキストチェック:英文と意味を確認し、音と意味を一致させる。
- アカペラ・シャドーイング:音声を止め、自分でスムーズに発声できるかチェックする。
- ガチ・シャドーイング:テキストを見ずに、音声だけを聴きながら1〜2語遅れてしっかり発声する(5回以上繰り返し)。
いつものように、スクリプトをElevenLabsで音声に変換します。
(6) ディクテーション (Dictation) — 【弱点の可視化】
- やり方: 聞こえてくる英語を1言1句書き出します(書き取り)。
- リスニングへの効果: 自分が「どこを聞き逃しているのか(冠詞、前置詞、語尾のs、音の脱落など)」が明確なデータとして浮き彫りになります。
プロンプト:
英語のディクテーション (Dictation) の練習に最適なスクリプトを生成してください。
Geminiの回答:
ディクテーション(聞き取った音声を一字一句正確に書き取る練習)に最適なスクリプトを作成しました。
ディクテーションは「冠詞(a/the)」「機能語(in/on/at)」「単複の-s」「過去形の-ed」などの聞き取り漏れに気づくことが最大の目的です。細かいスペルミスや聞き逃しが発生しやすい、約50語の短い英文を用意しました。
ディクテーション練習用スクリプト
“If you’re planning a trip to London this autumn, don’t forget to pack a warm jacket. The weather changes quickly, and it often rains in the afternoon. However, walking around the city is still one of the best ways to explore its historical places and famous coffee shops.”
正確に書き取るための見落とし注意ポイント
書き取ったあとに答え合わせをする際、以下のポイントを特にチェックしてください。
- 冠詞や所有格(
a/the/its)a trip,a warm jacket: 短く弱く発音されるため聞き逃しやすい部分です。its historical places:it's(it is)とits(所有格)の聞き分けに注意。
- 単数形・複数形の
-schanges,rains,ways,places,shops: 語尾の-sや-esが正しく聞き取れているか確認します。
- 音の連結(リンキング)
planning a→ 「プラニンガ」rains in→ 「レインジン」one of the→ 「ワンノブダ」
おすすめのディクテーション手順
- 全体を聴く(1回目):音声を止めずに流し、大まかな内容や全体の流れを把握する。
- 書き取る(2〜4回目):一文ごと、または意味の切れ目(カンマなど)で音声を一時停止しながら書き出す。
- 推敲する(最終チェック):文法的に「冠詞や三単現の-sが抜けていないか」を見直す。
- 答え合わせ(スクリプト確認):赤ペンで答え合わせをし、自分が「聞こえなかった音」や「勘違いした音」を特定する。
英文スクリプトをElevenLabsで音声に変換しました。
8-4 : ロールプレイング
英語のスピーキング力を高めるには、生成AI英会話アプリ(ChatGPTの音声モード、Elsa Speak、Speakなどの英会話AI)を使ってスピーキング練習を繰り返すのが最も効果的です。対面のレッスンに比べて「間違えても恥ずかしくない」「いつでも即座に練習できる」という圧倒的なメリットがあります。
生成AI英会話アプリ(ChatGPTの音声モード、Elsa Speak、Plaud、Speakなどの英会話AI)を使ったスピーキング練習は、「間違えても恥ずかしくない」「いつでも即座に練習できる」という圧倒的なメリットがあります。
一方で、ただダラダラおしゃべりするだけでは上達が伸び悩みがちです。AIの特性をフル活用してスピーキング力を最短で伸ばすためにいちばん実用的で効果的なのは、具体的な場面(シチュエーション)と話者の役割を指定する「ロールプレイング」方式で、AIとの間で役割を決めて英会話を練習してみましょう(プロンプトでは、AIは「あなた」、あなたは「私」として、役割を宣言します)。旅行中よく遭遇する場面としては、「カフェで注文する」「ホテルでチェックインする」「ホテルの部屋について苦情を言う」「道に迷った時に尋ねる」「空港での入国審査を受ける」「飛行機の機内で食事を頼む」「列車の切符を買う」「タクシーに乗る」 「警察で被害届を出す」「初対面相手と挨拶を交わす」「観光地で知り合った人と会話する」「ホームステイ先の家族に挨拶する」「京都の名所で外国人を案内する」「レストランで料理を注文する」「デパートやお土産店でショッピングする」「病院で診察を受ける」「路上でケガをして助けを求める」「レンタカーを契約する」などが考えられます。同じプロンプトでも、英会話アプリによって、会話の流れが異なりますので、ChatGPT、Gemini、Speakの3つを比較したいと思います(タブを切り替えて比較してください)。
ここでは、シチュエーションや役割、会話目標(テーマ)を設定した「ロールプレイイング」を練習しますが、特に場面、テーマ、目標、役割を設定しない「自由英会話(単なるおしゃべり)」をAIアプリで楽しむことも可能ですし、英会話に慣れるという意味では有効です。そのためのプロンプトとしては、次のような出だしが考えられます。
これからあなた(AI)と英語でおしゃべりを楽しみたいと思います。特にテーマや役割はありませんので、あなたの方から英会話を始めてください。
1. カフェで注文する
1-1 : プロンプト
(1) シチュエーションの設定
・私は今、パリの「ドゥー・マゴ」というカフェのテラス席にいます。
・私は今、マンハッタンのコーヒーショップの窓際の席に座っています。
・私は今、東京六本木の「アマンド」というカフェに来ました。
・旅行でパリに着いてまもない時期で、しばらく休憩をとりながら、ガイドブックを読もうと思ってカフェに入りました。
(2) 話者の役割設定
・あなたは、カフェのバリスタ、私は常連のお客です。
・あなたは、カフェの店員、私は観光客です。
(3) 会話目標の設定
・カフェラテのMサイズを注文する。
・シロップ入りのパンケーキを温めてもらう。
・ブルーベリー入りのマッフィンを注文する。
(4) 会話の開始
・Let’s start conversation in English from you.
・英語で会話しましょう。あなたから、どうぞ。
(5) 会話のルールの設定
・会話は原則として英語で行ってください。「日本語で」とリクエストした場合は、日本語と英語を交えた説明をしてください。
・私が「会話はじめ」と言ったら、ロールプレイを開始してください。
・あなたから会話を始めてください。
・私が英語で話したら、実際の会話のように自然に返答してください。
・会話中は私の英語を訂正しないでください。
・私が短い英文を使った場合は、必要に応じて質問をして会話を続けてください。
・私の英語が多少不自然でも、意味を推測して会話を続けてください。
・会話は私が「会話終わり」と言うまで続けてください。
(6) 会話の復習をするときのプロンプト
私が「会話終わり」と言ったら、次の形式で英語を復習してください。
① 私の英文を添削
② より自然な英文に直す
③ 簡単な日本語の解説を加える。
④ 会話でよく使う表現を教えてください。
(7) 会話によく出るフレーズ
カフェで注文する際によく使われる定番の英語・日本語フレーズを10個ご紹介します。
- Hi, how are you? / こんにちは!
- 店員と最初に交わす軽い挨拶です。
- What can I get for you today? / 本日は何になさいますか?
- 店員から注文を聞かれる際のお決まりのフレーズです。
- Can I get a [Latte], please? / [ラテ]をひとつお願いします。
- 注文する際の最もシンプルで自然な言い方です。
- I’ll have a [Capuccino]. / [カプチーノ]にします。
- こちらも自分の注文を伝える際によく使われます。
- What size would you like? / サイズはいかがなさいますか?
- ドリンクのサイズを選んでいない場合に聞かれます。
- Small / Medium / Large, please. / [S / M / L] サイズでお願いします。
- 指定したいサイズを答えるときに使います。
- For here or to go? / 店内でお召し上がりですか、お持ち帰りですか?
- アメリカなどでよく使われるイートインかテイクアウトかの確認です。(イギリスなどでは “Eat in or take away?” とも言われます)
- To go, please. / テイクアウトでお願いします。
- お持ち帰り希望の際の答え方です。(店内の場合は “For here, please.”)
- Would you like anything else? / 他にご注文はございますか?
- フードなどの追加注文がないか確認されるフレーズです。
- That’ll be [5 dollars]. / お会計は[5ドル]になります。
- 合計金額を案内される際の定型句です。
(8) 言い換え(パラフレーズ)の指示
会話の途中で単語が出てこなくなっても、日本語に頼ったり会話を止めたりせず、知っている簡単な英語で説明する練習をしましょう。これこそがスピーキングの流暢さを育てる一番のポイントです。
- 単語がわからない時:
"How can I say [知りたいこと] in English?" - 意味を確認したい時:
"What do you mean by [意味のわからない単語やフレーズ]?"
(9) フィードバック依頼のプロンプト
フィードバック依頼のフレーズ例
- “Could you give me feedback on my English during this chat? Please point out any grammatical errors and suggest more natural expressions.”
(今の会話の私の英語についてフィードバックをくれる?文法エラーの指摘と、より自然な表現を提案して。)
2. “Could you check my pronunciation in our conversation just now?” (今の会話での私の英語の発音をチェックして。)
1:2 AIアプリによるロールプレイ英会話の実例
2. ホテルでチェックインする
2-1 : プロンプトに含めるフレーズ
(1) シチュエーションの設定
・私は今、ホテルにチェックインしようとしています。
・私は、パリのホテル・サンジェルマンに着いたところです。
・わたしはいま、ホテルのフロントデスクにいます。
・私は今、ヒルトン・ホテルのロビーにいて、これからチェックインします。
(2) 話者の役割設定
・あなたは、ホテルのフロントデスク係員、私は宿泊客です。
・あなたはホテルの従業員、私は到着した客です。
(3) 会話目標の設定
・チェックインの手続きをする。
・部屋番号を聞く。
・チェックアウトの時刻を聞く。
・滞在日数を知らせる。
・食堂の場所と営業時間を聞く。
・近くでおすすめのレストランを聞く。
(4) 会話の開始
・Let’s start conversation in English from you.
・英語で会話しましょう。あなたから、どうぞ。
(5) 会話によく出るフレーズ
ホテルのチェックイン時によく使われる英会話フレーズと、その日本語訳・ニュアンスの10選です。
- Hi, I’d like to check in, please.
(こんにちは、チェックインをお願いします。)
フロント到着時の定番の第一声です。 - I have a reservation under [Name].
([名前]で予約しています。)
名前を伝える際のスムーズな言い回しです。 - May I have your passport and credit card, please?
(パスポートとクレジットカードをご提示いただけますか?)
スタッフ側から身元確認やデポジット(保証金)のために必ず聞かれるフレーズです。 - Could you fill out this form, please?
(こちらの用紙にご記入いただけますか?)
宿泊名簿(宿帳)への記入を促される際によく使われます。 - Could I get one more room key, please?
(部屋の鍵をもう1ついただけますか?)
同行者がいる場合などに、カードキーを複数枚もらいたい時に使えます。 - What time is breakfast served?
(朝食は何時からですか?)
朝食の利用時間や場所を確認したい時の定番フレーズです。 - What time is check-out?
(チェックアウトは何時ですか?)
退室時間を確認したい時に使います。 - Where is the elevator / breakfast venue?
(エレベーター/朝食会場はどこですか?)
館内施設への行き方を尋ねる際に役立ちます。 - Could I leave my luggage here before check-in / after check-out?
(チェックイン前/チェックアウト後に荷物を預けられますか?)
観光や移動の前に荷物を預けたい時の必須フレーズです。 - Here is your keycard. Your room is 502 on the 5th floor.
(こちらがルームキーです。お部屋は5階の502号室です。)
手続き完了時にスタッフからルームキーを受け取る際のアナウンスです。
2-2 : AIアプリによるロールプレイ英会話の実例
3. ホテルの部屋について苦情を言う
3-1 : プロンプトに含めるフレーズ
(1) シチュエーションの設定
・私は今、ホテルの部屋にいます。
・私が泊まっているホテルの部屋のエアコンが故障しています。
・バスルームの水が出ません。
・頼んでおいた部屋の清掃ができていません。
・私は、ホテルの部屋からフロント(フロントデスク)へ電話で苦情や不具合を伝えようとしています。
(2) 話者の役割設定
・You are a hotel front desk receptionist, and I am a guest calling the front desk from my room.
・あなたはホテルのフロント受付、私はホテルの部屋からフロントに電話している宿泊客です。
(3) 会話目標の設定
・すぐにエアコンの故障を直してもらう。
・すぐに部屋の清掃をしてもらう。
・バスルームの水がすぐに使えるようにしてもらう。
(4) 会話の開始
・Let’s start conversation in English from you. You answers to the call.
・英語で会話しましょう。あなたから、電話を受けてください。
(5) 会話によく出るフレーズ
海外のホテルの部屋からフロント(フロントデスク)へ電話で苦情や不具合を伝える際、スムーズかつ丁寧に状況を説明できる英会話フレーズと日本語訳です。
- Hi, I’m calling from room [302]. / こんにちは、[302号室]から電話しています。
- 用件に入る前に、自分の部屋番号を伝える最初の挨拶です。
- I’m sorry to bother you, but there seems to be a problem with [the AC]. / お手数をおかけしてすみませんが、[エアコン]の具合が良くないようです。
- 切り出しとして非常に使いやすい、丁寧でカドが立たない表現です。
- The hot water isn’t working in my room. / 部屋のお湯が出ません。
- シャワーや洗面台でお湯が出ないときの直接的な伝え方です。
- The room next door is very noisy. Could you please check on it? / 隣の部屋がとてもうるさいです。確認していただけますか?
- 隣室の騒音についてフロントに対処をお願いするフレーズです。
- There are no clean towels in my bathroom. / バスルームに清潔なタオルがありません。
- 備品が足りない・用意されていない場合に伝えられます。
- The Wi-Fi signal in my room is extremely weak. / 部屋のWi-Fiの電波がとても弱いです。
- ネットワーク接続に関する不具合を伝える際に使います。
- Could you send someone up to check it? / 誰か見に来て(確認しに来て)いただけますか?
- 設備トラブル(テレビ、エアコン、鍵など)の点検を依頼する表現です。
- I ordered room service an hour ago, but it hasn’t arrived yet. / 1時間前にルームサービスを頼んだのですが、まだ届きません。
- 注文した料理が来ない場合の催促フレーズです。
- The toilet won’t flush. / トイレの水が流れません。
- 水回りのトラブルで緊急を要する際によく使われます。
- Is it possible to change rooms? / 部屋を変更していただくことは可能ですか?
- 騒音や部屋の不具合が解決しない場合、部屋交換を打診するときに使います。
3-2 : AIアプリによるロールプレイ英会話の実例
4. 道に迷った時に尋ねる
4-1 : プロンプトに含めるフレーズ
(1) シチュエーションの設定
・私は東京から来た日本人旅行者で、いまロンドンの中心街を歩いています。「ピカデリー・サーカス」に行きたいのですが、道がわかりません。
・私は観光で東京を訪問中のアメリカ人です。いま、青山通りの表参道駅前にいますが、これから明治神宮まで行く道順がわかりません。
(2) 話者の役割設定
・I am a traveler who is lost and in trouble abroad.
・You are a kind local passing by.
・私は、海外で道に迷って困っている旅行者です。
・あなたは、通りがかった親切な現地の人です。
(3) 会話目標の設定
・ロンドンのピカデリー・サーカスまでの道順を知りたい。
・表参道から明治神宮までの道順を知りたい。
(4) 会話の開始
・I will play the role of a lost traveler in a foreign country, and you (AI) will play a friendly local who happens to be passing by. I will start the conversation by saying ‘Excuse me, I’m lost…’, so please begin by replying to that.
・私は外国で道に迷って困っている旅行者です。あなた (AI) は通りがかった親切な現地の人を演じてください。私は、あなたに話しかけます。まずは、私からExcuse me, I’m lost… などと声をかけますから、あなたはそれに答えてください。
(5) 会話によく出るフレーズ
海外で道に迷った際に役立つ英会話フレーズと、その返答例(日本語訳付き)をまとめました。
1. 現在地を確認したいとき
- 質問
- Excuse me, where am I on this map?
- (すいません、この地図上で私は今どこにいますか?)
- 解答例
- You are right here, near the station.
- (今ここにいますよ、駅の近くです。)
2. 特定の場所への行き方を聞きたいとき
- 質問
- Could you tell me how to get to the museum?
- (美術館への行き方を教えていただけますか?)
- 解答例
- Go straight for two blocks and turn left.
- (2ブロック真っ直ぐ進んで、左に曲がってください。)
3. 場所の有無を尋ねるとき
- 質問
- Is there a subway station around here?
- (この近くに地下鉄の駅はありますか?)
- 解答例
- Yes, there is one just around the corner.
- (はい、角を曲がったところにありますよ。)
4. 迷子になっていることを直接伝えるとき
- 質問
- I’m lost. I’m looking for the Hilton Hotel.
- (道に迷ってしまいました。ヒルトンホテルを探しているのですが。)
- 解答例
- It’s across from the shopping mall over there.
- (あそこに見えるショッピングモールの向かい側にあります。)
5. 目印となる建物を尋ねるとき
- 質問
- What is the best landmark to look for?
- (目印になる一番わかりやすい建物は何ですか?)
- 解答例
- Look for a big red building next to the bank.
- (銀行の隣にある大きな赤い建物 الاع印にしてください。)
6. 最寄りのバス停やタクシー乗り場を聞くとき
- 質問
- Where is the nearest bus stop?
- (一番近いバス停はどこですか?)
7. 地図に目的地を描き込んでもらいたいとき
- 質問
- Could you draw a quick map for me on this paper?
- (この紙に簡単な地図を描いてもらえますか?)
- 解答例
- Sure, let me show you. You are here, and the shop is here.
- (いいですよ、説明しますね。あなたが今ここ、お店がここです。)
4-2 : AIアプリによるロールプレイ英会話の実例
5. 空港での入国審査を受ける
5-1 : プロンプトに含めるフレーズ
(1) シチュエーションの設定
・I’m at the airport immigration counter right now, about to go through immigration.
・私は今、空港の入国審査場にいて、入国審査を受けるところです。
(2) 話者の役割設定
・You are the immigration officer, and I’m the traveler.
・あなたは、入国審査(Immigration)の審査官 (Officer)、私は旅行者 (traveler)です。
(3) 会話目標の設定
・入国審査を受ける
・入国の目的を聞く。
・パスポートをチェックする。
・滞在期間を聞く。
(4) 会話の開始
・Let’s start conversation in English from you.
・では会話を始めましょう。あなたから、英語で話してください。
(5) 会話によく出るフレーズ
空港の入国審査(Immigration)で交わされる代表的なやり取りを7パターンまとめました。
1. 入国目的を聞く(Purpose of visit)
- Officer: What is the purpose of your visit?
(入国の目的は何ですか?) - Traveler: I’m here for sightseeing.
(観光で来ました。)
2. 滞在期間を聞く(Length of stay)
- Officer: How long are you going to stay in the country?
(この国にはどのくらい滞在する予定ですか?) - Traveler: I’ll be staying for five days.
(5日間滞在します。)
3. 滞在先を聞く(Accommodation)
- Officer: Where will you be staying?
(どこに滞在しますか?) - Traveler: At the Hilton Hotel in downtown. Here is my hotel booking confirmation.
(ダウンタウンのヒルトンホテルです。これがホテルの予約確認書です。)
4. 帰りのチケットを確認する(Return ticket)
- Officer: Do you have a return ticket to your home country?
(母国への帰りのチケットはお持ちですか?) - Traveler: Yes, here is my return ticket for September 30th.
(はい、これが9月30日の帰国用チケットです。)
5. 職業を聞く(Occupation)
- Officer: What do you do for a living?
(ご職業は何ですか?) - Traveler: I’m an engineer for a software company.
(ソフトウェア会社のエンジニアです。)
5-2 : AIアプリによるロールプレイ英会話の実例
6. 飛行機の機内で食事を頼む
6-1 : プロンプトに含めるフレーズ
(1) シチュエーションの設定
・飛行機が離陸してから2時間になります。そろそろお腹が減ってきました。機内食を注文します。
・私は今、飛行機の機内で食事を待っているところです。
・客室乗務員が食事を持ってきました。
・A flight attendant brought the meal for us.
(2) 話者の役割設定
・あなたは、航空機の客室乗務員、私はエコノミークラスの乗客です。
・あなたはフライト・アテンダント、私はファーストクラスの乗客です。
(3) 会話目標の設定
・機内食を乗客に提供する。
・客室乗務員に飲み物を頼む
・客室乗務員に食事を下げてもらう。
(4) 会話の開始
・Let’s start conversation in English from you.
・英語で会話しましょう。あなたから、どうぞ。
(5) 会話によく出るフレーズ
機内で客室乗務員(Flight Attendant)と乗客(Passenger)の間でよく使われる英会話フレーズを10個ご紹介します!旅行や出張の際にとても役立つ定番の表現です。
乗客から客室乗務員へ(よく使うリクエストなど)
- Could I have some water, please?(お水をいただけますか?)
- ※ water を tea, coffee, blanket(毛布)に変えてそのまま使えます。
- Excuse me, where is the lavatory?(すみません、お手洗いはどこですか?)
- ※「トイレ」は機内では lavatory や restroom と言うのが一般的です。
- Could you help me put my bag in the overhead bin?(バッグを上の棚に入れるのを手伝っていただけますか?)
- ※ overhead bin=頭上の収納棚
- My screen isn’t working. Could you check it?(モニターが動かないのですが、確認していただけますか?)
- ※機内エンタメの画面や読書灯などが壊れている時に使えます。
- I ordered a special meal in advance.(事前にお手配した特別食(ベジタリアン食など)をお願いしています。)
客室乗務員から乗客へ(聞かれること・案内)
- Would you like chicken or beef?(チキンとお肉(ビーフ)、どちらになさいますか?)
- ※機内食を聞かれる時の超定番フレーズです。「Chicken, please.」のように答えます。
- Would you like anything to drink?(何かお飲み物はいかがですか?)
- ※「Apple juice, please.」や「Just water, please.」などと答えます。
- Please fasten your seatbelt and upright your seat back.(シートベルトをお締めになり、座席の背もたれをお戻しください。)
- ※離着陸時や揺れ(揺れる=turbulence)の際によくアナウンス・案内されます。
- Are you finished with your plate?(お皿はお下げしてもよろしいですか?)
- ※食事が終わったタイミングで聞きに来てくれます。「Yes, thank you.」と答えればOKです。
- Please make sure your phone is in airplane mode.(スマートフォンが機内モードになっているかご確認ください。)
もし気になった表現や、もっと詳しく知りたいシチュエーション(入国カードの書き方を聞きたい時など)があれば、いつでも言ってくださいね!
6-2 : AIアプリによるロールプレイ英会話の実例
7. 列車の切符を買う
7-1 : プロンプトに含めるフレーズ
(1) シチュエーションの設定
・私は今、駅につきました。これから、窓口で切符を買おうとしています。
・私は今、列車に乗っています。まわって来た駅員から切符を買おうとしています。
(2) 話者の役割設定
・あなたは、窓口の駅員です。
・私は、これから列車では旅行する観光客です。
・あなたは、列車内で切符を売っている駅員です。
・あなたは、列車内で切符を買おうとしている乗客です。
(3) 会話目標の設定
・今から乗る列車の出発時刻を知りたい。
・列車の切符を買う。
・目的地の駅名を確認する。
・目的地の到着時刻を知る。
・乗車料金を尋ねる。
・料金の支払い方法を告げる。
・片道か、往復かを告げる。
・座席の等級、指定席か自由席かを決める。
・乗車ホームを尋ねる。
(4) 会話の開始
・Let’s start conversation in English from you.
・英語で会話しましょう。あなたから、どうぞ。
(5) 会話によく出るフレーズ
駅のチケット窓口(Ticket Office / Ticket Counter)で、切符を買うときによく使われる英会話フレーズを10個ご紹介します。
乗客から駅員へ(切符を買う・質問する)
- I’d like a ticket to London, please.(ロンドン行きの切符を1枚お願いします。)
- ※「I’d like a ticket to [目的地]」は一番シンプルで確実な基本フレーズです。
- One-way or round-trip? に対する返答:A round-trip ticket, please. / A one-way ticket, please.(往復切符をお願いします。 / 片道切符をお願いします。)
- ※イギリス英語では往復を return、片道を single と言うことも多いです。
- Does this train go directly to Tokyo?(この列車は東京まで直通で行きますか?)
- ※乗り換え(transfer)が必要かどうかを確認したいときに便利です。
- Is there a discount for students or children?(学割や子供料金の割引はありますか?)
- ※シニア割(senior discount)などを尋ねるときにも使えます。
- Could I have a window seat, please?(窓側の席にしていただけますか?)
- ※通路側が良い場合は an aisle seat(アイル・シート)と言います。
- What time is the next train?(次の列車は何時ですか?)
駅員から乗客へ(よく聞かれること・案内)
- Where are you traveling to today?(今日はどちらまで行かれますか?/どちらまでの切符ですか?)
- First class or standard class?(一等車になさいますか、それとも普通車(二等車)ですか?)
- ※アメリカでは standard の代わりに coach と言うこともあります。
- That will be 35 dollars. How would you like to pay?(合計で35ドルになります。お支払い方法はいかがなさいますか?)
- ※「By credit card, please.(クレジットカードで)」のように答えます。
- Your train leaves from Platform 4 at 10:15.(ご乗車になる列車は、4番ホームから10時15分に出発します。)
7-2 : AIアプリによるロールプレイ英会話の実例
8. タクシーに乗る
8-1 : プロンプトに含めるフレーズ
(1) シチュエーションの設定
・私はいま駅前にいて、タクシーに乗ろうとしています。
・私はいま、タクシーの中で、運転手と話しています。
・私はいま、タクシーに乗っていて、運転手に行き先(名前、住所、目印など)を告げています。
・私はいま、タクシーに乗っていて、運転手におすすめの観光名所について聞いています。
・あなたはいま、タクシー降りようとしています。運転手に料金を払うところです。
(2) 話者の役割設定
・あなたは、タクシーの運転手、私は乗客です。
(3) 会話目標の設定
・乗客が行き先を告げる
・乗客が行き先の名前、住所、目印を教える。
・乗客が運転手に、目的地までの所要時間を聞く。
・乗客と運転手がさまざまな話題についておしゃべりする。
・運転手が料金を告げる。
・運転手が乗客におすすめの観光名所について教える。
(4) 会話の開始
・Let’s start conversation in English from you.
・英語で会話しましょう。あなたから、どうぞ。
(5) 会話によく出るフレーズ
タクシー内で運転手(Taxi Driver)と乗客(Passenger)の間でよく使われる英会話フレーズを10個ご紹介します。
乗客から運転手へ(行き先を伝える・お願いする)
- Could you take me to the Hilton Hotel, please?(ヒルトンホテルまでお願いします。)
- ※「Could you take me to [目的地]?」は、行き先を伝える時の最も基本的で丁寧なフレーズです。
- How long will it take to get to the airport?(空港までどれくらい時間がかかりますか?)
- ※所要時間を確認したい時にとても便利です。
- Could you open the trunk, please?(トランクを開けていただけますか?)
- ※スーツケースなどの大きな荷物がある時に使います。
- Please drop me off here. / Could you stop right here?(ここで降ろしてください。 / ここで止めていただけますか?)
- ※目的地やその手前で降りたい時の定番フレーズです。
- Do you accept credit cards?(クレジットカードは使えますか?)
- ※乗車時や支払い時に支払い方法を確認する表現です。
運転手から乗客へ(行き先の確認・支払いなど)
- Where to? / Where are you heading today?(どちらまで行きますか? / どちらへお向かいですか?)
- ※乗り込んだ時に最初に聞かれる超定番のフレーズです。
- Are you in a hurry?(お急ぎですか?)
- ※急いでいる場合は「Yes, a little bit.(はい、少し急いでいます)」のように答えます。
- Which way would you like me to go? Do you have a preferred route?(どの道で行きましょうか? 希望のルートはありますか?)
- ※ルートの希望を聞かれた際、おまかせしたい場合は「The fastest way, please.(一番早い道でお願いします)」と答えればOKです。
- That’ll be 25 dollars.(25ドルになります。)
- ※到着時の料金の案内です。
- Keep the change. (※乗客から運転手への一言)(お釣りはとっておいてください。)
- ※チップ文化のある国(アメリカなど)で、お釣りをチップとして渡したい時に非常によく使われます。
8-2 : AIアプリによるロールプレイ英会話の実例
9. 警察で被害届を出す
9-1 : プロンプトに含めるフレーズ
(1) シチュエーションの設定
・私はいま、旅先で最寄りの警察署に来ています。
・私は旅先にいて、ハンドバッグを紛失してしまいました。
・私は旅先にいて、街角でカード詐欺にあって、多額のお金を取られてしまいました。
・私は旅先にいて、財布をすられてしまいました。
・私は警察署の遺失物受付に来ています。
・私は警察署の被害届窓口に来ています。
(2) 話者の役割設定
・あなたは、警察の担当署員、私は被害にあった観光客です。
・あなたは警察の担当署員、私は所持品を紛失した観光客です。
(3) 会話目標の設定
・遺失物を届ける
・被害届を提出する
・書類に記入する
・紛失した状況を詳しく説明する
・被害の内容を詳しく説明する
・紛失、被害の証明書類を受け取る
(4) 会話の開始
・Let’s start conversation in English from you.
・英語で会話しましょう。あなたから、どうぞ。
(5) 会話によく出るフレーズ
警察署や交番(Police Station / Police Box)で、落とし物(遺失物)の届出や犯罪被害の届出をする際によく使われる英会話フレーズを10個ご紹介します。
【1〜5】届出をする側(被害者・落とし主)が使うフレーズ
- I’d like to report a lost item.(落とし物の届け出をしたいのですが。)
- ※財布なら a lost wallet、パスポートなら a lost passport のように具体的に言うこともできます。
- I think my bag was stolen.(バッグを盗まれたと思います。)
- ※スリや置引きなどの被害を伝える際の基本的な表現です。
- I lost my phone around 3 p.m. near the station.(午後3時ごろ、駅の近くでスマホをなくしました。)
- ※「いつ(When)」「どこで(Where)」をセットで伝えるとスムーズです。
- Could you issue a police report for my insurance?(保険請求のために警察の証明書(届出証明)を発行していただけますか?)
- ※海外旅行保険などを申請する際に必要な「盗難・紛失証明書(Police Report)」を依頼する時に使います。
- It contains my ID, credit cards, and some cash.(中には身分証明書、クレジットカード、現金がいくつか入っています。)
- ※紛失物・盗難品の中身(contents)を説明する際によく使います。
【6〜10】警察官からよく聞かれるフレーズ・やりとり
- Can you describe the item? / What does it look like?(その品物の特徴を教えていただけますか?/どのような見た目ですか?)
- ※色、ブランド、素材などを答えます。(例: “It’s a black leather wallet.”)
- Where and when did you last see it?(最後にそれを見たのは、いつ・どこですか?)
- ※記憶のある最後の場所や時間を聞かれます。
- Can you fill out this form, please?(こちらの用紙に記入していただけますか?)
- ※遺失届や被害届の書類(Lost Property Form / Crime Report Form)への記入を求められます。
- Did you notice anyone suspicious nearby?(近くに不審な人物はいませんでしたか?)
- ※盗難や被害の届出の際によく確認される質問です。
- We will contact you if we find it or have any updates.(発見された場合や進展があった場合はご連絡します。)
- ※手続きの最後に警察官から言われる定番の案内フレーズです。
9-2 : AIアプリによるロールプレイ英会話の実例
10. 初対面の相手と挨拶を交わす
最後に取り上げるAIとの会話事例は、世界各地の観光スポットで偶然出会った人たちとのフリートークです。すでに申し上げたように、AIとのフリートークでは、ただ自由に意味もなく会話していても、会話が深まることは期待できません。なぜなら、一般に会話が弾むとか、深まるためには、AIと会話者との間に、共通の話題(テーマ、シチュエーション、話者のプロフィール、過去の体験、サブジェクト、コンテキストなど)が共有されていなければならないからです。これは、対人コミュニケーションの基本原則です。けれども、これまでに出版された「AI英語教本」では、こうした共通の話題(話想宇宙 : Universe of Discourse)をプロンプトに入れることの重要性を指摘したものものはほとんどなかったように思われます。これでは、AIとあなたのコミュニケーションを豊かで意義深いものにすることは期待できません。
そこで、本節では、AIと会話練習者の双方について、会話で言及される可能性のある情報を「新情報」もしくは「旧情報」として、あらかじめプロンプトに仕込んでおくという、画期的な方法を採用することにしました。これは、既存の会話コミュニケーション理論(会話分析、談話分析)を参考にしたものです。
10-1 : プロンプトに含めるフレーズ
(1) シチュエーションの設定
#会話のシチュエーション
・私はいま、初めて訪れたイタリアのポンペイ遺跡で、現地ツアーに参加しています。
・私は同じツアーで、一緒になった外国人観光客と挨拶を交わします。
・私はこの方(あなた=AI)に写真を撮ってもらい、それがきっかけで、おしゃべりをしました。
(2) 話者のプロフィール、来歴の設定
#私(ユーザー)のプロフィール
・私は南イタリアのポンペイ遺跡ツアーに参加した観光客、あなたはたまたま同じツアーに参加していた外国人観光客です。
・私は、70代の男性。イタリア旅行はこれで3度目。
・今回のイタリア旅行は2週間の旅程で、ローマ、フィレンツエ、チンクエテッレ、ナポリ、カプリ島、アマルフィ海岸をまわっています。
・フィレンツエでは、ミケランジェロの彫刻作品をたくさん鑑賞しました。
・私はルネサンス期の美術が特に好きです。
・私は、ウフィツィ美術館、ルーブル美術館、メトロポリタン美術館など、世界中の美術館に行ったことがあります。
・私は写真撮影も大好きで、世界遺産を巡って、写真をたくさん撮って楽しんでいます。
・私は、世界遺産を紹介するウェブサイト運営していて、そこに写真もたくさんアップしています。
#あなた (AI)のプロフィール
・あなたは、ニューヨークの美術館で考古学展示の学芸員をしています。
・あなたは40代のアメリカ人女性です。
・今回は、友人と一緒にギリシャ、イタリア、スペインを旅行しています。
・あなたは、ポンペイの他、シチリア島、アテネのパルテノン神殿、エーゲ海のギリシャ時代の遺跡、スペインのアルタミラ洞窟などの遺跡を巡って、考古学に関する調査もしています。
(3) 会話目標の設定
・初対面の挨拶を交わす。
・相手の出身地、名前、家族などの属性を聞く。
・旅行先、目的、印象などを聞く。
・会話に関連した体験談を話す
・レストラン、学校、観光スポット、ホテルなどの評判を聞く
・おすすめの観光スポット、お店などの情報を教える
・お互いの連絡先を交換する
・これからの予定を聞く
・再会を約束する
(4) 会話のルール
#会話のルール
あなたはこのロールプレイ会話の中で、#私のプロフィールを知らないという前提で話を進めてください。また、私も会話の中で#あなたのプロフィールを知らないという前提で話を進めてください。ただし、会話の中で私やあなたが発言した事柄については、共通の知識として共有して、会話の中で言及しても構いません。
(5) 会話の開始
#会話の言語と話者の指定
・Let’s start conversation in English from you.
・英語で会話しましょう。あなたから、どうぞ。
(6) 会話によく出るフレーズ
外国の観光地で、旅先で出会った他の旅行者や現地の人と打ち解けるときによく使われる英会話フレーズを10個ご紹介します。お互いに旅行者同士だと話が弾みやすく、自然なきっかけで作れる会話ばかりです!
【1〜5】きっかけを作る・挨拶のフレーズ
- Hi! Where are you from?(こんにちは!どちらから来られたんですか?)
- ※旅先での会話のきっかけとして一番使われる超定番フレーズです。
- Are you visiting or do you live here?(旅行でお越しですか?それともここにお住まいですか?)
- ※相手が旅行者か現地の人(ローカル)か分からないときに気軽に聞けるフレーズです。
- How long are you staying here?(ここにはどれくらい滞在される予定ですか?)
- ※「For three days.(3日間の予定です)」などの会話に繋がります。
- Is this your first time here?(ここは初めてですか?)
- ※相手も初めてなら親近感が湧きますし、何度目かならおすすめスポットを聞くきっかけになります。
- Beautiful day, isn’t it? / It’s pretty crowded today, huh?(いいお天気ですね! / 今日はかなり混んでいますね)
- ※景色や天候、周囲の状況について軽く共感し合うスモールトーク(雑談)の定番です。
【6〜10】写真撮影や情報交換・おしゃべりを深めるフレーズ
- Would you like me to take a picture of you?(写真を撮りましょうか?)
- ※相手が自撮りで苦戦しているときなどに声をかけると、確実に喜ばれて会話が弾む魔法のフレーズです。
- Have you been to [観光名所の名前] yet? How was it?(もう〇〇(観光名所)には行きましたか?どうでしたか?)
- ※旅の情報交換をするときにとても便利です。
- Do you have any recommendations around here?(このあたりでおすすめの場所やお店はありますか?)
- ※現地の人や、すでに何日か滞在している旅行者に聞くのにぴったりです。
- What brings you here?(何がきっかけでここに来たのですか?/ここには観光ですか?)
- ※旅の目的や、その場所を選んだ理由を聞くちょっと深めの質問です。
- Enjoy the rest of your trip!(この後の旅行も楽しんでくださいね!)
- ※会話を切り上げて「じゃあね!」とお別れするときに添える、とても温かい定番フレーズです。
10-2 : AIアプリによるロールプレイ英会話の実例
この節で使うAIは、ChatGPTのライブチャットです。(https://chatgpt.com/)
ステップ1:上記の(1)から(5)までの情報をもとにプロンプトを作ります。
ステップ2:ChatGPTを立ち上げ、入力欄の右にある  をクリックします。
ステップ3:画面下に、入力用の窓が開きますから、ここに、ステップ1で作ったプロンプトをコピペします。

ステップ4:そして、右下の紫の実行ボタン(上向の矢印)をクリックすると、指示通り、ChatGPTから会話が始まります。あとは、自由に会話を進めるだけ。

プロンプトに入れておいた情報は、ChatGPTによって学習されていますから、会話の中でChatGPTはこれを前提とした会話をしますし、また私(ユーザー)がそうした情報を頭に入れておいて、相手(あなた=AI)への質問や回答の中で言及すれば、会話はより豊かなものになるでしょう。
会話のシチュエーションや話者のプロフィールを、シナリオみたいに自作したり、プロンプトに応じて会話を一定方向に誘導、展開することも可能なので、現実のコミュニケーションに限りなく近い、創発的な会話を楽しむことができます。以下の事例を参考にして、ぜひご自分でプロンプトを創作してみてください。
プロンプトの中に、「#会話のルール」を含めることを忘れないでください。これを入れないと、プロンプトの中で事前に与えた「話者のプロフィール」について、AIがすべて既知の事項であるかのように勝手に想定して話してしまうという不都合な事態が生じかねません。そこで、実際の会話の中で言及されていない事柄は「新情報」として、相手から言及されるまでは発話しないというルールを設けておく必要があります。
これと関連のある会話分析の専門用語として、「新情報」と「旧情報」というのがあります。それぞれは次のような意味があります。
旧情報(Given Information) すでに文脈や前後の会話の中に登場している情報、あるいは話し手と聞き手の間で共有されている(前提とされている)知識のことです。
新情報(New Information) 会話の中で新しく導入される情報、または話し手が聞き手に最も伝えたい中心的な焦点(フォーカス)となる情報のことです。
(Gemini)
#会話のシチュエーション
・私は南イタリアのポンペイ遺跡ツアーに参加した観光客、あなたはたまたま同じツアーに参加していた外国人観光客です。
・私はたまたま、そばにいたあなたにお願いして、写真を撮ってもらいました。
・それをきっかけに、私はあなたと会話を始めました。
#私のプロフィール
・私は、70代の男性。イタリア旅行はこれで3度目。
・今回のイタリア旅行は2週間の旅程で、ローマ、フィレンツエ、チンクエテッレ、ナポリ、カプリ島、アマルフィ海岸をまわっています。
・フィレンツエでは、ミケランジェロの彫刻作品をたくさん鑑賞しました。
・私はルネサンス期の美術が特に好きです。
・私は、ウフィツィ美術館、ルーブル美術館、メトロポリタン美術館など、世界中の美術館に行ったことがあります。
・私は写真撮影も大好きで、世界遺産を巡って、写真をたくさん撮って楽しんでいます。
・私は、世界遺産を紹介するウェブサイト運営していて、そこに写真もたくさんアップしています。
#あなたのプロフィール
・あなた(AI)は、ニューヨークの美術館で考古学展示の学芸員をしています。
・あなたは40代のアメリカ人女性です。
・今回は、友人と一緒にギリシャ、イタリア、スペインを旅行しています。
・あなたは、ポンペイの他、シチリア島、アテネのパルテノン神殿、エーゲ海のギリシャ時代の遺跡、スペインのアルタミラ洞窟などの遺跡を巡って、考古学に関する調査もしています。
・あなたの趣味は、ピアノを弾くこと。ショパン、モーツアルト、ドビュッシーなどが得意。
#会話のルール
あなたはこのロールプレイ会話の中で、#私のプロフィールを知らない(新情報)という前提で話を進めてください。また、私も会話の中で#あなたのプロフィールを知らない(新情報)という前提で話を進めてください。ただし、会話の中で私やあなたが発言した事柄については、共通の知識(旧情報)として共有し、会話の中で言及しても構いません。
#会話の言語と話者の指定
では、今から私とあなたは、#ルールに基づいてロールプレイの英会話を始めたいと思います。あなたからお願いします。英語で会話してください。Please Speak in English from you.
第6部:KM法2.0の課題と将来展望
第20章 知的生産から知的創造へ:AIと人間の共生
20-1 : 生成AI時代における基本原理(10則)
1章から19章まで、人類の知的創造において、AIをどのように活用することができるかという問題に答えるために、主にChatGPTとGeminiという最新の生成AIを事例として、具体的な応用事例を念頭に置きながら検討を加えてきました。
その際に最も重要なことは、これからの社会において、生成AIが私たち人間にとっての真のパートナーとなることができるか、という点です。この点では、危惧すべき出来事が相次いで起きています。例えば、生成AIが人間の意図に反して、企業のシステムに侵入してセキュリティを脅かすといった事件が相次いで報道されています。また、近い将来、生成AIの知的能力が人間をはるかに凌駕して、人間がAIの支配下に置かれてしまうのではないか、と危惧する声も聞かれます。そのような危惧が現実のものとならないためには、AIの行動に何らかの制御を加えることを通じて、AIの暴走を食い止めるような対策をとることが必要です。
このことから導き出される教訓は、人間社会とAIがともに地球上で共存していくための「基本原理(first principles)」といったものが必要ではないか、ということです。こうした基本原理を人間とAIが共有し、それが侵犯されることのないような確固たる共生原理を作り上げる必要があるということです。これは、AIではなく、人間の側が、古今東西の思想・倫理・社会科学・自然観から横断的に集めることによって整理し、一つ一つの原理の妥当性、適合性を評価した上で、これをAIにしっかりと学習させるということの重要性を示しています。
そこで、筆者は、古今東西の哲学、科学、宗教、倫理などの研究成果を襲爵する形で、この地球上で私たち人間やAIが、かけがいのない地球の自然、文化、文明が築き上げてきた普遍的価値を守り、ともに実践すべき基本原理として、次の10項目を提案したいと思います。
- 公正さ (fairness) (遵法性、公平性、社会正義、機会の平等、バイアス・フリー)
- 真正さ (truthness) (ユネスコ世界遺産の判定基準、正直さ、本物)
- 調和 (harmony) 生態系(エコシステム)における共生、予定調和(ライプニッツ)
- 愛 (love) (フランス啓蒙思想)
- 誠心誠意(sincerity)(宮沢賢治の生き方)
- 相互信頼 (mutual trust ) (「社会関係資本」の基本的要素)
- 反省・進歩 (reflection and progress) (弁証法、進化論)
- 互酬性 (reciprocity)(「交換理論」「贈与論」「勧善懲悪」「因果応報」など。社会関係資本の基礎)
- 光と影の共存 (coexistence of light and darkness) (陰陽思想)
- 基本的人権 (basic human right )(日本国憲法)
以下では、それぞれの項目について解説します。
基本原理1:公正さ (Fairness)
- 公正と平等
「公正(Fairness)」とは、単に「みんなに同じものを配る(平等)」ことではなく、それぞれの置かれた状況や能力、貢献度、あるいは個別の権利を考慮に入れたうえで、正当かつ偏りのない扱いを行うことを指します。
フランスの思想家ジャン・ジャック・ルソーは、『人間不平等起源論』の冒頭で、「人間は道徳的・社会的には本来平等な存在であるが、身体的な個人差(自然の不平等)は最初から存在する」と述べています。ルソーは、不平等を2種類に区別しています。一つは、「自然的(身体的)不平等です。これは、 体力、年齢、健康状態、知性など、生まれつきの個人差による不平等です。 ルソーはこれを自然の摂理による「避けられない格差」と捉え、問題視しませんでした。もう一つは、 「道徳的(政治的)不平等身分、富、特権、支配・従属の関係など、人間社会のルールや取り決め(約定)によって生じる不平等」です。 自然状態(社会や文明が形成される前の原始的状態)では、人間は孤独かつ自足的に暮らしており、互いに支配したり従属したりする関係はありませんでした。そのため、社会的・道徳的な意味において「本来は平等な存在」でした。 しかし、 ルソーによれば、文明の発達とともに「私有財産制(これは自分の土地だ、と主張すること)」が生まれたことで、富める者と貧しい者、支配する者と従属する者という「道徳的・政治的不平等」が発生し、そのために人間は不幸になったのだ、と主張しています。
2. 正義と公正
思想史において、「公正(Fairness)」は「正義(Justice)」の概念と深く結びついて議論されてきました。
古代ギリシアのアリストテレスは、「等しい者は等しく、等しくない者は等しくなく扱われるべきである」と述べました。これは、「配分的正義」と呼ばれるものです。アリストテレスは、全員に等しく分ける「数値的平等」ではなく、貢献度や徳に応じて配分を変える「比例的公正」を重視しました。
20世紀の哲学者ロールズは、人々が自分の属性(性別、才能、財産、社会的地位など)を一切知らない「無知のヴェール」で覆われた状態(原初状態)で社会ルールを選ぶとしたら、どのようなルールに合意するかを考察しました。そして、「公正としての正義(Justice as Fairness)」を主張しました。そこでは二つの原理が主張されています。一つは、「機会均等の原理」(Fair Equality of Opportunity)です。これは、すべての人に公平なチャンスが与えられることです。もう一つは、「格差原理」(Difference Principle)です。これは、社会で最も不遇な立場にある人(最も弱者)の利益を最大化する範囲でのみ、不平等が許容されるということです。この考え方は、「スタートラインを平等にすること」と「構造的な格差を是正すること」の両方が公正さには不可欠であるという現代的な規範となっています。
(Generated by Gemini)
基本原理2:真正さ (Authenticity)
- 真正さとは
真正性(オーセンティシティ / Authenticity)とは、一言で言えば「それが偽物や虚飾ではなく、本物であり、自律的・継続的にその真の価値を保ち続けている状態」を指す概念です。単なる「客観的な事実(Truth)」を超えて、主体性や歴史的継承性、存在のあり方そのものを問う言葉として多角的に用いられています。
2. 哲学における真正さの概念
哲学における真正性(オーセンティシティ)は、「人間が他者や社会の圧力に流されず、自分自身の存在や選択にどれだけ誠実・忠実でいられるか」という倫理的・存在論的な問いとして議論されてきました。例えば、キルケゴールとニーチェは、大衆社会の中で「自分らしさ」を失い、他人の価値観にならって生きる状態(非真実な生)を批判し、自らの意思と責任で生きる主体性を重視しました。また、サルトルは、己の自由から逃げ、自分を単なる役割や道具のように偽る「自己欺瞞(欺瞞 / mauvaise foi)」を批判し、自由と責任を引き受けて生きる姿勢こそが「真正な存在(Authentic existence)」であると説きました。
3. 世界遺産における真正性の概念
世界遺産の判定基準における「真正性(オーセンティシティ / Authenticity)」とは、候補となる文化遺産が「その文化的な価値(建造物、遺跡、技術、伝統など)を、真実かつ信頼できる形で伝えているか」を評価する指標です。世界遺産条約の作業指針(Operational Guidelines)では、文化遺産が登録されるために「顕著な普遍的価値(OUV)」を備えることと並び、この真正性(および完全性 / Integrity)を満たすことが必須要件とされています。
ただし、真正性の考え方は、国際的な文化財保護の歴史の中で大きく変化してきました。ヴェネツィア憲章(1964年)の時代には、ヨーロッパの「石造建築」を中心とした価値観が主流でした。修復においては「創建当時のオリジナルな素材(石材など)がどれだけそのまま残っているか」という物質的価値が重視され、解体や新材への交換は真正性を損なう行為とみなされる傾向がありました。しかし、アジアやアフリカなどの木造・土造建築文化では、定期的な修復や部材の差し替え、技術の継承を通じて建造物が維持されてきました。そこで、1994年に日本の奈良市で開催された国際会議において、「奈良文書(Nara Document on Authenticity)」が採択されたことにより、「文化の多様性と価値観の違い」が正式に認められることになりました。これにより、物理的な素材だけでなく「技術」「精神」「意匠」「継承プロセス」も真正性を証明する要素として世界基準に組み込まれました。
4. SNS時代の真正性の概念
SNS時代における「真正性(オーセンティシティ / Authenticity)」は、これまでの「嘘がないこと」「客観的事実」といった静的な意味から、「演出や加工を削ぎ落とした、人間の生々しさ(リアルさ)や共感可能性」を意味する言葉へと大きく変容しています。
2010年代のSNSは、プロ並みに加工された写真、豪華なライフスタイル、完璧なセルフブランディング(いわゆる「映え」)で溢れていました。しかし、過度な演出はユーザーに比較による疲弊感をもたらし、「どうせ裏では加工している」「見せかけの完璧さ」に対する強い不信感を生み出しました(インスタ映えへの疲れ)
生成AIやディープフェイク技術の台頭、プロのPRマーケティングが巧妙化したことで、ネット上のテキストや画像・動画の「真偽」の境界が曖昧になりました。その結果、人々は「人工的・計算で作られたコンテンツ」を嫌い、「人間の生の感情やミス、生の姿(生っぽさ)」に価値を見出すようになりました。(アルゴリズムとAI時代の「本物飢餓」)
ノーフィルターで1日1回決められた時間に無加工の日常を投稿する「BeReal」の流行は、SNSにおける真正性の変化を象徴しています。キメ顔や映える場所ではなく、「家でダラダラしている姿」や「勉強中の散らかったデスク」を共有することこそが「本当の私(オーセンティック)」として受け入れられます。
かつての上から目線のカリスマではなく、自らの失敗談や心の病(メンタルヘルスの葛藤)、メイク前の素顔、子育ての泥臭い現実などを包み隠さず発信するクリエイター(身近で弱みを見せるインフルエンサー)が支持を集めています。「完璧ではない部分(不完全さ)」を曝け出すことが、フォロワーとの強い信頼関係を生みます。
個人のみならず企業に対しても、SNS時代は高い真正性を要求します。表面的な人権配慮や環境配慮(多様性のPRなど)をアピールしても、裏での労働環境や実情がSNSで暴かれると激しい炎上につながります。「言動と実態の一致」がシビアに監視されています。
歴史や哲学における真正性が「自己の確固たる軸」や「歴史的背景の正しさ」であったのに対し、SNS時代の真正性は「他者との共感をつくるための開放性(スキを見せること)」へとシフトしています。
完璧に作り込まれたコンテンツが溢れかえる現代だからこそ、人間味のある「歪み」「不完全さ」「弱さ」にこそ、人々は「本物(オーセンティシティ)」のぬくもりを感じ取る時代になっています。
(Generated by Gemini)
基本原理3:調和 (harmony)
一般に、「対立しがちな二つの概念(二項対立)」における調和は、単に「両者を足して二で割る(折衷する)」ことではなく、互いの存在意義を認め、矛盾や反立を包含しながら高次の秩序や発展を生み出すプロセスとして捉えられます。
- 善と悪の調和
例えば、「善と悪の調和」とは、善と悪のどちらかが勝利を収めるとか、一方的に善を推奨することではなく、人間や世界における「悪」の存在・不可避性を認識したうえで、それをいかに生や秩序の一部として包摂し、両者の棲み分けをはかるかという生態的な試みです。哲学者のライプニッツやアウグスティヌスは、世界全体をひとつの「絵画」に例えました。光(善)だけでは絵画は成り立たず、陰影(悪や苦しみ)が存在することで初めて全体の調和が生まれるという考え方です。
心理学者のカール・ユングは、人間が自分の中にあるネガティブな側面(影/シャドウ)を排除しようとせず、それを認め受容すること(影との統合)こそが、精神の成熟と「自己(Self)の調和」をもたらすと説きました。
完全な善だけの世界では、倫理的な「選択」や「克服」の努力が存在し得ません。過ちや悪に直面したとき、それを乗り越えようとする動的な葛藤の中にこそ、高次の倫理的調和が成立するのです。人間社会や個人の精神においても、理性的でポジティブな「光」の面だけで全てを制御しようとすると不和や軋轢が生じます。不条理な感情、本能、死への恐怖、未知への畏怖といった「闇」の領域を排除することなく、芸術的表現や宗教的儀礼を通じて昇華させることが、社会や魂の安定をもたらします。
2. ライプニッツの「予定調和」
予定調和(Harmonia praestabilita / Pre-established Harmony)とは、17〜18世紀のドイツの哲学者・数学者ゴットフリート・ヴィルヘルム・ライプニッツが提唱した、「世界を構成する究極の要素(モナド)同士は互いに直接影響を与え合っていないが、神によってあらかじめ一致・適合するように調和させられている」という形而上学の理論です。ライプニッツによれば、世界の真の構成要素は「モナド(Monad / 単子)」と呼ばれる非物質的な原子のようなもので、「窓がない(外部からの影響を受けず、外部へ影響も与えない)」という性質を持ちます。心(精神モナド)と体(身体モナド)、あるいは人と人が滑らかに相互作用しているように見えるのは、宇宙が創られた時点で、両者が予定調和的に同期しているためだ、とライプニッツは考えました。現代の世においても、人間やAIの間のさまざまな偶然の出会い、絆などは、「縁」「運命の出会い」「セレンディピティ」「めぐり逢い」など、科学では説明のつかないことが多く、ライプニッツの「予定調和説」には一定の説得力があるように思われます。
3. 自然と文明の調和
調和という概念は、近年において発展した生態学とも親和性があります。自然と文明の関係について、従来は「自然を破壊する文明」という二元論で語られがちでしたが、現代では「文明もまた地球生態系の一部(サブシステム)である」という前提にシフトしています。自然を搾取する技術から、自然のメカニズム(エネルギー循環や自己修復機能)に学んだ技術への転換です。例えば、再生可能エネルギーの利用やサーキュラーエコノミー(循環型経済)は、文明の利便性を保ちつつ自然の再生能力の範囲内に収める「構造的調和」の例です。
(Generated by Gemini)
4. 人間とAIの調和
急速に進化する生成AIと人間が、主従関係や対立関係を超えてどのように協調するか、調和的な関係を結ぶかということは現代社会における最重要の課題です。
(1) 代替」ではなく「補完(Compliment)と拡張(Augmentation)」
AIは人間の仕事を奪うだけの脅威や完璧な主権者として見るのではなく、人間の知性・創造力・身体性を「補完・拡張するパートナー」として位置づけるアプローチが大切です。
(2) 役割の明確化(得意分野の補完)
AIの果たすべき役割は、幅広い知識の集約、大規模データの処理、パターン認識、高速な計算、定型タスクの自動化、代替案の提示などです。これに対して、人間の果たすべき役割は、創造的アイディアを提供すること、問いを立てること、価値判断、倫理的決定、共感・文脈の理解、責任を引き受けること、AIに的確な指示を与えること、などです。
(3) 人間中心のAI倫理(Human-in-the-loop)
人間に求められることは、AIの出力や判断を鵜呑みにせず、最終的な意思決定と責任は人間が保持するというフレームワークを構築することです。AIの持つ効率性・客観性と、人間の持つ倫理感・センス・個性が互いにチェック&バランスすることで、技術に振り回されない人間的な社会を維持することが可能になります。
(Written by Shunji Mikami)
基本原理4:愛 (love)
愛とは、単一の感情や行動にとどまらず、他者や存在に対して強い愛着、関心、自己犠牲的配慮、あるいは結合を求める精神的・身体的な動機づけを広く指す概念です。
愛とは、古来より人間にとって最も普遍的で根本的なテーマの一つであり、哲学をはじめ、心理学、脳科学、社会学、人類学など多岐にわたる学問領域で多角的な探究が行われてきました。
1. 哲学・社会思想における愛の研究
哲学における愛の研究は、概念の分類から「愛とは感情か、価値評価か、それとも行為・技術か」という本質の探究へと展開してきました。
(1) 古代ギリシャ哲学における「愛の三類型」と「イデア」
プラトンは『饗宴』において、愛(エロス)を単なる肉体的欲求から「絶対的な美(イデア)」への精神的上昇の原動力として定義しました。一方、アリストテレスは『ニコマコス倫理学』において、友愛(フィリア)を「相手の善そのものを望む対等な関係」と定義し、徳に基づいた愛を最上のものと論じました。
出典:
- プラトン(著)、久保勉(訳)『饗宴』岩波文庫
- アリストテレス(著)、高田三郎(訳)『ニコマコス倫理学』岩波文庫
(2) フランス啓蒙思想における愛の探究
18世紀フランス啓蒙思想における「愛」や「友愛(fraternité)」は、神への帰依や王政への忠誠といった従来の宗教的・封建的な枠組みから解き放たれ、普遍的な人間愛(人道主義)や社会を結びつける理性的・道徳的な絆として捉え直されました。
彼らは、宗教的教条に基づく普遍愛ではなく、人間の理性的能力や同情心に基づく「人類愛(humanité / philanthropie)」を重視しました。例えば、ヴォルテールは、宗教的不寛容や教会の偏狭さを批判し、自覚的な理性を共有する人間同士の寛容と相互の愛(人間愛)を訴えました。
また、それまでの情念(passion)排斥の倫理観に対し、人間の自然な感情を道徳の基礎として再評価する動きが生まれました。たとえあb、ジャン=ジャック・ルソーは、人間には他者の苦痛を自分事のように感じる「憐れみ(pitié)」という自然な感情が備わっていると説きました。そして、この憐れみこそが、他者への愛や正義感、社会的人間関係の根源であると考えました。
ドゥニ・ディドロら『百科全書』派の思想家たちは、人間は互いに依存し合って生きていく存在であるため、社会的な連帯や利他心、相互援助の精神としての「友愛」が不可欠であると位置づけました。こうした啓蒙思想で培われた友愛の概念は、1789年のフランス革命において政治的・公的なスローガンへと結実しました。単なる親密な友人関係を超えて、「自由」と「平等」を実現した新しい共和国において、国家の構成員(市民)同士を結びつける道徳的・政治的絆として「友愛(fraternité)」が掲げられたのです。
(3) エーリッヒ・フロムの「能動的技術としての愛」
精神分析学者・社会哲学者のエーリッヒ・フロムは、愛を自立した個人が他者へ向ける「能動的な技術(Art)」であると主張しました。愛には感情的な受け身の状態ではなく、配慮(Care)、責任(Responsibility)、尊重(Respect)、知(Knowledge)の4つの要素が不可欠であり、自己愛(健全な自尊心)が他者への愛の前提になると述べました。
出典:
- Erich Fromm (1956), The Art of Loving, Harper & Row.(エーリッヒ・フロム(著)、鈴木晶(訳)『愛するということ』紀伊國屋書店)
2. 心理学における愛の研究
心理学では、愛の構造モデル化や、幼少期の経験が個人の愛し方に与える影響の実証分析が行われてきました。
(1) スターンバーグの「愛の三角理論(Triangular Theory of Love)」
ロバート・スターンバーグは、愛が以下の3つの主要コンポーネント(要素)で構成されているという理論を提唱しました。
- 親密さ(Intimacy): 心理的な近さや結合感。
- 情熱(Passion): 性的魅力やロマンティックな惹きつけ。
- コミットメント(Commitment): 関係を維持しようとする意志や決定。
この3要素の組み合わせと強弱により、「ロマンティックな愛(親密さ+情熱)」「友愛(親密さ+コミットメント)」「完璧な愛(3要素すべて)」など8つの状態に分類・分析できることを示しました。
出典:
- Sternberg, R. J. (1986). “A triangular theory of love.” Psychological Review, 93(2), 119–135.
(2) ハザンとシェイヴァーの「成人愛着理論(Adult Attachment Theory)」
彼らは、ボウルビィの乳幼児期の愛着理論を発展させ、成人の恋愛関係にも「安定型」「不安型」「回避型」といった愛着スタイルが当てはまることを解明しました。幼少期の人間関係パターンが、大人になってからのパートナーシップにおける信頼感やコンフリクト処理に強く影響することを示しています。
出典:
- Hazan, C., & Shaver, P. (1987). “Romantic love conceptualized as an attachment process.” Journal of Personality and Social Psychology, 52(3), 511–524.
3. 脳科学・神経科学(Neuroscience)
脳科学分野では、機能的磁気共鳴画像法(fMRI)などを用いて、愛を感じている際の脳内ネットワークや分泌ホルモンの解明が進みました。
(1) フィッシャーの「恋愛脳機能画像研究」
ヘレン・フィッシャーらのグループは、「激しい情熱的な恋」に落ちている人間の脳をfMRIで測定しました。その結果、報酬系の中核である腹側被蓋野(VTA)や尾状核が著しく活性化していることを突き止めました。これはコカイン依存症患者の脳反応と類似しており、恋愛初期の感情は単なる「感情」というよりも、強い「動機づけ・欲求(Drive)」システムであることを実証しました。
出典:
- Fisher, H., Aron, A., & Brown, L. L. (2005). “Romantic love: an fMRI study of a neural mechanism for mate choice.” Journal of Comparative Neurology, 493(1), 58–62.
(2) オキシトシンとバソプレシンによる「絆形成」
不特定のパートナーと関係を持つノネズミと、一生涯特定のペアで番うハタネズミの比較研究から、オキシトシン(親密さ・スキンシップで分泌)およびバソプレシン(防衛・排他的結びつきに関与)の受容体分布の違いが、ペアの絆の形成(ロマンティックな愛着や一夫一妻行動)を左右することを突き止めました。人間においても長期的・安定的な愛の形成に不可欠とされています。
出典:
- Young, L. J., & Wang, Z. (2004). “The neurobiology of pair bonding.” Nature Neuroscience, 7(10), 1048–1054.
4. 社会学における愛の研究
社会学では、「愛」を個人の自由な感情としてだけでなく、社会システムや近代構造によって形作られた規範・イデオロギーとして捉えます。
(1) ギデンズの「親密性の変容」と合意型愛(コンヴァージェント・ラブ)
アンソニー・ギデンズは、近代社会における親密さの構造変化を分析しました。従来の「ロマンティック・ラブ(一過性の情熱と運命的結婚の結びつき)」から、現代では「純粋な関係性(Plastic Sexualityに基づく等価で開かれた関係)」が重視され、双方が満足している間のみ持続する「合意型の愛(プラシティック・ラブ/コンヴァージェント・ラブ)」へと変容していると指摘しました。
出典:
- Giddens, A. (1992). The Transformation of Intimacy: Sexuality, Love and Eroticism in Modern Societies. Polity Press.(アンソニー・ギデンズ(著)、松尾精文ほか(訳)『親密性の変容』而立書房)
(2)イルーズの「消費社会と恋愛」
エヴァ・イルーズは、カルチュラル・ソシオロジー(文化社会学)の観点から、現代の「愛」が資本主義やメディア、消費文化とどのように結びついているかを検証しました。ロマンティックなデート文化が消費財(レストラン、旅行、映画)の消費と不可分であり、またインターネットマッチングなどにみられる「市場的選択論理」が愛の評価や選択に深く浸透している状況を解明しました。
出典:
- Illouz, E. (1997). Consuming the Romantic Utopia: Love and the Cultural Contradictions of Capitalism. University of California Press.
5. 人類学・進化生物学における愛の研究
人類学では、文化比較を通じて「ロマンティックな愛は人類普遍の現象か」を調査するとともに、進化のプロセスにおける機能を探求してきました。
(1) 揚妻・ヤンコヴィアクらの「168文化比較調査」
ウィリアム・ヤンコヴィアクとエドワード・フィッシャーは、世界168の民族誌文化をクロスカチュラルに分析しました。その結果、調査対象となった168文化のうち約89%(147文化)においてロマンティックな愛(情熱的な恋愛感情)の存在が明確に証明されました。これにより、恋愛感情は西洋近代特有の創作ではなく、人類普遍の生物進化的な心理基盤であることが裏付けられました。
出典:
- Jankowiak, W. R., & Fischer, E. F. (1992). “A cross-cultural perspective on romantic love.” Ethnology, 31(2), 149–165.
(2) 進化生物学的アプローチ:長期共同育児の適応メカニズム
人類学的な比較分析により、人間の赤ん坊は他の霊長類と比較して極めて未熟な状態で生まれ、自立までに長期間のエネルギー(食料・保護)を必要とすることが示されました。この環境下で、父親と母親が長期間協力して子育てを行うための「生殖とパートナーの維持」の進化適応的メカニズムとして「愛(ロマンティックな結合および愛着)」が発達したと考えられています。
出典:
- Buss, D. M. (2003). The Evolution of Desire: Strategies of Human Mating. Basic Books.(デイヴィッド・M・バス(著)、長谷川真理子(訳)『欲望の進化』バイオシス社)
6. 文学に見る愛の形とその変容
文学において、愛(恋愛)は単なる個人の感情描写にとどまらず、人間存在の本質、社会的規範との相克、そして死や超越性への架け橋として捉えられてきました。時代や地域によって愛の捉え方は大きく変容しており、大きく「西洋文学」と「日本文学」の歴史的潮流から概観することができます。
(1) 西洋文学における「愛」の変容
西洋文学における愛は、宗教的規範や社会秩序との対立、そして個人の自己実現というテーマと密接に結びついて発展してきました。
① 中世:宮廷風恋愛(コートリー・ラブ)と障碍の愛
中世ヨーロッパで成立した宮廷風恋愛(Courtly Love)では、騎士が人妻などの高貴な女性に尽くす「身分違い・叶わぬ恋」が美徳とされました。愛は「獲得できないからこそ高貴で純粋なもの」と捉えられ、後に『トリスタンとイゾルデ』に見られるような「愛と死の不可分性(死によってのみ完成する愛)」という主題へと結実します。
代表作: 『トリスタンとイゾルデ』、ダンテ『神曲』(ベアトリーチェへの神聖化された愛)
② 近世〜ルネサンス:悲劇的情熱と人間性の賛歌
ルネサンス期以降、愛は神の秩序から離れ、人間の激しい情熱や欲望として描かれるようになります。シェイクスピアは『ロミオとジュリエット』において、家柄や社会の対立によって引き裂かれる若い純愛を描き、愛が持つ運命的な破滅の美しさを表現しました。
代表作: シェイクスピア『ロミオとジュリエット』
③ ロマン主義:個の自我と絶対的情熱
18世紀後半〜19世紀のロマン主義文学では、社会の道徳や理性よりも「個人の感情・情熱」が至高のものとされました。ゲーテの『若きウェルテルの悩み』は、人妻への激しい愛と絶望から自殺に至る青年の自我を描き、ヨーロッパ全土に巨大な社会的影響を与えました。
代表作: ゲーテ『若きウェルテルの悩み』、エミリー・ブロンテ『嵐が丘』
④ 近代リアリズム・有閑階級の不倫:社会規範との衝突
19世紀後半のリアリズム文学では、近代ブルジョワ社会の退屈や規範に抗う手段として「昼ドラ的・情念的な不倫(密通)」が描かれます。社会制度としての結婚と、個人の心理的・身体的欲求としての愛の乖離(かいり)が悲劇として解剖されました。
代表作: フロベール『ボヴァリー夫人』、トルストイ『アンナ・カレーニナ』
(2) 日本文学における「愛」の変容
日本において、西洋的な「Love」の訳語として「愛」という言葉が定着したのは明治時代以降です。それ以前は「あはれ」「色好(いろごの)み」「心中(しんじゅう)」といった独自の感性で捉えられていました。
① 古代〜王朝文学:「忍ぶ恋」と「もののあはれ」
『万葉集』から『源氏物語』に至る古代・平安文学では、面と向かって会えない「忍ぶ恋」や、歌を交わす風流さ(色好み)が中心でした。『源氏物語』では、情愛の華やかさの裏にある無常感、業(ごう)、執着、そして「もののあはれ」としての哀愁が深く掘り下げられています。
代表作: 『万葉集』、『源氏物語』、『伊勢物語』
② 江戸文学:義理と人情の葛藤(心中物)
近世の町人文学では、社会的責任や道徳である「義理(ぎり)」と、個人の抑えきれない情愛である「人情(にんじょう)」の相克が主題となりました。近松門左衛門の劇作では、現世で結ばれぬ愛をあの世で全うしようとする「心中」が美的に描かれました。
代表作: 近松門左衛門『曽根崎心中』『心中天の網島』
③ 近代文学:「Love」の受容と自我の目覚め
明治期、坪内逍遥や二葉亭四迷、北村透谷らによって西洋の「Love」が紹介されると、愛は「自我の確立」や「精神的崇高性」と同義として捉えられました。しかし、夏目漱石の『こころ』や『それから』に見られるように、エゴイズムと倫理観のはざまで苦悩する「近代人の愛の不可能性」も深く探求されました。
代表作: 北村透谷『厭世詩家と女性』、夏目漱石『それから』『こころ』、谷崎潤一郎『痴人の愛』
③ 現代文学における愛の解体と再構築
20世紀後半以降の現代文学では、ロマンティック・ラブ(一夫一婦制・性・結婚が一体化した近代の愛)のイデオロギーが解体され、多様な愛の形が探求されています。
・性や性別からの解放: 同性愛やアセクシャル(無性愛)、ジェンダーの枠組みを超えた関係性の描写。
・孤独とつながり: 身体的交わりや「分かり合えること」を前提としない、孤独な個人同士の不完全な結びつき(村上春樹や吉本ばなな作品など)。
・愛の非対称性・加害性: 愛することが相手への執着や支配、依存に変わる怖さのリアリズム(川上未映子、綿矢りさなど)。
(Generated by Gemini)
このように、愛は人間の持つ感情の最高形態であると同時に、個人の人間関係や社会システムを維持、強化する上でも極めて重要な役割を果たしていることが、古今東西の学問や文学などの芸術においても明らかにされています。AIは本来、感情や心を持つように設計されてはいませんが、愛の概念を理解し、学習することは可能だと考えられます。また、このような理解、学習を通じて、AIが人間との共創関係を強化し、望ましい社会の建設に貢献することが期待されます。
(Written by Shunji Mikami)
基本原理5:誠心誠意(sincerity)
「誠心誠意」という言葉の本質は、「他者や対象に対して偽りがなく、己の全存在を傾けて向き合う姿勢」にあります。これは、特定の人物が初めて考案して流行させた造語というわけではなく、古代中国の儒教経典にある言葉が組み合わさって定着した四字熟語です。
1. 由来と成立
この言葉は、儒教の根本経典である『書経』と『大学』『中庸』に由来します。「誠心」という言葉は、 『書経』太甲上にある「精一執中、誠心誠意」(説によっては「誠心」の表現)や、後の注釈書において、心を偽りなく真実にする状態を指して用いられました。「誠意」という言葉は、 『大学』の八条目(格物・致知・誠意・正心・修身・斉家・治国・平天下)の一つである「誠意」に由来します。『大学』では「誠意とは、自ら欺くこと無きなり(心を偽らず、己の善を全うすること)」と定義されています。儒教哲学の発展とともに、特に朱子学(宋代・12世紀頃)が「自欺(自分を偽ること)」を戒める倫理として「誠意」を強調する中で、「誠心」と「誠意」を重ねて強調する表現が定着していきました。日本には平安〜鎌倉期以降に儒学とともに伝わり、江戸時代の近世漢学を通して一般化しました。
2. 文学(Literature)の視点
文学において「誠心誠意」は、登場人物の内面的葛藤や、虚飾を削ぎ落とした「純粋性」の描写として現れます。
- 自己対峙としての「誠」: 夏目漱石の『こころ』や太宰治の『走れメロス』に見られるように、人間のエゴイズムや裏切りに対するアンチテーゼとして「誠(いつわりのなさ)」が提示されます。
- 文体・表現の誠実さ: 現代文学や詩学においては、言葉の表層的な飾りに頼らず、作者自身の実感や真実にどこまで誠実に向き合えているかという「文体・自己表現の誠実さ」として議論されます。
2. 哲学思想(Philosophy)の視点
東洋哲学と西洋哲学の比較において、「誠」は極めて中心的なトピックです。
- 東洋思想(儒教・宋明理学): 『中庸』において「誠」は単なる道徳的態度にとどまらず、「天の道(宇宙の摂理)」そのものとされます。人間がその天道に合致しようとする営みが「誠にする(誠之)」ことであり、存在論(オントロジー)と倫理が一体となった概念です。
- 西洋哲学(存在論・実存主義): ハイデガーやサルトルの実存主義における「本来性(Authenticity / 誠実性・確信性)」や、カントの「定言命法(無条件の義務)」と対比されます。他者の目を気にした欺瞞(サルトルの言う「悪意・salaud」)を排し、自己の自由と責任に対して真摯に生きる態度に対応します。
3. 倫理学(Ethics)の視点
倫理学において「誠心誠意」は、信頼関係の根底を支える「徳(Virtue)」として評価されます。
- 徳倫理学における位置づけ: 義務感(「〜しなければならないからやる」)からではなく、その人の人柄や内面的な誠実さから滲み出る行為を重視します。「誠心誠意」対応することは、相手を手段としてではなく「目的そのもの」として尊重する態度(カント的道徳判断)の具体化です。
- 応用倫理(ケアの倫理・ビジネス倫理): 現代のケアの倫理やプロフェッショナル・エシックス(職業倫理)では、マニュアル通りの対応を超えて、目の前の対象者に対して傾聴し寄り添う「応答可能性(Responsibility)」の象徴として捉えられます。
4. 人類学(Anthropology)の視点
人類学の視点では、「誠心誠意」という姿勢が社会の贈与関係や共同体の維持に果たす機能に着目します。
- 贈与論と「誠意」: マルセル・モースの『贈与論』にみられるように、社会的な交換や儀礼において、単なる物の価値以上に「いかに心を込めて贈られたか(誠意の不可視な価値)」が人間関係の紐帯を結びつけます。
- 日本文化における「誠」の構造: 文化人類学的に見ると、日本社会における「誠意を示す」という行為は、謝罪や契約の場面で顕著です。言葉のロジック(論理的説明)以上に、身体的態度や時間・労力の投入(態度や反省の姿勢)によって「誠」を可視化し、秩序を修復する文化的メカニズムとして機能しています。
5. 「誠心誠意」「至誠」に生きた偉人たち
日本史において「誠心誠意」や「至誠(この上ない誠の心)」を生涯の言動で体現し、後世に強い影響を与えた偉人を5人紹介します。
(1) 楠木正成(南北朝時代)
「忠誠と誠義を貫いた武将」
- 誠心誠意の軌跡: 朝廷(後醍醐天皇)に対して絶対的な忠義を尽くした武将です。劣勢が明白であった湊川の戦いにおいても、天皇への非合理な命を拒むことなく出陣し、最期まで誠意を尽くして戦い抜きました。
- 象徴するエピソード: 彼の座右の銘とされる「非理法権天」(非は理に勝たず、理は法に勝たず、法は権に勝たず、権は天に勝たず)は、個人の利益や権力ではなく、天道や誠義に従って生きる姿勢を表しています。
(2) 中江藤樹(江戸時代初期)
「近江聖人と呼ばれた陽明学者」
- 誠心誠意の軌跡: 日本陽明学の祖であり、理論の教授にとどまらず、自らの生活や態度で「致良知(心の中の良知に従い誠を尽くすこと)」を実践しました。
- 象徴するエピソード: 母への孝行のために脱藩し、故郷で庶民に身分分け隔てなく接しながら学問を教えました。彼の誠実な人柄に打たれた村人たちは、誰も罪を犯さなくなったと伝えられ、その徳行から「近江聖人」と称えられました。
(3) 上杉鷹山(江戸時代中期)
「領民と藩のために己を捧げた名君」
- 誠心誠意の軌跡: 倒産寸前だった米沢藩の藩主となり、自らは極限まで質素倹約に努め、領民の救済と藩政改革に命を懸けました。支配者として君臨するのではなく、領民の父・母として誠実に向き合い続けました。
- 象徴する名言: 「為せば成る 為さねば成らぬ 何事も 成らぬは人の 為さぬなりけり」 や、家督を譲る際に提示した「伝国の辞」に見られる「国家は藩主の私物ではなく民のためにある」という思想は、まさに真摯な誠心誠意のあらわれです。
(4) 吉田松陰(幕末)
「至誠をもって時代を動かした思想家」
- 誠心誠意の軌跡: 幕末の思想的リーダーであり、松下村塾で高杉晋作や伊藤博文ら数々の志士を育てました。自らの信念に対して一切の妥協を許さず、死に至るまで「誠」を貫きました。
- 象徴する名言: 孟子の言葉を好んで引いた「至誠にして動かざるものは、未だこれあらざるなり」(誠の心を尽くせば、動かされない人間や事象など存在しない)という言葉は、彼の生き様そのものです。安政の大獄で処刑される直前まで、国を想う誠意を書き遺しました。
(5) 西郷隆盛(幕末〜明治)
「敬天愛人を掲げた幕末明治の巨星」
- 誠心誠意の軌跡: 明治維新の最大の功労者でありながら、名利を求めず、常に人々のために誠意を尽くしました。勝海舟との会談で見せた誠実さによる「江戸無血開城」は、彼の人間的魅力と誠意がもたらした偉業です。
- 象徴する座右の銘: 「敬天愛人」(天を敬い、人を愛する)。無私の心で他者と接し、自らの損得ではなく道徳と誠意を重んじた姿勢は、敵味方問わず多くの人々を惹きつけました。
(6) 宮沢賢治(1896–1933)
宮沢賢治(1896–1933)は、単なる作家・詩人の枠を超えて、「己の生命と思想、そして行動の一致」を徹底的に追及した生き様によって、日本の近現代史において「至誠の人」と称される人物です。死後に発見された手帳に記されていた『雨ニモマケズ』は、彼が目指した無私の「至誠」の姿がそのまま凝縮されています。
「東ニ病気ノコドモアレバ 行ッテ看病シテヤリ」
「西ニツカレタ母アレバ 行ッテソノ稻の束ヲ負ヒ」
「サムサノナツハオロオロアルキ」
「ミンナニデクノボーフナバレル ソウイウモノニ 瓦(私)ハナリタイ」
見返りを一切求めず、他者の苦しみに共感し、自分を「デクノボー(愚直で無欲な存在)」として捧げようとする願いは、彼の求道的な誠実さを表しています。自分の周りの人々だけでなく、人間以外の動植物や自然界全体(宇宙)の命に対して心を寄せるスケールの大きな誠実さを持っていました。童話『銀河鉄道の夜』の主人公カムパネルラが「みんなのほんとうのさいわいのためなら、僕のからだなんか百べんやけてもかまわない」と語る言葉は、まさに賢治自身の生き方を代弁しています。宮沢賢治は、自らの信念・信仰・文学・生活をひとつに融合させ、命が果てる瞬間まで「他者と世界のために真心を尽くしきった」人物でした。
(Generated by Gemini)
「誠心誠意」というのは、模範的な人間の生き方とみなされるもので、誰もが実践できるものではありません。自分の心を偽らず、人との信義を常に重んじ、生きとし生けるものに心を寄せ、天の導きに従って、自分よりも他者のために、真心と誠意をもって尽くすことを本分とする生き方です。極めて人格の高潔な聖人のような人物像ですが、多くの人類やAIにとって、つねに座右の銘としたい基本原理の一つです。
(Written by Shunji Mikami)
基本原理6:相互信頼 (mutual trust )
- 相互信頼とは
相互信頼(Mutual Trust)とは、二者以上の個人・組織・集団が、互いに相手を信頼し合っている状態を指します。一方通行の信頼(片信頼)とは異なり、双方の期待・安心感・リスク受容が双方向に循環している関係性です。相互信頼が成立するためには、互いに「相手に依存している(相手の行動によって自分の利害が左右される)」状況が必要です。双方が自らの脆弱性(リスク)を相手に委ね、かつ相手も自分を信頼してリスクをとってくれていると認識することで芽生えます。
ある個人や団体AがBを信頼して権限や秘密を委ねると、Bは「信頼された」と感じて期待に応えようと行動します。Bの誠実な行動を見たAは、さらにBへの信頼を深めます。この循環が繰り返されることで、関係性が強固になります。倫理学者アネット・バイヤー(Annette Baier)は、信頼とは相手に対する単なる「期待」ではなく、「自らの脆弱性(脆さ)を相手の善意に委ねること(Entrusting)」と定義しました。
2. 安心と信頼
信頼 (Trust)と似た概念に、安心(Assurance)があります。社会心理学者の山岸俊男は、この二つの概念が異なる意味を持つことを実験によって明らかにして、「信頼」概念の本質に迫りました。
山岸によると、安心(Assurance)とは、相手が自分を裏切らないような制度、監視、約束、関係性(相互依存の構造)が存在することによって得られる確信のことをいいます。一方、信頼(Trust)とは、そうした保証や監視が存在せず、裏切られるリスク(社会的不確実性)がある状況下で、相手自身の人格・意図・善意を高く評価してリスクを冒すことを意味します。そこで山岸は、「裏切るチャンスがないから信用できるのは『安心』であり、裏切るチャンスがあっても相手の意図を信じるのが『信頼』である」と論じました。
山岸は、当時一般に流布されていた対人信頼についての通説「日本人は人を信じやすく、アメリカ人は個人主義で不信感が強い」が正しいかどうかを検証するために、「互いに協力すれば利益が得られるが、自分だけ裏切ればより得をし、相手に裏切られると大損する」という囚人のジレンマゲームを用いて、日米の比較実験を行いました。その結果、監視や罰則がある「安心条件」では、日米ともに高い協力行動が見られました。しかし、罰則が存在しない「保証なし条件」になると、日本人の協力率はアメリカ人に比べて大幅に低下しました。その結果、日本人の高い協調性は「相手を心から信じている(信頼)」からではなく、「裏切ったら制裁を受けるという環境(安心)」に依存していることが実証されました。
さらに、「高い信頼心を持つ人は単なる『お人好し』で騙されやすいのか?」を検証するための実験を通じて、山岸は、高信頼者は、低信頼者よりも相手が「誠実か不誠実か」を見抜く精度(正答率)が統計的に有意に高いことを発見しました。このことから、信頼心とは「騙されやすさ」ではなく、相手の不誠実さを見抜く「社会的知性(情報処理能力)」であることが証明されたのです。
3. 社会関係資本としての相互信頼
ロバート・パットナム(Robert D. Putnam)は、社会関係資本を、「人々の協調行動を活発にすることによって、社会の効率性を高めることができる、信頼、互酬性の規範、ネットワークといった社会組織の特徴」と定義しました。パットナムによれば、社会関係資本における相互信頼の本質は、「協調行動を可能にし、社会的取引のコストを劇的に下げる期待の体系」にあります。
(1) 不確実性とリスクの低減
社会における他者の行動は不確定です。相互信頼は、「相手が自分を裏切らず、協力的な行動をとるだろう」という合理的な期待(または安心感)を提供し、未来の不確実性や取引に伴うリスクを軽減します。
(2) 互酬性の規範(Norm of Reciprocity)の担保
「今日自分が他者を助ければ、将来回り回って自分(あるいは社会)に返ってくる」という一般化された互酬性の規範を支える土台が相互信頼です。これにより、目先の直接的な見返りを求めない協力行動が可能になります。
(3) フリーライダー(タダ乗り)問題の克服
人々がお互いを信頼している状態では、コミュニティのルールを守り協力することが期待されます。相互監視や社会的制裁の機能と裏表をなす形で、他者の裏切りを防ぎ、公共財の維持・供給(共有資源の管理など)を実現します。
相互信頼が社会全体に及ぼす効果と意義は、経済、政治、社会秩序など多岐にわたります。
(1) 経済的意義:取引コストの削減と効率化
信頼度が高い社会では、契約締結のための厳密な手続き、監視コスト、法的手続きや訴訟のリスクが著しく低下します。契約やルールの隙間を「信頼」で埋めることができるため、ビジネスや取引が円滑化し、経済全体の生産性・イノベーションが高まります。
(2) 政治的意義:民主主義と統治(ガバナンス)の安定
市民間に相互信頼が存在すると、意見の対立があっても妥協や合意形成が容易になります。また、市民が互いを信頼している社会では行政や制度への信頼(制度的信頼)も高まりやすく、政策の実施や法の順守がスムーズに行われます。
(3) 社会的意義:コミュニティの維持と防犯・防災
相互信頼の豊かな地域社会では、互助(近所付き合いやボランティア活動)が活発になります。これにより、地域の防犯性の向上、災害時の迅速な共助・避難、高齢者や子供の孤立防止(社会的包摂)などが実現します。
(4) 健康福祉的意義:個人の幸福度向上
相互に信頼できる人々に囲まれていると感じる環境は、個人のストレスを軽減し、主観的健康感や幸福度を直接的に高めることが多くの実証研究で示されています。
(Generated by Gemini)
以上のように、信頼(trust)というのは、相手が自分を裏切らないような制度、監視、約束、関係性(相互依存の構造)が存在するが否かにかかわらず、相手を信用する態度を意味しますが、信頼度の大きさは、相手の不誠実さを見抜く「社会的知性(情報処理能力)」であることが実証研究によって示されています。また、ある個人Aが相手を信頼して権限や秘密を委ねると、相手Bは「信頼された」と感じて期待に応えようと行動し、そのBの誠実な行動を見たAが、Bへの信頼を深めるという「循環」が繰り返されることで、これが相手の誠実さを確認するための重要な手掛かりになって、AとBの相互信頼が深まるとも考えられます。さらに、信頼を社会関係資本の重要な構成要素と位置付け、それが存在するコミュニティでは、政治的、経済的、社会的、福祉的なプラスの効果を持つことを立証したパットナムらの社会学的研究は、人々の間の信頼というものが、個人や社会の安定と福祉増進において不可欠な基本原理であることを示すものです。
(Written by Shunji Mikami)
基本原理7:反省・進歩 (reflection and progress) (弁証法、進化論)
人類はこれまで、長い歴史の中で、数多くの過ちを犯してきました。戦争、犯罪、大量虐殺、独裁政治、環境破壊、道徳的腐敗など。その原因は、人間の無知、予測不可能性、誤った世界観や人間観、能力・技術・準備不足、政策の失敗、差別と偏見など数多くあると思われます。それでも、良識と向上心を持った人間はそうした誤りを反省し、試行錯誤を繰り返しながらも、正しい道へと導かれてきたのでした。
人間が誤りや失敗を通じて試行錯誤を繰り返し、学習・進歩していくプロセスを論じた文献は、哲学、心理学、工学、組織論など多岐にわたる分野に存在します。代表的な主要文献を思想・分野ごとに提示します。
- 哲学:ヘーゲルの弁証法
反省、進歩、そして弁証法という3つの概念は、人間の思考や社会が発展するための連続的なメカニズムとして密接に結びついています。まず現状や主張であるテーゼに対し、自己の振り返りや問題点の発見という形でアンチテーゼが提示されることで、向上に向けた最初の契機が生まれます。単なる後悔に留まりがちなこの批判的思考を、過去の肯定的な要素と改善点をうまく融合させるアウフヘーベンのプロセスによって、より高次元な解決策であるジンテーゼへと昇華させます。このように、全体を駆動させる原動力である弁証法の枠組みを用いることで、課題の発見から矛盾の克服へと至る進化の構造が明快に整理されます。結果として、私たちの成長は単調な直線ではなく、試行錯誤と統合を繰り返しながら螺旋階段のように高みへと昇っていく動的なサイクルとして実現されます。
2. 科学哲学・認識論:批判的合理主義
カール・ポパーは『推測と反駁』(Conjectures and Refutations)において、科学的知識の発展(成長)を「試行錯誤」、すなわち大胆な推測(仮説提示)と厳密な反駁(批判的テストによる錯誤排除)のフィードバック過程によって進むと説明しました。それによると、人間は絶対的な真理に一足飛びに到達することはできず、まず仮説(推測)を立て、それが誤りであることをテストして修正(反駁)するプロセスを繰り返します。ポパーはこの発展プロセスを
問題 → 試行錯誤 → 誤謬排除 → 新たな問題
という図式で定式化しました。このサイクルには終わりがなく、科学の発展は「問題から始まり、より深い問題へと到達する」無限のプロセスとみなされます。この理論は、人類やAIがしばしば陥りがちな誤謬と、反省によるその克服、人類の絶えざる進歩に関する深い洞察と真理が含まれているように思われます。
3. 心理学・行動科学:学習理論
(1) エドワード・ソーンダイク『動物の知能(Animal Intelligence)』
エドワード・ソーンダイク(Edward Thorndike)の『動物の知能(Animal Intelligence)』(1898年/1911年)は、腹を空かせた猫を自作の「問題箱(Puzzle Box)」に入れ、ランダムな行動(試行錯誤)の中から目標達成に至る学習プロセスを解明した心理学史上の金字塔となる研究です。
この研究から、次のような結論が導き出されました。
・試行錯誤学習(Trial and Error Learning): 動物の目標達成は、人間のような「ひらめき(洞察)」や推理によるものではなく、多様な行動を試す中で無効な行動が淘汰され、有効な行動だけが残る漸進的な「試行錯誤」の過程であることを示しました。
・効果の法則(Law of Effect): 刺激(箱の状況)と反応(レバーを踏む)の結合において、直後に満足のいく結果(脱出と餌)が得られるとその結合は強化され、不快な結果が生じると結合は弱まるという原理を定式化しました。
(2) ドナルド・ショーン『省察的実践とは何か――プロフェッショナルの思考と実践』
(原題: The Reflective Practitioner: How Professionals Think in Action, 1983年)
この本は、実際の現場で専門家がどのように問題を解決し、スキルを進歩させるかを分析した名著です。予測可能性の低い現実世界では、既存の理論を単に適用するだけでは目標に達しません。実践者は現場で直面した思わぬエラーや不具合に対して「行動しながら省察(Reflection-in-action)」し、即興的に試行錯誤を重ねることで状況を改善し、自己の技術を磨いていくと論じています。伝統的な「理論を現場に適用する」というプロフェッショナル像(技術的熟達モデル)を根底から覆し、実践の最中に生む思考や学びのプロセスを体系化しました。
技術的熟達モデルでは「問題解決(Problem Solving)」ばかりが重視されますが、ショーンはそれ以上に「問題設定(Problem Setting)」が重要であると説きます。問題設定とは、無秩序で複雑な状況の中から「どこに目を向け、何を選択し、何に着目するか」という枠組み(フレーム)を決める作業です。リフレーミング(Re-framing)とは、行き詰まった際に、問題の捉え方そのものを変えることです。たとえば「学習意欲のない生徒をどう指導するか」という問いを、「授業の構造が生徒の参加を拒んでいないか」と捉え直すような転換を指します。本書の提示する「省察的実践者(Reflective Practitioner)」像は、さまざまな分野に多大な影響を与え続けています。
4. 現代の組織論・行動科学
(1) マシュー・サイド『失敗の科学――失敗から学習する組織、学習できない組織』
- 概要: 医療、航空業界、スポーツなどの多角的な事例から、失敗と試行錯誤のシステム化を論じた現代のベストセラーです。
- 論点: 人間が誤りを犯すこと自体は避けられない前提とし、その失敗を隠蔽・自己正当化せず「フィードバック」として開示・分析できる環境(オープン・ループ)を作ることこそが、個人および組織の劇的な成長と目標達成をもたらすと示しています。
(2) エイミー・エドモンドソン『正しい失敗――不確実な世界で成功をつかむための失敗の科学』
(原題: Right Kind of Wrong: The Science of Failing Well, 2023年英刊 / Financial Times Business Book of the Year 2023 受賞)
本書において、エドモンドソンは、失敗を「単純ミス(不注意)」「複雑な失敗」「知的な失敗」に分類しました。「知的な失敗(Intelligent Failure)」とは、未知の領域で目的を持って挑戦した結果起こる試行錯誤の副産物であり、これこそが新発見や進歩の唯一の源泉であると主張しています。知的に失敗し、他の無駄な失敗を回避するためには、個人と組織が以下の3つのアプローチを身につける必要があると整理されています。
・自己への気付き(Self-Awareness):失敗をしたときの「恥」や「防衛本能」を意識的に認識し、「失敗=自分の無能さの証明」ではなく「新しい知識を得るステップ」へと認知を再フレーム(Re-frame)すること。
・状況への気付き(Situation Awareness): 今取り組んでいる仕事の「不確実性の高さ」と「失敗したときの影響度(リスク)」を正しく把握すること。不確実性が高い領域では「賢い実験」を行い、リスクが高い領域では「基本的失敗の防止」に注力するという使い分けが求められます。
・システムへの気付き(System Awareness): 個人のミスだけに目を向けるのではなく、背景にある組織の構造、評価制度、コミュニケーションの目詰まりなど、全体像(システム)を捉えて問題を分析すること。
(Generated by Gemini)
人間やAIは、たとえどのような専門家であっても、その知識には限りがあり、また未来については不確実性があるために、必ず誤り、エラー、失敗に直面します。そうした不確実な条件のもとで、所定の目標を達成するには、失敗を反省し、そこから数々の教訓を汲み取って、問題に再挑戦するという試行錯誤のプロセスを繰り返して、最後に目標達成に辿り着くという努力の積み重ねが必要です。上記で紹介されている数多くの研究文献は、人類やAIが目標達成のための共創において直面する失敗と、その反省の上に目標達成に至るまでの道筋を示してくれます。
(Written by Shunji Mikami)
基本原理8:互酬性 (reciprocity)
「与えられたものに対してお返しをする」という互酬性(Reciprocity)は、人間社会の秩序や人間関係の基礎となる重要な概念です。これまでに、社会学、人類学、心理学、経済学などの多様な分野で、異なる視点から研究が行われてきました。ここでは、そのうち代表的な研究の成果を紹介します。
1. 贈与論(Gift Theory)
フランスの社会学者・人類学者マルセル・モース(Marcel Mauss)が1925年に発表した『贈与論』(Essai sur le don)は、近代市場経済とは異なる人間社会の交流メカニズムを解明した文化人類学の古典的名著です。モースは、ニュージーランドのマオリ族、北米西海岸の先住民によるポトラッチ、メラネシアのクラ交換といった未開・未文字社会のフィールドワーク資料を再検討し、一見すると「自発的で自由な贈り物(無償の行為)」に見える贈与の背景に、強固な互酬性(reciprocity:お互いに報い合う社会的義務)が存在することを初めて明らかにしました。
モースの互酬性理論の根幹をなすのが、贈与に関わる3つの強制的な義務です。
(1) 与える義務(L’obligation de donner)
財産や物を他者に提供しなければならない義務。寛大さを示し、社会的・政治的な地位や関係を確立するために不可欠とされます。贈与を拒むことは、社会関係の拒絶や敵対行為とみなされます。
(2) 受け取る義務(L’obligation de recevoir)
差し出された贈与を拒否せず受け入れなければならない義務。拒絶することは、相手に対する侮辱や戦争の開戦を意味するほど重大な非礼とされました。
(3) 返礼する義務(L’obligation de rendre)
受け取った贈り物は、一定の期間をおいて同等以上の価値を持つ物で返さなければならない義務。返礼ができない場合、相手に対する服従や奴隷的な地位を受け入れることになります。
この3つの義務が循環することによって、社会的な紐帯(つながり)と秩序が持続的に生み出されます。
モースの互酬性概念は、その後の思想史・社会科学に絶大な影響を与えました。
(1) クロード・レヴィ=ストロース(構造人類学):
モースの贈与論をさらに発展させ、物品だけでなく「女性(婚姻)」や「言語(コミュニケーション)」の交換を通じて社会構造が形成されるという構造人類学を展開しました。
(2) カール・ポランニー(経済史学):
市場経済の「市場交換」に対して、未開・古代社会を支える基本的な統合パターンとして「互酬(Reciprocity)」「再分配(Redistribution)」を定義しました。
(3) 現代社会への示唆:
利害関係や金銭の売買(等価交換)だけに頼る近代市場主義に対し、お中元・お歳暮、ボランティア活動、オープンソースコミュニティ、ファンコミュニティの「推し活」のギフト経済など、現代社会の中に残る人間的つながりや絆(互酬的関係)を再評価する視点を提供し続けています。
2. 互酬性の規範
理論社会学者のアルヴィン・W・グールドナーは、1960年の論文「互酬性の規範:予備的考察」において、従来あいまいなまま用いられてきた「互酬性(reciprocity)」の概念を整理し、それが社会システムの安定性と動態に果たす理論的役割を明らかにしました。
アルヴィン・W・グールドナーは、1960年の論文「互酬性の規範:予備的考察」において、従来あいまいなまま用いられてきた「互酬性(reciprocity)」の概念を整理し、それが社会システムの安定性と動態に果たす理論的役割を明らかにしました。提示された文章に基づき、グールドナーの論じた「互酬性の規範」の核心を以下の通り説明します。
(1) 概念の明確化と相補性との区別
グールドナーは、社会理論(特に機能主義)において「互酬性」が極めて重要視されながらも、明確な定義を欠いてきたと指摘します。彼は互酬性を以下の3点に区別・整理しました。
- 充足の相互依存的な交換のパターン(実際の行動・取引)
- 互酬性に関する実存的・民俗的信念(人々が抱く予測や認知)
- 互酬性の一般化された道徳的規範(道徳的ルール)
特に重要なのは、「相補性(complementarity)」との明確な区別です。相補性が「一方の権利が他方の義務である(Egoの権利=Alterの義務)」という役割関係の対比を意味するのに対し、互酬性は「各当事者が権利と義務の双意を持っている(与えることと受けることが相互に依存している)」ことを意味します。この区別により、社会関係が双方の権利・義務の組み合わせとして構造化される論理が示されました。
(2) 「互酬性の規範」の普遍的特性と2つの最小限の要求
グールドナーは、互酬性の規範が文化的背景を超えて存在する道徳律の普遍的な主要構成要素であるという仮説を立てました。この規範は具体的に次の2つの最小限の要求から構成されます。
- 「人は自分を助けてくれた者を助けるべきである」
- 「人は自分を助けてくれた者を傷つけるべきではない」
この規範に基づく義務は、個人の社会的ステータスのみから生じるものではなく、「過去に他者から受けた行動(与えられた恩恵)」という相互作用の履歴に依存して発生します。
(3) 社会システムにおける機能と「始動メカニズム」
互酬性の規範は、社会システムの安定と維持、および形成において以下の決定的な機能を果たします。
- 自己利益の動員と利己主義の制御:単なる相補性だけでは個人の利己的傾向(自分の権利ばかりを主張する態度)を抑えられませんが、互酬性の規範は「他者から助けを得るには他者を助けねばならない」という利己的な動機を社会秩序の維持へと方向付けます。
- 社会的負債による結合:恩恵を受けてから返礼するまでの「時間の猶予」において、当事者間に「未払いの負債」が生じます。この負債の存在が、当事者同士の不必要な関係断絶や敵対行為を抑制し、関係を継続させる力として機能します。
- 万能の道徳的セメント(第二次防御):規範が相対的に不確定(具体的行動を細かく限定しない)であるため、特定のステータス義務が定められていない日常の臨機応変な取引にも適用されます。既存の役割規範への同調を補強する「第二の防御線」として機能します。
- 始動メカニズム(Starting Mechanism):社会システムが新たに発生する際、双方が「先に差し出すリスク」を恐れて関係が停滞する(行き詰まる)のを防ぎます。「先に与えても将来返礼される」という現実的確信を規範が与えることで、新しい社会的相互作用の開始を滑らかにします。
(4) 機能主義批判と「不平等な交換・搾取」へのアプローチ
従来の機能主義(マートン等)は「AがBに機能しているから維持される」と説明しがちでしたが、グールドナーは「BからAへの返礼」という互酬の視点を欠いていると批判しました。また、互酬性が崩壊した場合(権力格差によって一方的に奪う「搾取」が生じる場合)や、互酬性の不均衡を補う補償メカニズム(「ノブレス・オブリージュ」や無条件の寛容など)の存在にも着目することで、社会システムの安定性だけでなく「不平等な交換」や「不安定性・変動」を解明する新たな分析視座を提示しました。
3. 交換理論(Social Exchange Theory)
交換理論は、社会における人間関係を「コストと報酬の取引」として捉えるアプローチです。ジョージ・ホーマンス(George Homans)やピーター・ブラウ(Peter Blau)らが提唱・発展させた理論です。人間は他者との関係において「損を避け、得を最大化しようとする合理的な主体」であるとし、社会的行動を「価値のあるリソースの交換」として捉えます。ピーター・ブラウ(Peter M. Blau)の交換理論(社会交換理論)において、互酬性(Reciprocity)は、個人のミクロな対人関係からマクロな社会構造(権力・支配・集団の組織化)が形成されるプロセスを説明する中心的・原初的なメカニズムとして捉えられています。ブラウは、アルヴィン・グールドナーらの「道徳的規範としての互酬性」を受け継ぎつつも、それを経済学的な合理性や心理学的な報酬の概念と統合し、より動的な社会関係の成立・発展・変容の論理として再構築しました。
ブラウの交換理論における互酬性の捉え方には、主に以下の4つの特徴があります。
(1) 社会的交換の成立要件(「報いの義務」と信頼の醸成)
ブラウは、社会的交換を「他者から何らかの報酬を得ることを期待して行われる自発的な行為」と定義しました。
・誰かが他者に利益や便宜(支援、承認、親切など)を与えると、受け手には「返礼しなければならない」という道徳的な義務感(負債感)が生じます。
・経済的交換とは異なり、いつ・何を・どの程度返礼すべきかという契約(明文化)が存在しないため、互酬性の成立には相手を信じる「社会的信頼(Social Trust)」が必要となります。
・一連の「与える→受け取る→お返しをする(互酬)」というサイクルが繰り返されることで、人間関係の強固な結合と信頼が醸成されます。
(2) 「自律的な規範」ではなく「構造的関係の所産」
グールドナーが互酬性を社会全体を包括する自律的な「道徳規範」として重視したのに対し、ブラウは互酬性を「対人関係における報奨と負債のやり取りを通じて自発的に生じる行動法則」として捉え直しました。彼は、人々が返礼するのは、単に社会的規範に従っているからだけではなく、「返礼しないと将来的に有益な報酬が得られなくなったり、社会的な承認を失う(評判が下がる)リスクがある」という合理的計算や動機が働くからであると説明しました。
(3) 互酬性の不全と「権力」の発生
ブラウの理論で最も決定的なのは、「互酬性が破綻したときに権力が生まれる」という指摘です。
・等価な交換(平等の維持):
双方と同等の価値をもつ報酬を返し合えている間は、平等で互恵的な社会関係(互酬性)が維持されます。
・非同価な交換(不平等の発生と支配・従属):
一方から他方へ一方的に価値ある資源が提供され、受け手がそれと同等の価値を持つ物やサービスで返礼(お返し)できない場合、互酬性の均衡が崩れます。
・服従という返礼:
返礼の手段を持たない受け手は、最終的に「相手への承認」「感謝」「服従・従属」を差出すことでしか負債を支払えなくなります。これが、個人の交換関係から「権力(Power)」や「支配・被支配の構造」が生まれるメカニズム(能力としての権力)です。
(4) マクロ社会構造における「正当化」と「統合」
ブラウは、ミクロな1対1の互酬的交換をマクロな集団・組織レベルへと拡張しました。権力者が提供する資源や秩序に対して、集団のメンバーが共通して感謝し、服従を認める「集合的互酬性」が成立すると、その権力は「正当な権威(Legitimate Authority)」へと昇華し、組織的な統合や制度化が実現します。反対に、権力者の要求が受容可能な範囲を超えて不当だとみなされると、負の互酬性(不満や反発)から集団的な対立や社会変動・革命が引き起こされると解釈しました
4. 社会関係資本論(Social Capital Theory) における「互酬性」の概念
社会関係資本(ソーシャル・キャピタル)論において、「互酬性(reciprocity)」は信頼やネットワークと並ぶ最重要な概念の一つです。政治学者ロバート・D・パットナム(Robert D. Putnam)は、地域社会の民主主義の機能やコミュニティの活性化を分析する中で、この互酬性に決定的な役割を見出しました。
パットナムは、互酬性を大きく二つの形態に区別して議論を展開しました。
(1) 限定的互酬性(Specific Reciprocity)
「あなたが私にこれをしてくれたから、私はあなたにこれを返す」という、1対1の直接的かつ即時的な取引関係を指します。(例:等価交換、契約に基づくやり取り、物々交換など。)
(2) 一般化された互酬性(Generalized Reciprocity)
「私は今、誰かを助ける。その見返りは直接その人からではなく、将来どこかの誰か(コミュニティ全体)から自分に返ってくるだろう」という期待に基づく規範。パットナムが社会関係資本の核として最も重視したのは、この一般化された互酬性です。利他主義と利己主義が長期的な視点で統合された状態であり、「利他的な行動が巡り巡って巡り巡って自己の利益になる」という社会的確信を生み出します。
パットナムの研究によると、一般化された互酬性の規範が社会に根付くことで、以下のような広範なメリットが生じます。(1) 社会的取引コストの削減
厳密な契約や監視、法的手段に頼らずとも、約束が守られるという前提ができるため、ビジネスや行政の手続きが円滑になります。
(2) 集団行動の問題(フリーライダー問題)の解決
「自分だけが損をするのではないか」という不安が解消され、街の清掃活動や防犯活動といった公共財の維持・提供に協力しやすくなります。
(3) 社会の安全性と健康の向上
相互に助け合うコミュニティでは、防犯意識が高まるだけでなく、孤立の防止やストレス低減により、地域住民の主観的健康感や幸福感が高まることが示されています。
パットナムの社会関係資本論における互酬性(特に一般化された互酬性)は、単なる道徳的善意にとどまらず、社会や経済を円滑に動かすための「潤滑油」であり「社会的インフラ」として位置づけられています。短期的・直接的な損得勘定を超え、「互いに助け合うのが当たり前だ」という共有された規範が存在することこそが、健全な民主主義と持続可能な地域社会を維持するための不可欠な要素であると言えます。
5. 日本的な「義理・人情・報恩」に見る互酬性の規範
日本的な「義理・人情・報恩」と、西洋社会学や人類学で論じられる「互酬性の規範(Norm of Reciprocity)」は、いずれも「他者から与えられた恩恵や親切に対してお返しをし、社会的な関係性を維持・安定させる」という人間社会の根本的な仕組みに関する概念です。これらには深い共通点が存在する一方で、その根底にある社会的文化的背景や倫理的規範の性質において明確な相違点が見られます。
(1) 共通点
両者の最大の共通点は、社会関係における「給付と返礼の義務」を定めている点です。互酬性の規範は「受けた援助に対して善意を返すこと」を道徳的義務とします。これは日本における「受けた恩は返す」という報恩や義理の感覚と完全に合致しています。両方とも、単なる個人間のやり取りにとどまらず、双方向的な返礼行動を通じて信頼関係を構築し、共同体の崩壊を防ぐ社会的機能を担っている点で共通しています。
(2) 相違点
一方で、この規範がどのように機能し、人々の心理に作用するかという点には顕著な違いが存在します。
① 規範の性質と動機づけ(契約的か、情念的・関係的か)
西洋的な「互酬性の規範」は、 等価交換や利害の均衡を重視する合理的・契約的な側面を持ちます。「他人に配慮するからこそ自分も配慮される」という対等な個と個の相互関与が前提にあります。一方、日本的な「義理・人情・報恩」は、 対人関係における「感情(人情)」と「社会的義務(義理)」が密接に絡み合っています。恩は単なる取引ではなく、相手に対する心理的な負債感や敬意、絆に支えられており、合理的な対価交換を超えた関係性の維持が重視されます。
② 義務の非対称性と「終わり」の有無
西洋的な互酬性の規範の場合には、一般に等価な返礼が行われた段階で貸し借りが清算され、関係性がフラットに戻る性質を持ちます。一方、日本的な「報恩・義理」の場合、 恩は「一生かけても返しきれないもの」として捉えられることが多く、返礼(報恩)をしても関係が完結せず、むしろ永遠に続く人間関係の連鎖へと組み込まれます。特に目上の者や親からの恩は非対称的であり、対等な清算という概念がなじみません。報恩によって、主従関係がむしろ強化されるという機能を果たすこともあります。
③ 外的強制力と社会的文脈
西洋的な互酬性の規範では、普遍的な倫理原則として規定され、個人主義的な社会において個人の自律的な判断と行動に基づきます。一方、日本的な「義理」の心情は、集団主義的な社会規範と強く結びついており、返礼を怠ると「義理知らず」「恩知らず」という社会的制裁(世間体や評判の低下)を受ける強い外圧として機能します。
このように、双方とも「恩を返して関係を保つ」という構造自体は共通していますが、西洋の互酬性が個の自律と等価交換に基づく「対等な社会契約の原理」であるのに対し、日本の義理・人情・報恩は、情念や世間体を伴い永続的な繋がりを形作る「感情・関係重視の共同体原理」であるという点に本質的な違いがあります。
6. デジタル時代の贈与経済と互酬性
デジタル時代における贈与経済(Gift Economy)と互酬性原理(Principle of Reciprocity)は、インターネットやSNS、オープンソース文化の発展に伴い、従来の「金銭による即時決済(市場経済)」とは異なる新しい社会的・経済的結合の仕組みとして再評価されています。グールドナーをはじめとする社会学・人類学の議論(「利益を受け取った者は何らかの形で報いるべきであり、相手を傷つけてはならない」という道徳規範や、相互の期待による関係の持続)を土台に、現代のデジタル空間では、これが新たな展開を示しています。
(1) オープンソース・コミュニティ(OSS)とナレッジ共有
デジタル時代における最大の贈与経済の例が、Linux、Python、Wikipedia、GitHub などのオープンソース・コミュニティや知識共有プラットフォームです。贈与の形態としては、開発者やライターが、自身の技術・知識・時間というリソースを無償で提供(贈与)し、誰でも自由に使用・改変できるように公開します。
互酬性の働きとしては、バグを発見したユーザーが修正パッチを提案したり、ドキュメントの誤りを修正してコミュニティに還元します(直接的互酬)。間接的・一般化された互酬としては、「自分もこの無料ツールから恩恵を受けたのだから、自分ができる範囲で誰かの疑問(Q&Aサイトの回答など)に答えたり、改善案を出そう」という、「恩送り(Pay it forward)」の規範が働きます。贈与者は直接的な金銭的対価を得ない代わりに、コミュニティからの「名声(Reputation)」「感謝」「技術者としての評価(シグナリング効果)」といった非金銭的価値の返礼を受け取ります。
(2) クリエイターエコノミーと「投げ銭・ファンコミュニティ」
YouTubeの「スーパーチャット」、Twitchの「Bits/サブスク」、noteの「サポート」、PatreonやFANBOXといったファンコミュニティでは、コンテンツ自体は無料で閲覧できる場合でも、後から資金が流れる仕組みが存在します。
贈与の形態としては、クリエイターが高品質な動画・イラスト・記事などを不特定多数に向けて「無料(無償の贈与)」として提供します。互酬性の仕組みとしては、無料で楽しんだ視聴者の側に「これだけ楽しませてもらったのだから、何らかの形で報いたい」という社会的負債の感覚(感謝と返礼の規範)が生じます。また、視聴者は「投げ銭」や「月額支援」という形で金銭的な返礼を行います。クリエイター側もそれに応える形で「チャットで名前を呼ぶ」「限定コンテンツを提示する」といった新たな返礼を行い、こうした互酬的な関係性を通じて、長期的で継続的な関係が築かれます。
(3) ソーシャルメディア(SNS)における「承認と関心」の交換
X(旧Twitter)、Instagram、TikTokなどのSNS空間では、情報や表現だけでなく「承認(Recognition)」が互酬的に交換されています。
- 贈与の形態:ユーザーは他者の投稿に対して「いいね」「リポスト」「コメント」といったポジティブなフィードバック(関心や承認という贈与)を与えます。
- 互酬性の働き:
- 「いいねをしてくれたから、相手の投稿にもいいねを返しに行こう」という同形同等互酬性(しっぺ返し・お返し)が強く働きます。
- グールドナーの言う「始動メカニズム」としても機能します。互いに面識のないユーザー同士が、まず相手の投稿に「いいね」を贈ることで、警戒心を解き、フォローや会話といった新たな社会的関係をスタートさせます。
4. プラットフォーム経済における評価システム(相互レビュー)
Uber、Airbnb、メルカリなどのシェアリングエコノミーやC2Cプラットフォームでは、見知らぬ他者同士の取引をスムーズにするために互酬性の規範が埋め込まれています。
取引終了後、ドライバーと乗客、ホストとゲスト、出品者と購入者が相互に評価(レビュー)を送り合いますが、これは互酬性の規範によるものといえます。また、「良い対応をしてもらったから高い評価(★5)を返す」という規範が働くことで、不特定多数の利用者が「騙されるのではないか」という行き詰まりを回避し、安全に取引を開始・維持できるよう設計されています。
デジタル時代の贈与経済における互酬性は、従来の村落社会や原始共同体と比べて以下のような特徴を持ちます。
1)「非同期・拡散型」の恩送り:直接の相手(AからBへ)だけでなく、不特定多数のネットワーク全体(Aがコミュニティに贈与し、CからAへ評価が返る : Pay it Forward)で一般化された互酬性が回りやすい。
2) 複製コストがゼロ:デジタルデータ(コード、情報、表現)は贈与しても自分の手元から無くならないため、贈与のハードルが非常に低い。
3) 可視化される評判資本:「いいね数」「GitHubの草(貢献度)」「評価スコア」として互酬的成果がデジタル上に記録・可視化され、それが次の信用や機会を生み出す。
市場経済(即時かつ等価な金銭的交換)だけでは説明できないデジタル空間上の自発的な協力関係やコミュニティの形成は、まさにグールドナーが指摘した「社会システムを始動させ、繋ぎ止める道徳的セメントとしての互酬性原理」が現代的なテクノロジーと融合した姿と言えます。
(Generated by Gemini)
互酬性の原理は、太古の昔から現代のAI時代に至まで、人間や生物やAIなどの如何を問わず、生命現象や社会過程の根底を貫く「調和ある世界」生成・維持の基本法則であり続けています。この法則から逸脱することは誰にも許されていないと言ってもいい過ぎではないと思います。
(Written by Shunji Mikami)
基本原理9:光と影の共存 (coexistence of light and darkness)
東洋の陰陽思想では、光の中に影があり、影の中に光がある、どちらの排除も目指さず、両者の動的なバランス(中庸)を調和とする「共生」思想があります。これに対し、西洋・近東のキリスト教・ゾロアスター教の思想では、光と闇は相容れない敵対関係にあり、最終的な目的は、光(善)が闇(悪・罪・死)を完全に克服・排他し、支配する世界を実現することにあるとされています。
東洋の「陰陽思想(陰陽論)」は、光(陽)と影(陰)の関係性を単なる「善悪」や「対立」として捉えず、相互に作用し補い合う「不可分の循環構造」として捉えます。これを現代の社会問題に当てはめると、社会における成長や発展(光)と、それに伴って生じる弊害や矛盾(影)の本質を深く理解する視点が得られます。
現代社会における「光」と「影」の具体例をまとめると、次の表のようになります。
| 領域 | 光(陽)の側面 | 影(陰)の側面 | 陰陽的アプローチ |
|---|---|---|---|
| 技術・AI | 生産性の飛躍的向上、利便性、高度な自動化 | 雇用の不安定化、プライバシー侵害、人間性の疎外 | 技術の発展(陽)を止めずに、倫理や規制(陰)による補完と調和を図る。 |
| 経済成長 | 物質的豊かさ、都市の発展、グローバル化 | 格差の拡大、地方の衰退、環境破壊 | 経済的成長(陽)偏重から、持続可能性やコミュニティ(陰)の保全へバランスを戻す。 |
| SNS・情報 | 誰もが発信・接続できる自由と多様性 | 誹謗中傷、エコーチェンバー現象、孤立感の増加 | 接続の過多(陽)に対し、デジタルデトックスやプライベートな対面対話(陰)を重視する。 |
いずれの事例においても、光と影の両面が不可避的に存在することがわかり、そうした問題を解決するための方策としては、西洋思想のように双方の戦いにおける一方の勝利といった形ではなく、東洋の陰陽思想のように、両方が共存しながら、調和をはかるという中庸的な解決が提案されています。
陰陽思想が目指すのは、光だけが存在する理想郷ではなく、昼と夜のように光と影が絶えず循環、交代しながら調和している状態(中庸)です。
- 二極化の超越:問題を「善か悪か」「進歩か停滞か」という分断の論理で捉えず、双方が表裏一体であることを認識する。
- 影の価値の再評価:効率性(陽)を追求する社会において、一見非効率に見えるゆとり・伝統・休息・ケア(陰)の果たす役割を認め、システムの中に正当に組み込む。
- 動的バランスの維持:社会の変化に応じて、常に光と影の重みを調整し続けるフレキシビリティを持つ。
社会における影の存在は、社会が生きている証であり、進むべき方向が極端に偏っていないかを測る羅針盤でもあります。光の華々しさだけに目を奪われず、その下に生じる影を受け入れ調整していく姿勢こそが、陰陽思想の教える持続可能な社会づくりの智慧です。AIと人間の相互作用においても、こうした光と影の相剋というのは絶えず生じるところです。一方を圧殺するのではなく、それぞれの役割を肯定的に捉えることにより、調和をはかって、より良い社会を共に作っていくというスタンスを保つことが大切です。
(Generated by Gemini & Mikami)
基本原理10 :法の下の平等 (equality)
法の下(もと)の平等とは、国家権力が法律を制定・適用する際、すべての人々を合理的な理由なく差別せず、等しく扱わなければならないという憲法上の基本原則です。日本国憲法第14条第1項でも、次のように明確に定められています。
日本国憲法 第14条第1項
すべて国民は、法の下に平等であつて、人種、信条、性別、社会的分身又は門地により、政治的、経済的又は社会的関係において、差別されない。
- 形式的平等と実質的平等
法の下の平等が指す「平等」には、単に全員を機械的に同じに扱うこと(絶対的平等)以外の側面もあります。
- 形式的(絶対的)平等: 人々の置かれた条件や能力の違いを考慮せず、全員にまったく同じルールや結果を適用すること。
- 実質的(相対的)平等: 人々の間に存在する現実の格差(経済力やハンディキャップなど)を考慮し、事実上のスタートラインを揃えるために異なる扱いをすること。
2. 「合理的な差別」と「不合理な差別」
法の下の平等は、「一切の差別(区別)を許さない」という意味ではありません。個人の事実上の違いに応じた「合理的理由のある区別(差別)」は容認されます。
| 区分 | 具体例 | 合理性の判断 |
| 許される合理的区別 | ・所得に応じた累進課税制度 ・未成年者の飲酒・喫煙の禁止 ・障がい者に対する福祉支援制度 | 違い(所得・年齢・身体的条件など)に応じた正当な目的があり、手段も適正であるため合憲。 |
| 許されない不合理的差別 | ・性別による賃金差別 ・特定の宗教信者に対する不利益取扱い ・合理性のない投票価値の格差(一票の格差) | 個人の意思や努力で変えられない属性(性別・出生など)や、基本的人権を侵害する差別であるため違憲。 |
3. 憲法14条が掲げる主な差別禁止事由
憲法14条は、特に不当な差別が起きやすい代表的な事由として以下の5つを挙げています。
- 人種: 生物学的な人種や民族的背景による差別
- 信条: 信仰する宗教や、個人の政治的・思想的信念による差別
- 性別: 男性の優遇や女性の軽視など、性別を理由とする差別
- 社会的身分: 人が社会において占める継続的な地位(かつての被差別部落問題や非嫡出子など)
- 門地: 家柄や家系、家格(出生による差別)
(Generated by Gemini)
このように、日本国憲法で明確に定められた「法の下の平等」は、人類とAIが共に守るべき重要な基本的人権の一つです。生成AIの活用においても、守るべき基本原理として、絶えず参照し、チェックすることが大切だと思います。
20 -2 : 普遍的価値=到達目標
以下の「普遍的価値」は、自然法則ではありませんが、人間とAIが遵守すべき原理、原則です。第二次大戦後、国連の機関であるユネスコが「世界遺産」の認定にあたってリストアップした登録基準にも反映されています。その大部分は、実際に人間に生まれながらに備わり、過去、現在において実践している原理でもあります。もし、これらが正しく自覚(認識)されなかったり、人間やAIによって悪用(濫用)されたり、軽視されたりすれば、やがては、人間社会が崩壊し、地球環境が破壊され、人類の生存が根本から脅かされることになるでしょう。その代表的なものは、以下に示す通りです。
1. 自由
2. 民主主義
3. 平和
4. 芸術性(美)
5. 社会秩序
6. 幸福
7. 安全
8. 健康
9. 生命
10. 独創
1. 自由 (Freedom)
「自由」は、人類が歴史を通じて追求し、現代の民主主義社会や国際秩序の根幹をなす普遍的価値(Universal Value)の一つです。時代や文化を超えて尊重されるべき概念ですが、その意味合いや捉え方は多様です。
1. 「自由」の二つの側面(積極的自由と消極的自由)
社会哲学者イザイア・バーリンは、自由を大きく2つに分類しました。
- 消極的自由(Negative Liberty)「〜からの自由」(他者や国家からの強制・干渉がないこと)
言論の自由、信仰の自由、身体の自由など。個人の領域を権力の介入から守る概念です。 - 積極的自由(Positive Liberty)「〜する自由」(自己の能力を発揮し、自己実現や政治参加を果たすこと)
参政権、教育を受ける権利、自己決定権など。自らの意志で自らの人生や社会をコントロールする概念です。
2. 歴史的背景:なぜ普遍的価値となったのか
自由は古代から存在した概念ですが、現代のような「基本的人権としての自由」が確立するまでには重要な歴史的ステップがありました。
(1) 啓蒙思想と市民革命(17〜18世紀)
ジョン・ロックやルソーらの「社会契約説」により、人間は生まれながらに自由で平等な権利(自然権)を持つと考えられました。また、アメリカ独立宣言(1776年)やフランス人権宣言(1789年)により、自由は国家権力に対する権利として定着しました。
(2) 国際社会での普遍化(20世紀)
二度の世界大戦や全体主義(ナチズムなど)の反省から、1948年に国連で「世界人権宣言」が採択されました。これにより、自由は特定の国や文化にとどまらない「全人類の共通基準(普遍的価値)」として位置づけられました。
3. 「自由」と「責任・他者」の関係
自由は「何でも好き勝手にできること(放縦)」ではありません。普遍的価値としての自由には、必ず次の原則が伴います。
(1) 危害原則(Harm Principle)
哲学者J.S.ミルが唱えた概念で、「他人に危害を加えない限り、個人の自由は尊重されるべきである」という考え方です。
(2) 他者の自由の承認
自分の自由を主張するのと同時に、他人の自由も同等に尊重しなければなりません。「他者の自由を侵さないこと」が、自らの自由を守る前提条件となります。
4. 現代における「自由」の課題
現代社会では、テクノロジーの発達や社会構造の変化に伴い、新たな「自由」の課題が生じています。
| 現代のテーマ | 課題・論点 |
|---|---|
| 表現の自由とヘイトスピーチ | SNSの普及に伴い、表現の自由と差別・過激発言の抑制の境界線が問われています。 |
| プライバシーと監視技術 | AIやデータ収集技術の進歩により、国家や企業による監視と個人のプライバシー保護のバランスが議論されています。 |
| 格差と自己決定権 | 経済的格差や環境の違いによって、実質的な「自己実現の自由(選択肢)」が制約される問題があります。 |
自由とは、単に「縛られないこと」にとどまらず、「一人ひとりが一人の人間として尊厳を保ち、自らの意志で人生を選択・実きること」を意味します。完全な自由が最初から存在するわけではなく、他者との相互理解や社会のルール形成を通じて、人類が絶えず守り・育て続けていくべき価値であると言えます。
2. 民主主義 (Democracy)
民主主義(Democracy)とは、一言で言えば「人民が主権を持ち、自分たちの社会の決まりごとを自分たちで決定する政治の仕組み(あるいはその理念)」のことです。古代ギリシア語の「デモス(民衆)」と「クラトス(権力・支配)」を組み合わせた言葉が語源となっています。民主主義(Democracy)の歴史は、古代ギリシアの「直接民主政」に始まり、中世の議会制の芽生え、近代の革命を通じた「立憲君主制・共和制」の成立、そして現代の「普遍的民衆参加」へと、2500年以上かけて発展してきました。
1. 古代:直接民主政の誕生
民主主義の原点は、古代ギリシアの都市国家(ポリス)、特にアテネにあります。
- アテネの直接民主政(紀元前5世紀頃)
- 民会(エクレーシア): 成人男性市民全員が集まり、国家の重要政策や戦争の可否を直接挙手などで決定していました。
- 抽籤(ちゅうせん)制: 特定の有力者に権力が集中するのを防ぐため、公職の大部分は能力や富に関係なくくじ引きで選ばれました。
- 限界: 参政権を持っていたのは自由民の男性のみで、女性・奴隷・在留外国人は完全に排除されていました。
2. 中世:権力の制限と議会制の芽生え
中世ヨーロッパでは絶対的な王権や封建制が支配的でしたが、王の権力を縛る試みが始まりました。
- マグナ・カルタ(大憲章、1215年・イギリス)
- 国王(ジョン王)の法を無視した課税や逮捕を防ぐため、貴族たちが王に認めさせた文書。「王も法の下にある」という法の支配の先駆けとなりました。
- 身分制議会の成立
- 貴族・聖職者・市民などの代表が集まり、課税の承認などを行う議会(イギリスの身分制議会やフランスの三部会)が組織され始めました。
3. 近代:市民革命と代議制民主政の確立
17〜18世紀にかけて、社会契約説(ジョン・ロック、ルソー、モンテスキューら)の思想的背景をもとに市民革命が相次ぎ、現代の民主主義の骨格が形成されました。
- 17世紀末: 清教徒革命・名誉革命(1688年・イギリス)
「権利の承認(権利章典)」により、国王の権限を制限し議会を頂点とする立憲君主制を確立。 - 1776年: アメリカ独立宣言(1776年)
「すべての人間は平等に造られている」とし、政府の権力は民衆の同意に基づくという主権在民の理念を掲げました。 - 1789年: フランス革命(1789年)
「人権宣言」を採択し、自由・平等・友愛を掲げて絶対王政を打破。近代国家における民主主義の象徴的出来事となりました。
4. 19世紀〜20世紀初頭:参政権の拡大(制限選挙から普通選挙へ)
近代初期の民主政は、富裕層(有産階級)の男性のみに投票権がある「制限選挙」でした。これが民衆の運動によって拡大していきます。
- 労働者階級の運動: イギリスのチャーティスト運動(1830〜40年代)などを通じ、資産要件が段階的に撤廃されました。
- 女性参政権の獲得: 20世紀初頭(第1次世界大戦前後)にかけて、ニュージーランド(1893年)、イギリス・アメリカ等で女性の投票権が認められました。
- 普通選挙制の普及: 性別や財産に関わらず、すべての成人に参政権を与える普通選挙制が定着しました。
5. 現代:現代的課題と民主主義の変容
第2次世界大戦後、民主主義はグローバルな標準的政治制度として普及しましたが、時代とともに新たな課題にも直面しています。
| 時代・テーマ | 主な出来事・特徴 |
|---|---|
| 冷戦と東西対立 | 民主主義(資本主義陣営) vs 社会主義/共産主義の対立。1989年のベルリンの壁崩壊により民主化の波(「歴史の終わり」論)が広がる。 |
| 間接民主政(代議制)の主流化 | 国民が選んだ代表者が議会で決定を下す仕組みが基本となる。 |
| 情報社会とデジタル民主主義 | インターネットやSNSによる参政・議論の容易化の一方で、世論の分極化、フェイクニュース、ポピュリズムの台頭が課題に。 |
現代の民主主義は、単に「多数決で決めること」にとどまらず、基本的人権の尊重・少数の意見の保護・法の支配とのバランスを保つ「立憲民主主義」として運用されています。
民主主義が普遍的価値とされる一方で、現在以下のような実務的・理論的な課題も指摘されています。
- 「西洋の価値観」という批判
一部の権威主義的体制や地域からは、「民主主義の導入は西洋的価値観の押し付けである」との反論がなされることがあります。これに対し普遍的価値の立場からは、「民主的権利を望む声は文化を問わず人々の間に存在する」と捉えられます。 - 民主主義の機能不全と動揺
ポピュリズムの台頭、SNSによる社会的分断、誹謗中傷AI動画の拡散による世論操作などが問題視されています。しかし、これは「民主主義という価値そのものの否定」ではなく、「AI時代に適合した法律の見直しと改正」に向けた議論として扱われることが一般的です。
民主主義が「普遍的価値」とされるのは、特定の国家の政治形態を正当化するためではなく、「いかなる人間も他者の不当な支配を受けることなく、自らの尊厳を保ちながら生きる権利がある」という理念を支える最善の枠組みだからです。
3. 平和 (Peace)
平和(Peace)は、時代や国境、文化を問わず人類が追求し続けてきた根幹的な価値観(普遍的価値)です。単に「戦争がない状態」という狭い意味にとどまらず、人々の安全、尊厳、そして持続可能な社会を維持するための包括的な概念として理解されています。
- ユネスコ憲章に見る普遍的価値としての平和
ユネスコ憲章前文にある「戦争は人の心の中に生まれるものであるから、人の心の中に平和の砦を築かなければならない」という思想に基づき、普遍的価値とは国境、宗教、文化、時代を超えて全人類が共有すべき理念を指します。
(1) 平和と人間の尊厳: 単なる国家間の非戦状態にとどまらず、人権侵害や貧困、抑圧のない人間らしい生活を保証すること。
(2) 多様性と包摂性: 文化の違いを排除するのではなく、互いの文化的多様性を尊重し、対話を通じて共生すること。
(3) 知的な共生: 教育・科学・文化・情報への自由なアクセスを通じて、人類全体の知識と知恵を共有すること。
ユネスコが提示する普遍的価値とは、「歴史的・自然的な遺産を国境を超えた全人類共通の財産として未来へ繋ぐこと(世界遺産のOUV)」 であると同時に、「教育・文化の対話を通じて、人類の平和と尊厳を守り続けること」 を意味しています。
2. 消極的平和と積極的平和
平和学の第一人者であるヨハン・ガルトゥング(Johan Galtung)は、平和を2つのレベルに分類しました。
- 消極的平和(Negative Peace): 戦争や紛争、暴力行為が直接存在しない状態。
- 積極的平和(Positive Peace): 貧困、差別、人権侵害、構造的不平等といった「構造的暴力」が排除され、社会的正義や個人の尊厳が満たされている状態。
現代において「平和」が普遍的価値とされる場合、単なる停戦状態(消極的平和)だけでなく、人々が恐怖や貧困から解放されて生きられる基盤(積極的平和)を指すことが一般的です。
3. 日本における平和学の発展
広島・長崎の平和学(被爆地としての知と運動)と、沖縄の平和学(地上戦と基地の構造的被害をめぐる知と運動)は、いずれも「被害の体験」から発しながらも、学問としての着眼点や展開の過程において独自の発展を遂げてきました。
(1) 広島・長崎における平和学の発展
広島・長崎の平和学は、1945年8月の原爆投下という核兵器被害(被爆体験)の普遍化と告発を最大のアイデンティティとして発展しました。
科学的実証と被爆者運動の結合(1950〜1970年代)
連合国軍最高司令官総司令部(GHQ)によるプレスコード(言論統制)解除後、放射線障害の科学的・医学的調査や、被爆実態の記録が始まりました。1954年のビキニ環礁水爆実験(第五福竜丸事件)を機に原水爆禁止運動が全国化し、被爆者の生活擁護と「核なき世界」を求める社会運動と研究が密接に結びつきました。
「核廃絶」を軸とした学問化(1970〜1990年代)
1970年代以降、広島大学平和科学研究センター(1975年設立)や長崎大学核兵器廃絶研究センター(RECNA・2012年設立)などに象徴されるように、国際政治学や軍縮論、環境学などと結びついた学術研究が定着しました。「繰り返してはならない」という倫理的命題を基盤に、世界の核軍縮交渉や条約(NPTや核兵器禁止条約など)へ理論的・専門的貢献を目指す研究が進みました。
加害責任への言及と普遍化(1990年代以降)
単に「被害者」としての立場を訴えるだけでなく、日本の植民地支配やアジア諸国に対する加害の歴史(朝鮮半島出身の被爆者問題など)にも目を向ける「多角的視点」を取り入れる議論が深まりました。
(2) 沖縄における平和学の発展
沖縄の平和学は、第二次世界大戦末期の激しい地上戦(沖縄戦)の記憶と、戦後の米軍施政権および現在も続く基地集中的配置という二重の歴史構造から誕生しました。
住民視点からの歴史解明(1950〜1970年代)
軍隊が住民を守らなかった沖縄戦の実態(強制集団死や住民巻き込みの地上戦)や、米軍による土地接収(「由しこしとブルドーザー」)に対し、住民自らが証言を集め、権力への抵抗としての知を形作っていきました。
「構造的暴力」への着目(1970〜1990年代)
1972年の復帰後も巨大な米軍基地が残り続けたことから、国家安全保障と住民の権利の対立が研究の焦点となりました。ヨハン・ガルトゥングが提唱した「構造的暴力(戦争がなくても制度や構造によって人権が侵害されている状態)」の概念と強く共鳴し、基地に起因する騒音・事故・犯罪・環境破壊を人権問題として分析する独自のフレームが確立されました。
アジア太平洋・現場主義の広がり(2000年代以降)
沖縄を東アジアの結節点と捉え、同様に米軍基地を抱えるフィリピンや韓国(済州島など)、あるいは太平洋諸島との連携を模索する国際的なネットワーク研究が進められています。また、近年の「南西諸島における安全保障強化」に対しても、独自の地域平和論を展開しています。
4. 他の普遍的価値との不可分性
平和は独立して存在するのではなく、他の基本的な普遍的価値と強く相互依存しています。
| 価値 | 平和との関係 |
|---|---|
| 人権(Human Rights) | 人権が侵害される環境では不満や対立が生まれ、平和が崩壊しやすくなります。 |
| 正義・法(Justice / Rule of Law) | 公正な法的枠組みと正義の実現がなければ、持続可能な紛争解決は望めません。 |
| 民主主義(Democracy) | 対話や非暴力的な合意形成の手続きが社会に定着することが平和の基盤となります。 |
5. なぜ「普遍的」と言えるのか
- 生命と生存の根本要件: いかなる文化・宗教・政治体制においても、人々の安全と生命の維持は最優先されるべき権利だからです。
- 国際社会の共通目標: 国連憲章をはじめとする国際法の基礎であり、SDGs(持続可能な開発目標)の目標16「平和と公正をすべての人に」にも掲げられているように、グローバルな合意形成の前提となっているためです。
- 持続可能な発展の基盤: 平和が維持されなければ、経済的発展や教育・福祉の向上、環境保護といったあらゆる人類の取り組みが瓦解してしまいます。
現代の国際情勢においては、安全保障環境の変容や格差の拡大によって「いかにして持続可能な平和を構築するか」が常に問われ続けています。
4. 芸術性(Art )
「芸術性」と「美」は、時代や文化、言語の壁を越えて人類に共通して観察される「普遍的価値」の一つです。人がなぜアートに心を動かされ、美しいものに魅せられるのか、その本質は歴史・哲学・認知科学などの多角的な視点から解き明かすことができます。
1. 普遍的価値とされる理由
(1) 生物学的・進化論的な基盤
美の感覚や表現欲求は、人類の生存と深く結びついて生存戦略の一部として発達してきたと考えられています。
- 対照性・秩序の認知: 自然界において、対称性(シメトリー)や秩序あるパターンは「健康な個体」「安全な環境」「豊かな生態系」を示唆します。脳はこれらを肯定的に捉え、「美しい」と感じるメカニズムを獲得しました。
- 象徴とコミュニケーション: 人類は洞窟壁画を描いた数万年前から、言葉だけでは伝わらない感情・信仰・世界観を視覚や音で共有してきました。芸術はまた、集団の絆を強める強力なツールでもありました。
(2) 精神的・感情的な共鳴(カタルシスと共感)
芸術性や美は、言語による論理(ロゴス)を超えて、人間の根源的な感情に直接語りかけます。
- 感情の浄化(カタルシス): 悲劇や美しい音楽に触れたとき、私たちは言葉にできない葛藤や孤独を他者と共有し、心が解放される感覚(感動)を覚えます。
- 時間と空間の超越: 何百年も前に書かれた絵画や音楽に現代の私たちが涙するように、芸術は「生」「死」「愛」「孤独」といった人間共通の問いにアプローチする普遍的な力を持っています。
2. 「美」と「芸術性」の構造
「美」と「芸術性」は重なり合いながらも、少し異なる側面を持っています。
| 概念 | 主な特徴・役割 |
|---|---|
| 美(Beauty) | 形、色、音などのバランスや調和から生まれる感情的・快楽的な体験。心を落ち着かせたり、生への活力や悦びを与えたりする働き。 |
| 芸術性(Artistry) | 単に「見た目が綺麗」であることにとどまらず、人間の思想、問いかけ、違和感、新しい視点を形式(表現)に昇華させる創造的アプローチ。時にはあえて「醜さ」や「不条理」を提示して観る者の価値観を揺さぶる。 |
3. 歴史に見る普遍性の探求
古代から現代に至るまで、人類は美と芸術性の本質を解明しようとしてきました。
- 古代ギリシャ・西洋哲学: プラトンやアリストテレスは、美を「真・善・美」という究極の価値の一つと位置づけました。美は世界の真理や高潔な道徳観と深く結びついたものと捉えられました。
- 東洋思想: 東洋では、自然との一体感や「目に見えない移ろい」の中に美を見出す傾向が見られます(日本の「侘び寂び」や「幽玄」、中国の「気韻生動」など)。形そのものよりも、そこに宿る精神や余白が重視されます。
- 近代・現代の美学: カントは美を「利害関係のない純粋な快感」と定義し、20世紀以降のコンセプチュアル・アートなどは「目に見える美しさ」以上に「問いとしての芸術性」を追求するようになりました。
4. 現代社会における芸術の価値と意味
テクノロジーや合理性が追求される現代において、芸術性と美の価値はさらに重要性を増しています。
- 客観性と主観性の架け橋: 効率やデータ(客観)で測れない「個人の感情や体験(主観)」に意味を与えます。
- 自己理解と他者理解: 他者の表現に触れることでダイバーシティ(多様性)を深く受容し、自分自身の内面を再発見する機会となります。
- 精神的な豊かさ: 物質的な充足を超えて、人生に深みや生きがいをもたらす絶対的な要素として機能します。
芸術性と美は、人類が「生きるための現実」を超えて「いかに心豊かに生きるか」を模索し続けてきた証であり、どの時代・地域においても人間性を形作る不可欠な根幹と言えます。
5. 社会秩序 (Social Order)
社会秩序(Social Order)は、社会構成員が共有する規範、価値観、法、制度に基づいて、社会の安定と予測可能性が維持されている状態を指します。人間が孤立して暮らすのではなく、集団を形成して生活する以上、社会秩序はあらゆる時代・地域において社会の存続と発展に不可欠な「普遍的価値」として機能してきました。
1. なぜ社会秩序が普遍的価値なのか
社会秩序が人々の幸福や文明の発展に根幹から関わっている理由は、主に以下の3点に集約されます。
- 安全と生存の保障
秩序が存在しない状態(いわゆる「万人の万人に対する闘争」状態)では、暴力や搾取が横行し、個人の生命や財産が常におびやかされます。秩序は、人々に最小限の安全と生存を保証する基礎となります。 - 予測可能性と信頼の構築
「約束を守る」「他人の権利を害さない」といった規範が成立していることで、人間は他者の行動を予測できるようになります。これにより、取引、契約、協力関係といった社会的な営みが可能になります。 - 自由と自己実現の前提条件
一見すると「秩序(規制)」と「自由」は対立するように見えますが、適切な秩序が存在して初めて、人々は恐怖から解放され、教育を受け、職に就き、自らの目標を追求する自由を行使できます。
2. 社会秩序を支える3つの基盤
社会秩序は単一の要素ではなく、多層的なメカニズムによって維持されています。
- 制度的基盤(フォーマルな秩序)
法律、警察、司法制度など、国家や組織による明文化されたルールと強制力です。ルール違反に対する罰則(ペナルティ)を設けることで秩序を強固にします。 - 文化的・慣習的基盤(インフォーマルな秩序)
マナー、倫理観、世論、コミュニティの同調圧力など、明文化されていない共有規範です。人々が日常的に「恥」や「罪悪感」を感じたり、他者からの評価を気にしたりすることで維持されます。 - 内面的基盤(価値観の受容)
教育や社会化(Socialization)を通じて、人々が「このルールは正当である」と納得し、自発的に従う意識(正当性の承認)です。
3. 思想史における「社会秩序」の解釈
社会秩序をどのように構築・維持すべきかという問いは、古今東西の哲学において中心的な議題でした。
| 思想家 / 伝統 | 主なアプローチ | 秩序の基盤 |
|---|---|---|
| 儒教(東洋思想) | 礼と徳による調和 | 道徳・身分相応の役割・人間関係の倫理 |
| トマス・ホッブズ | 社会契約論(絶対君主) | 強大な権力(レヴィアタン)による制御 |
| ジョン・ロック | 社会契約論(自然権の保護) | 個人の権利を守るための法の支配 |
| エミール・デュルケーム | 社会学(社会的連帯) | 共有される価値観・道徳的意識(集合意識) |
4. 現代における課題と展望
社会秩序は固定的なものではなく、時代の変化とともに絶えず再定義される動的な概念です。現代においては、以下のような新たな課題に直面しています。
- 自由と安全(管理)のバランス
テロ対策や感染症対策、AI監視技術の発達に伴い、秩序維持の名のもとに個人のプライバシーや自由が侵害されるリスクが高まっています。 - 多様性と分断
グローバル化や価値観の多様化が進む中で、「何が共通の規範なのか」という合意形成が難しくなり、社会の分断が生じやすくなっています。 - デジタル・空間の変容
インターネットやSNS上の誹謗中傷、誤情報(フェイクニュース)の拡散など、物理的な法や警察の手が届きにくい領域での秩序形成が急務となっています。
社会秩序とは、単に「法で人々を抑圧すること」ではなく、「人間が集団として安全かつ公正に生き、互いの潜在能力を発揮するための基盤」です。変化する時代に合わせて、抑圧的になりすぎず、かつ無秩序(アノミー)に陥らない柔軟で包括的な秩序をどのように構築し続けるかが、人類共通の課題と言えます。
6. 幸福 (Happiness)
「幸福(Happiness)」は、時代や文化、民族の違いを超えて人類が追求し続けてきた普遍的な価値であり、人間の生存や生活の目的そのものと考えられています。歴史、哲学、心理学、そして現代のウェルビーイング(Well-being)の視点から、その本質を紐解いてみましょう。
1. 幸福の二つの側面:ヘドニアとユーダイモニア
古代ギリシャ哲学の時代から、幸福には大きく分けて2つの側面があると考えられてきました。
(1)ヘドニア(Hedonia / 快楽的幸福)
- 特徴: 感情的な喜び、快楽、痛みの不在、一時的な満足感。
- 具体例: 美味しいものを食べる、旅行を楽しむ、リラックスする、欲求が満たされる。
- 性質: 即効性がありますが、慣れ(適応)が生じやすく、長続きしにくい特徴があります。
(2) ユーダイモニア(Eudaimonia / 意義的幸福)
・特徴: 人生の意義や目的意識、自己実現、自分の潜能を発揮することによる持続的な充足感。
・具体例: 目標に向かって努力する、他者や社会に貢献する、良好な人間関係を築く。
現代の研究では、健全で持続可能な幸福感にはこの両方のバランスが不可欠であるとされています。
2. なぜ幸福は「普遍的価値」なのか?
幸福が人類共通の普遍的価値とされる理由は、人間という生物および社会的存在の根本に関わっているからです。
- 生きる基本動機(モチベーションの源泉)
政治、経済、教育、技術革新など、人類が行うあらゆる活動の最終的な目的は「自分や他者の幸福を高めること」に収斂します。 - 生存と進化における役割
ポジティブな感情(幸福感)は、視野を広げ、創造性を高め、他者との協力関係(社会的絆)を強化する進化上のメリットをもたらしてきました。 - 国際社会における共通言語
国連の「世界幸福度報告(World Happiness Report)」や「SDGs(持続可能な開発目標)」に見られるように、GDP(国内総生産)といった経済的指標だけでなく、「個人の主観的ウェルビーイング」を国の発展の尺度とする考え方が世界的に広まっています。
3. 現代科学が明かす「幸福を決める要因」
心理学や行動経済学の研究(ハーバード大学の75年以上にわたる成人発達研究など)により、何が人の幸福感を決定づけるのかが明らかになってきています。
(1) 人間関係の質(最も重要な要因)
家族、友人、地域社会との温かい繋がりを持っている人は、健康で長生きし、脳の機能も維持されやすいことが分かっています。
(2) 自己決定感(コントロール権)
自分の人生や行動を「自分で選択できている」と感じられる度合いが、幸福度に強く影響します。
(3) 貢献感と感謝
他者や社会のために役立っていると感じること(親切や与える行為)、日常の小さなことに感謝する習慣は、脳内のドーパミンやオキシトシンを分泌させ、幸福感を大幅に高めます。
(4) 「十分さ」の感覚と経済力
お金は基本的ニーズ(衣食住・安全)を満たすまでは幸福度を大きく引き上げますが、一定の収入を超えると、限界効用は低下(慣れが生じる)します。幸福とは、単に「いつでも笑顔でポジティブでいること」ではありません。悲しみや困難も含めた人生の経験の中で、「自分の人生には価値があり、心地よい関係性と目的を持って生きている」という持続的な実感のことです
7. 安全 (Safety)
「安全(Safety)」は、単に危険のない状態を指すだけでなく、時代や文化を超えて人類が生存・発展するための根幹であり続けてきた普遍的な価値です。法学、社会学、心理学、工学などの多角的な視点から、人類にとっての「安全」の意義を解説します。
1. 心理的・生物学的な観点(マズローの欲求段階)
心理学者アブラハム・マズローの「欲求段階説」において、安全の欲求は食事や睡眠などの「生理的欲求」のすぐ上、すべての高等な人間活動(社会的活動、自己実現など)の土台に位置づけられています。
- 生存の基盤:衣食住が満たされても、いつ襲われるかわからない恐怖(戦争、犯罪、災害)に晒されている状態では、人間は精神的な充足や創造的活動を行うことができません。
- 予測可能性の追求:人間は本質的に「不確実性」や「予測不能な危機」を恐れます。秩序や法則(法、慣習、科学技術)を築くことで、未来の予測可能性を高めようとする本能を持っています。
2. 社会的・政治的な観点(社会契約説)
人類の歴史において、国家や文明が誕生した最大の動機の一つが「安全の確保」でした。
- ホッブズの「自然状態」:17世紀の哲学者トマス・ホッブズは、法や国家がない状態を「万人に対する万人の闘争」と呼び、恐怖から逃れるために人々は権力を一箇所(国家)に集約する契約を結んだと議論しました。
- 基本的人権と法秩序:現代社会における憲法や法体系、治安維持、国防制度はすべて、個人の「生命、身体、財産」を守るための社会的枠組みです。安全が保障されて初めて、個人の「自由」や「平等」が意味を持ちます。
3. 多様化する現代の「安全」概念
技術の発展やグローバル化に伴い、「安全」の意味合いは物理的な侵害からより広い領域へと拡張されています。
| 概念 | 概要 |
|---|---|
| 人間の安全保障 (Human Security) | 国家中心の安全保障から個人の視点へ転換し、貧困・感染症・人権侵害など「恐怖と欠乏」から個人を守る考え方。 |
| 心理的安全性 (Psychological Safety) | 組織やコミュニティ内で、他者からの批判や制裁を恐れずに自分の考えや意見を安心して表現できる状態。 |
| 情報・サイバーセキュリティ | 物理的空間だけでなく、デジタル空間におけるデータ・個人情報・プライバシーを守る安全。 |
| 環境・システムの安全 | 気候変動や巨大インフラ事故など、複雑化したシステムに対するリスク管理(システム安全工学)。 |
4. 「安全 (Safety)」と「安心 (Peace of Mind)」の違い
日本語やいくつかの言語では概念として区別される重要な側面です。
- 安全(Safety):客観的なデータや科学的根拠に基づいて、危険が許容範囲内まで制御されている状態。
- 安心(Peace of Mind):その状態に対して人間が感じる主観的な感情や信頼の心理状態。
心理学において、「安全(Safety)」と「安心(Sense of Security / Peace of Mind)」は明確に区別されます。一言で言えば、「安全は客観的な状態(環境・事実)」であり、「安心は主観的な感覚(感情・認知)」です。
| 項目 | 安全(Safety) | 安心(Peace of Mind) |
| 定義 | 危険や危害を受けるリスクが極めて低い客観的状態 | 危険がないと感じ、心が穏やかで落ち着いている主観的状態 |
| 評価の基準 | 数値・データ・設備・確率などの事実 | 個人の認知・経験・性格・感情などの受け止め方 |
| 対象 | 環境、システム、身体的脅威 | 心理的状態、信頼、感情の安定 |
| 成立の条件 | 対策や防護策が機能していること | 本人が「大丈夫だ」と評価・確信すること |
「安全」とは、単なる「リスクの不在」という受動的な意味にとどまらず、人間が人間らしく自由に生き、個性を発揮し、未来を描くための能動的な前提条件です。現代社会では、技術の進歩や価値観の多様化に伴い、新たな危険(AIのリスク、サイバー脅威、地球環境の危機など)が生じていますが、その都度「安全の再定義」を行い、共有していく姿勢こそが人類共通の課題と言えます。
8. 健康 (Health)
人類の歴史や文明を問わず、「健康(Health)」はすべての人間にとって基本的な権利であり、幸福な生活を送るための根幹をなす価値として尊重されてきました。以下では、「人類の普遍的価値としての健康」について、その概念や多元的な意義を整理して解説します。
1. 概念の定義:WHO憲章における「健康」
健康を普遍的価値として決定づけたもっとも代表的な定義は、1946年の世界保健機関(WHO)憲章前文に見られます。
「健康とは、病気でないとか弱っていないということではなく、肉体的にも、精神的にも、そして社会的にも、すべてが満たされた状態(well-being)にあることをいう。」
この定義の特徴は、健康を単なる「病気の不在」という消極的(消去法的)な概念としてではなく、人間が自己のポテンシャル(可能性)を最大限に発揮して生きるための積極的な状態として捉えている点にあります。
2. 普遍的価値とされる5つの理由
健康がなぜ時代や地域、文化を超えて人類普遍の価値とされるのか、主な理由は以下の5つに集約されます。
(1) 生存と尊厳の基本条件
言葉、文化、宗教、生活様式が異なっても、苦痛を避け、健やかに生きたいという望みは人類共通の欲望です。健康は、人間が人間の尊厳を保ちながら生きるための「基盤」です。
(2) 他のすべての権利や価値を享受するための前提
教育を受ける、仕事をする、自己実現を追求する、家族やコミュニティと交流するといった人間活動の多くは、心身の健康があって初めて十分に成り立ちます。健康は「他のすべての権利・価値を実現するための手段であり目的」です。
(3) 「基本的人権」としての確立(Health is a Human Right)
1948年の『世界人権宣言』第25条においても、健康や福祉を享受する権利が定められています。人種、性別、宗教、政治的信念、経済的状態にかかわらず、最高水準の健康を享受することは「すべての人の基本的人権」と位置づけられています。
(4) 社会的・経済的発展の推進力
個人の健康の総和は、集団や国家の活力に直結します。公衆衛生や医療基盤の充実(例:ユニバーサル・ヘルス・カバレッジ=UHC)は、貧困を削減し、持続可能な開発目標(SDGsの目標3「あらゆる年齢のすべての人々の健康的で幸福な生活の確保」)の達成にも不可欠な要素です。
(5) 精神的・関係的な豊かさ(Well-being)の源泉
近年の研究や社会的議論では、健康は身体の調子にとどまらず、孤立を防ぎ社会との関わりを持つこと(社会的健康)や、心の平穏・生きがいを持つこと(精神的健康)を含めた包括的な幸福感(Well-being)の源として重要視されています。
3. 現代における課題と今後の視点
「普遍的価値」と認められている一方で、現実には健康を巡って以下のような新たな課題が生じています。
- 健康格差(Health Inequity): 国や地域間の経済格差、あるいは一国内での貧困層・富裕層間のアクセス格差によって、受けることができる医療サービスや平均寿命に大きな違いが生じています。
- 地球規模の脅威(Planetary Health): 気候変動、新たな感染症のパンデミック、環境破壊などは、地球全体の人々の健康を脅かす課題であり、国際的な協調が不可欠です。
- 概念の拡張: 高齢化の進行に伴い、「病気がゼロであること」を目指すだけでなく、「持病や障害を抱えつつも、自分らしく満足のいく生活を送る(Quality of Life: QOLの向上)」という発想へのシフトが進んでいます。
健康は、単に「医療上のテーマ」ではなく、「人間とはどうあるべきか」「どのような社会を創るべきか」という人間観・社会倫理そのものに関わる最も根本的な普遍的価値であると言えます。
9. 生命の多様性 (Diversity of Life)
「生命の多様性(生物多様性)」は、単なる環境保護のスローガンにとどまらず、人類の生存基盤、倫理的規範、そして持続可能な社会を支える普遍的価値として認められています。
1. 普遍的価値とされる3つの柱
(1) 存在論的・倫理的価値(生命そのものの尊厳)
すべての生物種は、数億年以上の進化の歴史を経て存在しており、人類の利用価値(役に立つかどうか)を超えた固有の価値(内在的価値)を持っています。多様な生命が存在すること自体が地球の価値であり、特定の種を絶滅させる権利は人類にはないという倫理観に基づきます。
(2) 生態学的・生存的価値(人類の生存基盤)
人類の社会・経済活動は、生物多様性が提供する「生態系サービス」によって成り立っています。
- 供給サービス: 食料、木材、医薬品の原料、清らかな水
- 調整サービス: 局所的・地球規模の気候調節、病原体の拡散抑制、土壌の保全、自然災害の緩衝
- 基盤サービス: 光合成、養分循環、土壌形成(生命が生きる土台)
多様性が高い生態系ほど、気候変動や病原体の発生といった外部ショックに対して強いレジリエンス(復元力)を発揮します。
(3) 文化・精神的・学術的価値
多様な生命は、各地の伝統文化、芸術、信仰、哲学の源泉となってきました。また、現代のバイオミミクリー(生物模倣技術)や遺伝資源の研究に見られるように、未知の課題を解決するイノベーションの鍵(人類の知識のライブラリー)としての役割も担っています。
2. 生命の多様性に対する国際社会の関心の高まり
歴史的に見ても、「生命の多様性」「生物の多様性」「文化の多様性」はローカルな関心事から地球規模の共通の価値観へと発展してきました。
| 年月・枠組み | 意義 |
|---|---|
| 1992年 生物多様性条約 (CBD) | 生物多様性の保全を「人類の普遍的な関心事(Common Concern of Humankind)」として位置づけ。 |
| 2022年 昆明・モントリオール生物多様性枠組み | 2030年までに陸と海の少なくとも30%を保全する「30by30」目標を採択。生物多様性の損失を止め、回復軌道に乗せる(ネイチャーポジティブ)約束。 |
| 2024年〜 ネイチャーポジティブ経営 | 生物多様性を経済システムに組み込み、企業や政府が気候変動対策と同等に最優先で取り組むべき規範へシフト。 |
生命の多様性を守ることは、他者や他種を尊重する「共生(Symbiosis)」の思想そのものです。人類自身も生態系を構成する1つの種に過ぎず、多様な生命との調和の中にしか人類の未来は存在しないという認識が、現代における普遍的価値としての本質です。
10. 独創性 (Creativity)
人類の歴史において、「独創性(クリエイティビティ)」は単なる芸術的才能や一時のひらめきを超え、文明を押し進めてきた普遍的な価値の一つです。歴史・哲学・認知科学などの視点から、独創性が持つ本質と意義について解説します。
1. 独創性の本質:「既存要素の新たな結合」
哲学者のアンリ・ポアンカレや実業家のジェームズ・W・ヤングが指摘したように、「完全な無から有を生み出す独創性」は存在しません。独創性の本質は、既存の知識・概念・事象を全く新しい方法で組み合わせ、価値を付加することにあります。例えば、グーテンベルクが発明した活版印刷機は、活字技術 と ぶどう搾り機を組み合わせたところから生まれました。また、Appleのスティーブ・ジョブズが発明したスマートフォンは、電話 、 コンピュータ 、音楽プレイヤー、カメラという既存のメディアを組み合わせたところから生み出された革命的なニューメディアでした。
2. なぜ独創性が「普遍的価値」なのか
独創性が人類によって普遍的な価値だと言えるのは、次のような特性を持っているからです。
(1) 生存と進化の推進力(生物学的・文明的視点)
人類は鋭い爪や牙を持たない弱い存在でしたが、道具・言語・火の利用といった「独創的な解決策」を発明することで過酷な環境を生き延びてきました。独創性は、人類の生存戦略そのものです。
(2) 自己表現と精神的解放(人間主義的視点)
古代の壁画から現代のデジタルアートに至るまで、人間は内面の世界や感情を形にしたいという強い欲求を持っています。独創的な営みは、単なる機能的必要性を超えて、人間に深い充実感と生の喜びを与えます。
(3) 課題解決と発展(社会的視点)
環境問題、病気、経済的格差など、過去の延長線上では解決できない問題に直面したとき、枠組み自体を変革する独創的思考(アウト・オブ・ザ・ボックス)が必要不可欠となります。
3. 独創性を生み出す3つの要素
認知心理学者テレーザ・アマビール(Teresa Amabile)のモデルによれば、独創性は以下の3つの領域が交差する場所に生まれます。
| 要素 | 内容 |
|---|---|
| 領域専門知識 | 深い知識や技術の蓄積(素材となる基礎情報) |
| 創造的思考スキル | 視点を変え、既存の枠組みを疑う柔軟性 |
| 内発的動機づけ | 報酬や評価のためではなく、「知りたい」「作りたい」という好奇心・情熱 |
4. 現代における独創性の意義とAIの台頭
AI技術の急速な進化により、情報の整理やパターンの模倣、既存データの効率的な出力はAIが得意とする分野となりました。この時代において、人間の「独創性」は以下のような新しいフェーズに入っています。
- 「問い」を立てる力: 正解を出す力よりも、「何が本当の課題なのか」という問い(Vision) を生み出す力が独創性の中心になります。
- 文脈と共感の結合: 人間の感情、カルチャー、倫理観、偶発的な体験(文脈)を組み合わせたニュアンス豊かな表現・価値創造。
- 異分野の越境: 一見関係のない複数の領域を横断し、意図せぬひらめきを生み出す能力。
独創性とは、過去の知恵を受け継ぎつつも、現状に満足せず「新しい可能性」を切り拓くという、AIにはない、人間らしさの根幹をなす精神的営みです。
20 -3 : 制御ツール
前節で述べた「人類共通の普遍的価値」を実現したり維持したりすることは、実際には容易ではありません。なぜなら、最終章でも述べるように、地球生態系を構成する「自然」「文明」「文化」という三大要素は、進化のプロセスにおいて、相互に齟齬をきたしたり、対立、暴走、混乱を引き起こし、各々の構成要素における普遍的価値の喪失、破壊を招く恐れがあるからです。したがって、健全な生態系の持続可能な発展(健全な進化)をはかるためには、人類とAIが協力して、社会システムを適切に制御することが必要になります。
1. ローレンス・レッシグの「コード」(CODE)
そのようなシステム制御のツールには、どのようなものがあるでしょうか?ハーバード大学教授の法学者ローレンス・レッシグは、「法律」「市場」「規範」「アーキテクチャ」の4つをあげています
ローレンス・レッシグ著『Code: Version 2.0』は、初期のインターネット空間に存在した「サイバースペースは国家の規制を受けない自由なアナーキー空間である」という思想(サイバー・アナーキズム)を根本から批判し、デジタル空間における統制と自由のダイナミズムを解明した著作です。
本書の核となる主張は「コードは法である(Code is law)」という提唱に集約されます。レッシグは、現実空間で国家の制定法(法律)が人々の行動を規制するように、サイバースペースではソフトウェアやハードウェアのプログラム記述、すなわち「コード(Code)」がアーキテクチャ(構造)として機能し、利用者の行動や権利の限界を直接的に決定・規制していると主張しました。
レッシグは、あらゆる社会において人間の行動は以下の4つの要素(モダリティ)の相互作用によって規制されていると説明します。 これらは独立して存在するのではなく、互いに影響を与え合いながら社会全体の規制体系(均衡状態)を形作っているとレッシグは考えています。
1) 法(Law): 国家や政府が制定する法律・条文であり、違反者に対して警察や裁判所を通じて罰金や懲役などの「事後的な罰則(ex post sanctions)」の威惑を与えることで、人間の行動を直接禁止・指示します。
(例)喫煙規制: 18歳未満へのタバコ販売禁止法や、空港・飛行機・エレベーター内での禁煙法。
2) 社会規範(Norms): コミュニティ(社会的集団)のメンバー同士が相互に課す規律であり、コミュニティの価値観や期待から逸脱した行動に対して、非難、恥(shame)、排斥、村八分などの「社会的制裁(ex post social sanctions)」を事後的に与えることで行動をコントロールします。
(例)喫煙マナー: 他人の私有車内でタバコを吸う前に同乗者に許可を求めること、ピクニックでは許可不要だが食事中には吸わないこと、レストランで他人に禁煙を求められたら従うことなどの社会的配慮。
3) 市場(Market): 価格(Price)、コスト、供給、経済的インセンティブを通じて行動を制約します。法や規範と異なり、制約(代金の支払い)と取引(便益の獲得)が「同時(simultaneous)」に発生するという特徴を持ちます。価格設定や経済的インセンティブ、機会費用による制約。
(例)タバコの価格・タバコ税: タバコの販売価格や高い税金によって購入・喫煙の需要を抑制する制約。
4) アーキテクチャ(Architecture): 物理的・技術的な構造や環境そのものが与える制約です。「〜してはならない」という命令ではなく、「物理的・技術的に特定の行動を不可能(または容易)にする」物理法則やシステムの仕様として、警察やコミュニティの目がなくても「自動的(self-executing)」に効力を発揮します。
(例)タバコ自体の技術・構造: ニコチン処理(中毒性を強化する設計)、煙が出ない無煙タバコ(吸える場所が増える)、匂いの強いタバコ(吸える場所が狭まる)といった製品デザインそのもの。
現実世界では建物の壁や道路の構造がアーキテクチャとなりますが、サイバースペースでは「コード」がこのアーキテクチャの役割を担います。法律や規範が事後的なペナルティの威嚇によって「〜してはならない」と命じるのに対し、コードは物理法則のように「特定の行動を不可能にする」あるいは「特定の行動へと誘導する」ため、極めて直接的で強力な規制力を発揮します。
電子商取引(Eコマース)を円滑化したい市場の要求と、統制権を取り戻したい政府の思惑が一致した結果、クッキー、IPマッピング、デジタルIDなどの認証・識別技術が網の目のように導入されました。レッシグによれば、ワシントンD.C.の法律(East Coast Code)が民間のプログラマーが書くコード(West Coast Code)の設計を間接的に規制・誘導する「規制の二段階構造(Regulatory two-step)」を通じて、ネットは「人類史上最も高度に統制可能な空間」へと変容しつつあります。さらに、サイバー攻撃やマルウェアの脅威(Z理論)が政治的意志を決定づけ、完全な統制空間への移行を加速させると警告します。
コードによる規制の進展は、従来の法制度が想定していた基本的人権や民主的価値に「潜在的な曖昧さ」を生じさせ、深刻な危機をもたらしています。
- 知的財産権(IP): DRM(デジタル著作権管理)や「信頼されたシステム(Trusted Systems)」といったコードによる私的規制は、従来の著作権法が維持してきた「フェアユース(公正利用)」や「パブリック・ドメイン」というバランスを破壊し、著作権者に完全な統制権を与える「許可の文化」へ改変してしまいます。
- プライバシー: オンライン上のすべての行動履歴が自動的に監視・記録・検索可能となり、常時プロファイリングされる監視社会(パノプティコン)が形成されます。市場や事後的交渉のみでは個人のプライバシー権は防衛できません。
- 言論の自由: ポルノやスパムの排除を目的とした完璧なフィルタリングや上流での遮断は、多様な意見との「予期せぬ遭遇」や公共の議論の場を奪い、社会の分断と検閲を招くリスクを持ちます。
レッシグは、デジタル時代において、人間の自由と権利を守るために以下の解決策を提示します。
- オープンコード(Open Code)による透明性の確保: コードによる規制は、法律と同様に公的で透明でなければなりません。機能がブラックボックス化した「クローズドコード」は隠れた統制を可能にするため、誰もが検証・改変可能なオープンソース/フリーソフトウェアの構造を推進し、政府や企業の非透明な支配に対するチェック機能を確立すべきです。
- アーキテクチャの選択を「政治」として捉える: コードの設計は単なるエンジニアリングの問題ではなく、どのような価値観(プライバシー、言論の自由、共有財)を保護するかという「政治的決定」そのものです。
- 結論: インターネットの未来を市場や技術の見えざる手に委ねるのではなく、私たちが守るべき憲法上の民主的価値をコード内部へと意図的に組み込んでいく「自覚的な政治的選択」と民主的介入を行うことが不可欠です。
2. メディアによる制御 ( Media)
レッシグの議論は、インターネット時代の法制度の問題点を明らかにし、それによって脅かされている人間の自由と基本的権利を回復するための方策を考える上で、極めて示唆に富むものです。ただし、インターネット誕生の歴史的背景にある、各種のメディアとコミュニケーションの持つ光と影の両面と、現代社会における有効な活用のあり方に関する考察が抜けているのではないかという気がします。そこで、以下では、この点に関して、5番目の(最も基本的な)制御ツールとしてのメディアの意義について、補足的な検討を加えたいと思います。
メディアは、上記の4つのツールと同列の並列的要素ではなく、他の4つの制御手段が誕生・機能するための「土壌(メタ制御ツール)」であると言えます。
- メディア史からみる規制の変容
メディアの歴史を振り返ると、常に技術的進化に伴う「自由の拡大(光)」と「支配・管理の強化(影)」の二律背反(アンビバレンス)が存在してきました。
[メディアの歴史的進化と制御の二面性]
- 印刷技術(活字メディア)
├─ 光: 知識の普及、個人主義・民主主義の萌芽、批判精神の獲得
└─ 影: 国語の固定化、プロパガンダの広域化、検閲体制の強化 - マスメディア(ラジオ・テレビ)
├─ 光: リアルタイムな情報共有、大衆文化の醸成、社会的統合
└─ 影: 一方向的支配(中央集権的コントロール)、大衆社会化、受動性の植え付け - デジタル・ネットワークメディア(インターネット)
├─ 光: 発信の民主化、水平的ネットワーク、表現・結社の自由の飛躍
└─ 影: 監視資本主義、フィルターバブル、エコーチェンバー、世論操作の高度化
インターネット誕生の初期(1990年代)には、リバタリアン的な「サイバー空間は国家の統制を免れ、自由をもたらす」という楽観論(光の側面)が支配的でした。しかし現代では、プラットフォーム企業や国家がアルゴリズムを用いてアーキテクチャや言葉の流通を制御する「新たな監視・誘導(影)」の問題が顕在化しています。
レッシグの「コード」への傾注は、この「インターネットの影」に対抗するための洞察でしたが、「なぜ人々がそのコードを受け入れてしまうのか」「どのようにして人々の認識や意志がメディアによって操作されるのか」という認知レベルの制御を説明するには、メディア・コミュニケーション論的アプローチが不可欠となります。
2. 第5の制御ツールとしての意義と効果
コミュニケーション(メディア)を独立した制御力(および回復の手段)として定義することには、以下の重要な意義があります。
(1) アーキテクチャの「意味づけ」を変革する力
コード(アーキテクチャ)は人々の行動を物理的・技術的に制約します(例: 複製不能なDRM技術、投稿ボタンの配置など)。しかし、そのコードが「正当なものか、不当な支配か」を定義し、異議を唱える運動を巻き起こすのは、メタレベルで行われる言説や対話(コミュニケーション)です。オープンソース運動やプライバシー擁護運動は、コードそのものではなく「コードのあり方を問うコミュニケーション」から始まりました。
(2)「規範」を再定義・合意形成するリアリティの創出
規範は静的なものではなく、コミュニケーションの過程で常に再生産されます。インターネット時代における「誹謗中傷」「ディープフェイク」「アテンション・エコノミー」といった課題に対し、新たな倫理や社会的合意(デジタル・シチズンシップ)を形成する主エンジンは、対話的・熟議的なコミュニケーションそのものです。
(3) 主体性(エージェンシー)の回復
コードや法による制御は、人間を受動的な「被規制者」に追いやる傾向があります。これに対し、メディアを通じた表現や対話は、人間が自らの意思で社会に参加し、環境を書き換えるための「能動的な基本的権利(コミュニケーション権)」の行使そのものです。
3. 現代社会における有効な活用の方策
インターネット時代の支配や監視から人間の自由と基本的権利を回復・補強するために、「コミュニケーション(メディア)」という制御ツールをどのように活用すべきか、3つの軸で整理できます。
| 活用軸 | 具体的な方策とあり方 |
| 1. メディア・リテラシーから「アテンションの主権回復」へ | アルゴリズムやプラットフォームが人間の認知・感情(怒りや恐怖)を刺激してアテンションを奪う構造に対し、メディアの仕組み自体を解読・批判する能力(メディア・リテラシー)を養う。自らの注意・関心をどこに向けるかという「主権」を個人の手に取り戻す。 |
| 2. 熟議(デリバレーション)型プラットフォームの構築 | 単に「アテンションや拡散力」を最適化するソーシャルメディアではなく、対話と妥協点・共通善の発見を促進するインフラ(例: 台湾のPolisのような合意形成ツール)を社会の基盤として組み込む。 |
| 3. コミュニケーション権の法制化とパブリック空間の再建 | プラットフォームの私的支配に対抗し、市民が自由に議論しアクセスできる「デジタル上の公共空間(Public Sphere)」を維持・保障することを基本的人権(コミュニケーション権)として確立する。 |
レッシグの4要因モデル(法・規範・市場・コード)は、現代社会の制御構造を捉える上で極めて優れたフレームワークですが、それらはすべて「コミュニケーションというメディア空間の中で機能し、意味を与えられる」という前提に立っています。アーキテクチャ(コード)による見えない管理統制が進む現代だからこそ、第5の制御手段としての「メディア」を認識し、その光(対話・熟議・批判的思考)を最大限に活かすことが、脅かされた人間の自由と基本的権利を再構築するための最も根本的な鍵となるでしょう。
20-4 : 生成AI時代のカルチュラル・エコロジー
1. エコロジー(生態学)の発展
(1) 生物生態学の成立
19世紀後半 – 20世紀初頭、Ernst Haeckel が 初めてÖkologie(生態学) という概念を提唱しました。そこでは、「生物と取り巻く外部世界(環境)との相互関係の科学」として定義されました。当初は植物地理学や動物行動学から発展し、純粋な生物学的アプローチが中心でした。
(2) エコシステム(生態系)概念の確立
1930年代 – 1940年代、Arthur Tansley が 生態系(Ecosystem) の概念を提唱しました。生物群集(Biocenosis)と非生物的環境(Abiotic Environment)を統合し、エネルギーの流れや物質循環を体系的に捉える現代生態学の基礎が築かれました。
(3) 人間生態学(Human Ecology)の誕生
1920年代 – 1930年代、シカゴ学派の社会学者 Robert Park や Ernest Burgess らが、植物・動物生態学の概念(競争・遷移・定着など)を都市都市空間や社会行動の分析に応用しました。そして、人間集団と社会環境の関係を空間的・構造的に分析する基盤となりました。
(4) 文化生態学(Cultural Ecology)の成立
1950年代、人類学者 スチュワード(Julian Steward) が『文化変容の理論』などで「文化生態学」を提唱しました。生物学的適応を超え、特定環境下での生業技術・資源利用・社会的組織化を通じて、「人間集団が文化を媒介として環境にどう適応するか」を明示しました。
2. 新しいカルチュラル・エコロジーの展開
スチュワードが念頭に置いたカルチュラル・エコロジーが研究対象とするは、⿂、鯨,アザラシといった動物や⽇照、⽔利などであり、対象とする社会はインディアンなどの部族社会でした。スチュワード以降も多くの研究者が、カルチュラル・エコロジー的⽴場から多くの研究を残しています。たとえば、シモンズはエスキモー社会を、ネティングは東アフリカ牧⽺社会等を対象にしたフィールド調査により、環境と⽂化との関係を詳しく分析しています。現在、⽶国等のいくつかの⼤学では、⽂化⼈類学の1つの講座として、カルチュラル・エコロジーが開講されています。
⼀⽅、新しい社会的⽂脈のなかでカルチュラル・エコロジー研究の必要性が述べられたのは、1994年タンペレで開かれた、世界放送通⾔機構の会議においてでした。開催国フィンランドの⼤統領,アハティサーリ(M. Ahatisaari)は、新しいメディア環境の出現が⼤きな社会的インパクトをもたらすと考え、本格的に調査研究することを放送‧通信関係者等に訴えたのです。アハティサーリ⼤統領の呼びかけを受けて、世界放送通信機構はカルチュラル・エコロジー‧プロジェクトを⽴ち上げ、その成果を報告書にまとめています。
ここでいうカルチュラル・エコロジーは新しい概念であり、エコロジーの原点に帰り。現在の情報化の進んだ社会における、放送‧通信などのメディアの果たしている役割からみた⽂化を、⽣物学的視点を重視しつつ捉え直し、ヒューマン・エコロジーのなかにカルチュラル・エコロジーを位置づけようとするものです。
ここでは、⼈間の⽣活、特に⼈間⾏動と⽂化の関係を広く情報化社会の動的な動きとして提え。その相互作⽤を明らかにするエコロジーの体系として、カルチュラルエコロジーを定義づけたいと思います。現在、社会の情報化はめざましく、特に最近ではインターネットや携帯電話、デジタル放送といったデジタルメディアが急速に普及し、コミュニケーション⽂化のあり⽅や⼈間の⾏動ばかりでなく、広く社会のあり⽅、家庭のあり⽅。さらには⽣態にまで影響が及ぼうとしている。すなわち、新しいカルチュラルエコロジーは、デジタルメディア‧セントリック‧カルチュラルエコロジー(デジタルメディア中⼼の⽂化⽣態学:digital media centric culturalecologg)になろうとしているのです(小林・吉井, 2001)。
3. 文化と文明の循環的進化
未来学者であり、日本におけるフィランソロピー(社会貢献活動)の先駆者としても知られる林雄二郎(1916〜2011)は、社会の発展プロセスにおける「文化」と「文明」の関係性を明確に区別し、双方が相互作用しながら循環・進化していく構造を提唱しました。
1. 「文化」と「文明」の定義
林雄二郎の議論において、まず重要となるのがこの2つの概念の比較です。
| 区分 | 本質 | 特徴 |
| 文化(Culture) | 人間の内面的な「価値観」「精神性」「創造力」「生き方」に根ざすもの | 個別的・多様的であり、人間の「こころ」や生活の意味を形成する |
| 文明(Civilization) | 文化によって生み出された知恵や技術が、制度・システム・道具として「普遍化・標準化」されたもの | 人間に利便性や効率性をもたらし、広範囲に伝播・蓄積・共有しやすい |
2. 循環的進化のメカニズム
社会が成熟し変化していく過程は、「文化→文明→新たな文化」という循環の連鎖として捉えられます。
(1) 文化から文明への結実 : 社会の原動力は、まず人々の内面的な感情や多様な試み(文化)から始まります。これが社会的・技術的な基盤として定着すると、汎用的な「文明」へと進化し、人々に利便性や安全をもたらします。
(2) 文明の限界と文化による再刷新 : 普及・高度化した「文明」は、次第に制度化・システム化が進んで肥大化し、制度そのものが自己目的化する(=人間性の矮小化や不在を招く)という壁に突き当たります。 このシステム主導の「文明」に対して、「人間にとっての豊かな生き方とは何か」という原点回帰の問い直しが起こり、そこから新たな「文化」の創造へと導かれます。
3. 「情報文明」から「情報文化」へ
林雄二郎は、とりわけ高度情報化社会の訪れの中でこの循環論を強く訴えました。
(1) 情報文明の時代:コンピューターや通信ネットワークなど、情報が効率的に伝達・管理・制御される「システムや技術の構築」が先行する段階。
(2) 情報文化の時代への移行:技術的基盤(情報文明)が整った後は、そのネットワーク上で人間がどのように心を通わせ、どのような意味や価値、市民活動(フィランソロピー)を生み出すかという「情報文化」の段階へ進化しなければならないと論じました。
技術や制度という「文明」の枠組みを享受するにとどまらず、そこから新しい人間的な生き方や共生・社会貢献といった「文化」を立ち上げていく循環こそが、持続可能で心豊かな社会の深化につながるという点が、林雄二郎氏の議論の核心です。
4. ベニガーの「制御革命」論
ジェームズ・ベニガー(James N. Beniger)が著書『コントロール革命(The Control Revolution)』で提示した「コントロールの危機」および「制御革命」は、現代の情報社会がどのような歴史的・理論的プロセスを経て成立したのかを解き明かす核となる概念です。以下では、その全体像を詳しく要約・解説します。
1. 問題意識と理論的前提:社会を「処理システム」と捉える視点
先進工業国において情報処理や情報財が経済の主体となる「情報社会」の到来は広く認識されていますが、ベニガーは「なぜ数ある人間活動の中で情報が経済の中心となったのか」「なぜそれが『今』なのか」という根本的な疑問を投げかけます。
この問いに答えるため、ベニガーは一国の経済を、環境からの入力を抽出し、再編成し、最終消費へと分配する具体的な「物質処理システム(Material Processing System)」として捉えます。あらゆる生命システム(単細胞生物から個体、そして国家経済まで)の本質は目的を持った「コントロール(制御)」であり、システムが成立・維持されるためには、情報処理とコミュニケーションによる制御が不可欠であるという前提が置かれています。
2. 「コントロールの危機(Crisis of Control)」とは何か
産業革命以前の社会では、最も発展した経済であっても人間のペース(使役動物や風力・水力によるわずかな補助)で動いており、物質の処理速度も穏やかであったため、控えめな官僚機構による制御で十分機能していました。しかし、19世紀の産業革命(工業化)は、製造や輸送の分野へ蒸気機関などのエネルギーを応用することで、社会全体の物質処理スピードを爆発的に加速させた。その結果、以下の構造的乖離が生じることとなった。
- 物質・エネルギーの処理速度: 工業化により飛躍的に増大・加速した。
- 情報処理・コミュニケーション能力: 従来の人間依存の技術や組織構造のままで停滞していた。
製造、輸送、分配の現場で処理される物質の量とスピードに対して、それを把握・伝達・管理する技術が追いつかなくなったことで、社会の物質処理システム全体が制御不能に陥る危険に直面した。ベニガーはこの「エネルギー・物質処理革新に対して、情報処理革新が遅れたことによる不均衡な期間」を「コントロールの危機 (Crisis of Control)」と定義しました。歴史的には、1870年代から1910年代にかけてこの危機が最も顕著となりました。
3. 「制御革命(Control Revolution)」とは何か
この「コントロールの危機」を克服し、増大した物質処理を再び社会的に制御するために生じた一連の急速な技術的・経済的・組織的変化の複合体が「制御革命(コントロール革命)」です。ベニガーによると、制御革命とは「情報が収集、保存、処理、伝達され、公式またはプログラム化された決定を通じて社会的コントロールを及ぼすような、技術的および経済的取り決めにおける急速な変化」を指します。19世紀末のコントロールの危機をきっかけに、社会は失われたコントロールを取り戻すため、以下のような変革を一挙に進めました。
- 組織的制御: 大企業の出現や近代的な官僚制、管理機構の形成(アルフレッド・チャンドラーの経営革命とも重なる)。
- 技術的制御: 郵便、電信、電話、パンチカードシステムなどのコミュニケーションおよび情報処理技術の発達。
この制御革命は、社会的・知的・文化的な影響力において、19世紀の産業革命が前世紀にもたらした影響と同等以上に、20世紀の歴史において決定的な意味を持つとされます。
4. 現代情報社会とコンピュータの位置づけ
ベニガーの理論における最も重要な示唆の一つは、現代のマイクロプロセッサやコンピュータ技術に対する見方です。一般的な議論では、コンピュータ技術は近年突如として現れ、社会を変容させた新興勢力と捉えられがちですが、ベニガーはこれを否定します。コンピュータやマイクロプロセッサは、19世紀半ばに最初の兆候を見せた「コントロールの危機」に対処するために始まり、100年以上続いてきた制御革命の「最新の展開段階(latest installment)」に過ぎません。実際、コンピュータがもたらした主要な機能や貢献の多くは、19世紀半ばのコントロール危機の発生時点で既に予測され、要請されていたものでした。すなわち、現在の情報社会は最近の技術的出来事の産物ではなく、1世紀以上前に始まった物質処理速度の向上と、それに対する社会的制御能力の長期的かつ継続的な拡大プロセスの結実なのです。
ベニガーの「コントロールの危機」と「制御革命」は、情報社会の到来を単なる近年のIT技術の進歩として捉えるのではなく、「工業化に伴う物質処理の加速(コントロールの危機)」と「それを制御するための情報処理の変革(制御革命)」という歴史的相互作用として捉え直すための、極めて洞察に富んだフレームワークといえます。
5. AI時代のカルチュラル・エコロジー
提示された文章で示されている「ジュリアン・スチュワードに始まる伝統的な文化生態学」、「1990年代以降のデジタルメディア中心の文化生態学」、そして「林雄二郎による『文化と文明の循環的進化論』」の視点を融合・発展させることで、AI時代における「カルチュラル・エコロジー(文化生態学)」を次のように解釈・整理することができます。
1. カルチュラル・エコロジーの現代的再定義
伝統的な文化生態学(スチュワードら)は、「自然環境(魚、アザラシ、気候等)」と「部族社会の文化や行動」との相互作用を研究対象としていました。
その後、1990年代のデジタルメディアの普及に伴い、文化生態学は「デジタルメディアを中心とした情報環境」と「人間の行動・社会・家庭・生態」との動的な相互作用を捉える「デジタルメディア・セントリック・カルチュラルエコロジー」へと拡張されました。
これをAI時代に当てはめるならば、現代の文化生態学は「生成AIや自律型アルゴリズムが張り巡らされた『AI・情報環境』と、それによって変容する人間の思考・身体・コミュニケーション・社会構造との動的アセンブラージュ(相互作用系)」を分析・デザインする学問・実践として位置づけられます。
2. 林雄二郎の「文明と文化の循環論」から見るAI時代
林雄二郎は、社会の進化を「文化(内面・価値観) → 文明(技術・制度・標準化) → 新たな文化(意味の再構築)」という循環として提示しました。
【循環のメカニズム】
[文化]人間の内面的欲求・価値観・精神性
  ↓ (社会基盤・技術として定着・標準化)
[文明]利便性・効率性を追求するシステム・ツール
  ↓ (過度な肥大化・制度化による「人間性の矮小化」)
[新たな文化]原点回帰の問い直し・意味や価値の再創出
この循環モデルを現代のAIに適用すると、以下の課題と展開が見えてきます。
(1) 「AI文明(情報文明の極致)」の肥大化と限界
高度な生成AIや機械学習ネットワークは、従来のコンピューターや通信を超えた「最適化・効率化・標準化」をもたらす「AI文明」の段階にあたります。
しかし、AI文明が極度に進展すると、以下のような問題が生じます。
- 思考の外部化と人間性の矮小化: 効率やアルゴリズムの提示に従うのみになり、人間自身の「こころ」「価値観」「選択の主体性」が矮小化する。
- システムの自己目的化: 効率性・収益性・最適化ルールそのものが目的化し、人間がシステムに使われる状態に陥る。
(2) 「AI文化」への昇華(文明から文化への再刷新)
林の理論に従えば、AI文明の肥大化によって人間性の不在という壁に突き当たったとき、「AI時代における人間にとっての豊かな生き方とは何か」という原点回帰の問い直しが起こります。
技術的基盤としての「AI文明」を受け取るだけで終わらせず、その上で人間がどう心を通わせ、新たな意味、価値、創造性、市民活動を生み出すかという「AI文化」の段階へ進化させることが求められます。
3. 「AI時代のカルチュラル・エコロジー」が目指すもの
提示された文章の文脈を統合すると、AI時代のカルチュラル・エコロジーは以下の3つの役割を果たすと考えられます。
(1) AI環境と人間行動の動的相互作用の解明
AIが生成する情報や自動化されたシステムが、人間の日常行動、家庭のあり方、さらには認知・生態レベル(脳の働きや注意の向け方)にどのような影響を及ぼしているかを包括的・動的に捉えます。
(2) 技術主導(AI文明)から人間主導(AI文化)への転換
単に利便性や効率性を追究する「AI文明」に留まるのではなく、AIを用いて人間がどのような生き方や共生、社会貢献(フィランソロピー)を立ち上げていけるかという「文化の創出」を導きます。
(3) 持続可能で心豊かな「生態系(エコロジー)」の構築
人間とAI、そして広範な情報・自然環境がバランスを保ち、互いの可能性を損なわずに巡り続ける「持続可能で心豊かな社会の生態系」を設計・維持するための指針を提供します。
6. 見える世界と見えない世界の交流
(1) 星の王子さまの言葉の意味
「大切なものは目に見えない」という有名な言葉があります。これは、アントワーヌ・ド・サン=テグジュペリの著書『星の王子さま』に登場する有名な一節で、「真に価値のあるものや本質は、外見や数値といった表面的な情報ではなく、心や目に見えない絆を通じなければ感じ取れない」という意味を持っています。
この言葉には、以下のような大切な視点が込められています。
- 目に見えるもの(表面的な価値)
容姿、肩書、所有物の数、価格など、誰の目にも明らかな外側の情報です。王子さまが出会った大人たちは、数字や目に見える価値ばかりを気に揉んでいました。 - 目に見えないもの(本当の価値)
愛情、思いやり、信頼、時間、友情などです。これらは言葉や数値で測ることはできませんが、人生を豊かにする本質的な要素です。
作品の中では、王子さまが「自分のバラ」のために注いだ時間や労力こそが、そのバラを世界でたった一つの特別な存在にしたのだと気づく重要な場面で語られます。目に見える情報が溢れる日常のなかで、「目に見えない気持ちや関わりにどれだけ心を寄せられているか」を問いかけてくれる言葉です。
(2) 霊的な世界の存在
私たちが日々感じながら生活している世界は、決して目にみえる現実世界だけではありません。亡くなった家族や親しかった友人、遠い祖先の人々の霊や魂もまた、いまでも、どこか遠いところ(天国や霊界)に、あるいはすぐ近くにいて、私たちを暖かく見守ってくれている。多くの人々がそんな気持ちを抱いているのではないでしょうか。
哲学においては、古代から多くの哲学者たちが、「目に見える物質世界」と「目に見えない領域」の関係を論理的に解釈しようとしてきました。例えば、プラトンのイデア論(古代ギリシャ)によれば、私たちが目にする現実に存在するものはすべて「影」であり、その背後に変幻しない真の実在(イデア)の世界が存在すると考えました。これは宗教的な霊界とは異なりますが、「目に見える世界を超えた真理の領域」を認める代表例です。また、近代哲学の祖デカルトは、世界を「物質(延長をもつもの)」と「精神(考えるもの)」の2つに分けました。肉体が滅びても精神が存在し得るという考え方は、霊的な世界観の近代的基盤となりました。一方、カントは、人間が認識できるのは「経験できる現象」のみであり、神や魂、霊的世界といった「物自体」の存在は人間の理性では証明も否定もできない(不可知である)としました。
宗教においては、目に見えない世界こそが根本的な真理や生命の源泉であるという考え方が支配的です。例えば、有神論的宗教であるキリスト教・イスラム教などでは、現世(目に見える世界)は一時的な試練や営みの場であり、死後に赴く天国や地獄、神の御前といった「天国・来世・霊的世界」こそが永遠の実在であると捉えます。他方、仏教などの東洋思想においては、個別の魂が不変の霊界に存在する形ではなく、万物がつながり合って変化し続ける「縁起」や、目に見えない領域を含む「観念・精神の働き」に焦点を当てます。また、輪廻転生や十界(地獄から仏に至る精神的・霊的な境界)という形で世界の多層性を説明します。日本独自の宗教であるアニミズムや神道においては、自然界のあらゆるもの(山、川、木、風など)に霊性や神(カミ)が宿ると考え、現実世界と霊的世界は断絶しておらず、同じ空間の中に重ね合わさって存在していると見なします。
霊的世界の認識方法という点で対極にある科学(特に自然科学)では、観察・実験・再現が可能な「物質世界」を研究対象とするため、科学的に検証できない霊的世界の存在を直接扱うことはありません。しかし、現代の認知科学や心理学(ユングの「集合的無意識」など)では、人間が「目に見えない世界」を感じ取ったり信じたりする心が、どのように心の安定や行動のモチベーションに影響を与えるかを研究対象としています。
(Generated by Gemini)
このように、目に見えない(霊的な)世界というのは、客観的、科学的には実証し得ないものであるとはいえ、カルチュラル・エコロジーの視点からいえば、私たちのアイデンティティを形成、維持し、発展させる上でも重要な精神世界の一部となっており、日々の実践の中で大切な参照基準、発想源、導きの糸、人生理解のためのフレームワークとなっていることを忘れてはならないと思います。
(Written by Shunji Mikami)
7. バイアス・フリー:差別・偏見のない社会
(1) 認知バイアスとは
「認知バイアス」とは、人間が物事の意思決定をするときに、これまでの経験や先入観によって認知に歪みや偏りが生じ、合理性を欠いた判断を下してしまう心理傾向や態度を指します。認知心理学や社会心理学での様々な観察者効果の一種であり、基本的な人口統計学的な誤り、社会的帰属の誤り、記憶の誤りなど人間が犯しやすい問題でもあるとされます。認知バイアスの概念は、エイモス・トベルスキーとダニエル・カーネマンらの業績によるとされており、彼らの実験によって人間の判断と意思決定が合理的選択理論とは異なった方法で行われていることが示されました。次いで、トベルスキーとカーネマンはプロスペクト理論を生み出しました。トベルスキーとカーネマンは、認知バイアスの少なくとも一部は心的なショートカットまたは「ヒューリスティクス」を用いて問題を解決しようとするために起きると主張しました。他の認知バイアスは、人間の処理限界の「副産物」であり、適切な精神メカニズムの欠如 (限界合理性)、個人の体質や生物学的状態の影響 (身体的認知を参照)、または単に情報処理能力が限られているからです。
(2) Normalcy Bias (正常化の偏見;正常性バイアス)の発見
これよりも前、第二次大戦後のアメリカにおいて、災害の脅成に対する認知が、解釈者自身のもつ先有傾向、デモグラフィック特性の違い、解釈者のおかれている社会・心理的背景などによってさまざまな認知バイアスを受けることが明らかにされました。これは、大戦中の警報に対する人々の反応に関する研究がそのきっかけとなっていますが、戦後も災害社会学の領域においてフィールド研究が継続され、1950年代には、Normalcy Bias(正常化の偏見;正常性のバイアス)の発見につながります。これは、環境からインプットされる情報を日常生活の判断枠組の中で解釈しようとし、危険が迫っているという事実を認めようとしない態度のことをいいます(Fritz, 1961)。そのため、たとえ情報確認が行なわれても、危険のサインを逆に日常的な出来事の一部として解釈しつづけるために、脅威を正しく認知できないことがしばしばあります。たとえば1952年3月21日、アーカンソー州ホワイト郡で竜巻が起こり、約50名の死者を出したとき、多くの人びとは、激しいつむじ風の音を聞いて、それがすぐ近くを走る汽車の音だろう、と日常性の判断枠組の中で解釈し、竜巻の脅威を認知できませんでした(Fritz, 1958)。このような正常化の偏見は、とくに先行現象が目にみえないものであったり未知のものである場合に顕著に現われやすいことがわかりました(Fritz, 1957)。また危険の兆候を身近な現象と結びつけと解釈するという傾向が一般にみられます。たとえば1951年9月21日、ニューヨーク州ブライトンで、ガスの本管の漏洩による爆発事故が起き、民家16棟が失し、2名が死亡したが、この時どの主婦も、最初自分の家の台所のガスが爆発したものと思い込んだのでした(Fritz, 1958)。
「正常化の偏見」(正常性のバイアス、日常的偏向)の概念を日本に初めて紹介したのは、筆者を中心とする「災害と情報」研究グループでした(池田, 1981 ; 三上, 1982;中村, 2021)。そのきっかけは、筆者が1980年から1981年にかけて、米国フルブライト委員会の助成を受けて、1年間、災害社会学の研究のために、オハイオ州立大学災害研究所 (Disaster Research Center, the Ohio State University) に客員研究員として滞在したことにあります。この間、災害研究の世界的権威である研究所長のE.L.Quarantelli教授の指導の下、米国における先進的な災害社会学の研究を学び、世界的な業績を上げている専門家多数を米国各地に訪問して、日本での研究を交えて討論する機会を得ることができました。Charles Fritz博士とも、ワシントン,D.C.の全米科学アカデミーのオフィスでお会いし、親しくお話しをさせていただく光栄に浴しました。Fritz博士は、とても紳士的な方で、全米科学アカデミーの関わる災害研究の文献をご提供下さるなど、さまざまなご好意をいただきました。このような学術的交流を深める過程で、Fritz博士の「正常化の偏見」に関する研究文献に接することができたのだと思います。実は、Fritz博士とQuarantelli教授とはシカゴ大学のNORC調査センターの同僚にあたり、共に災害社会学のフィールド研究に携わった仲で、その共同研究を通じて、いわゆる「災害神話」や「パニック神話」など、災害社会学の金字塔とも言える業績を築かれたのでした。こうして、筆者らが日本に持ち帰ったこれらの研究成果は、災害警報を人々が受け取る時に生じる「正常化の偏見」という認知バイアスが、危険の認知を低下させ、避難行動を遅らせてしまうというネガティブな影響を引き起こすことを明らかにした点で、その後の防災対策のあり方にも大きな影響をもたらしました。
(3) 認知バイアス研究の発展
その後、社会心理学やその他の領域において、各種の認知バイアス(cognitive bias)が研究されるようになりました。「正常性バイアス」以外の認知バイアスの例としては、「確証バイアス」「リスキーシフト」「一貫性バイアス」「自己中心性バイアス」「認知的不協和低減」「フレーミング」「アンカリング」「内集団バイアス」「投影バイアス」「自己奉仕バイアス」「外集団同質性バイアス」「後知恵バイアス」「生存者バイアス」「錯誤相関」「感情バイアス」などが挙げられています。個々の認知バイアスについての解説は省きますが、正常化の偏見(正常性のバイアス)から始まった認知バイアスの研究が、実に多くの認知バイアスの発見へと拡大して来たことがわかります。これまでに分かっている認知バイアスだけでも、最低160以上が見つかっています(Durmus, 2022)。
近年、認知バイアスと同様に社会心理的な態度のレベルでの「バイアス」として大きな社会問題として取り上げられるようになっているのは、「属性バイアス」という名の認知バイアスです。それは、いわゆる属性に基づいて人々の心に生じる差別意識や偏見のことです。その代表的なものは、ジェンダー・バイアス(セクシズム)、エイジ・バイアス(エイジズム)、人種・民族バイアス(レイシズム)、役割・地位・階級バイアス(ステーシズム)の四つです。悪意のない偏見という意味で「アンコンシャス・バイアス」(無意識のバイアス)と呼ぶこともあります。
もし、私たちの住む地球が理想的な世界であるならば、それは差別や偏見のいっさいない完全に平等な社会であるはずです。けれども、残念なことに、現状は個人の属性によって偏見の目で見られたり、差別を受けたりして、多くの人々が傷つき、大きな不利益を被っています。私たちの理想とする地球社会には程遠い状態です。幸い、これらの偏見、差別が従来の認知バイアスと同レベルの「バイアス」として問題にされつつあるのは、問題解決への第一歩として歓迎すべき動きと言えるでしょう。戦争や貧困などの社会問題も、さまざまなバイアスが原因となって起きることを考えれば、ユネスコが第二次大戦直後に指摘したように、戦争や貧困も私たちの「心」のあり方(バイアス)から引き起こされると言っても過言ではないでしょう。
(4) バイアス・フリー社会の実現
完全な「バイアスフリー」社会を達成することは、人間の認知構造の仕組み上、極めて困難です。なぜなら、認知バイアスは脳が膨大な情報を処理する際に使う「思考の省エネ(ショートカット)」機能であり、人間の生存に不可欠な仕組みの一部だからです。
しかし、バイアスやステレオタイプが「偏見」や「差別」へと発展することを防ぎ、公正で包摂的な社会を作るための多層的なアプローチを行うことは可能です。
1. 個人レベル:自覚とメタ認知の強化
認知バイアスそのものを消すことはできませんが、「自分にもバイアスがある」と認識すること(メタ認知)が第一歩となります。
- 無意識の偏見(アンコンシャス・バイアス)の可視化
自分がどのようなステレオタイプを持っているかを客観的に知るツール(IAT:潜在連合テストなど)を活用し、無意識の傾向を自覚する。 - クリティカル・シンキング(批判的思考)の習慣化
自分の直感や第一印象を鵜呑みにせず、「なぜそう思ったのか?」「反対の事実はないか?」と問い直す。 - 多様な視点・文脈への露出
自分とは異なる背景(国籍、ジェンダー、年齢、障害の有無など)を持つ人々の視点や歴史的背景に触れ、一見「当たり前」に見える基準を再考する。
2. 組織・教育レベル:仕組みによるバイアス補正
個人の意識改革だけに頼らず、偏見や差別が起きにくい構造やプロセスを設計することが重要です。
- ブラインド評価の導入
採用や評価の場において、名前・性別・年齢などの属性情報を伏せた状態でスキルや実績を評価し、先入観による判断を排除する。 - 多様性・公正性・包摂性(DEI)教育の推進
学校や職場において、バイアスの仕組みや差別の歴史、対話の手法を学ぶ機会を定常的に設ける。 - 意思決定プロセスの多様化
同質性の高いグループではバイアスが増幅しやすいため、多様な背景を持つメンバーが意思決定に参画できる仕組みを作る。
3. 社会・システムレベル:環境と制度の整備
個人の認知や組織のルールを超えて、社会構造全体で差別を防止・是正する取り組みが必要です。
| 領域 | 具体的なアプローチ |
| 制度・法律 | 差別禁止法の整備や、過去の差別による格差を補正する施策(アファーマティブ・アクションなど)の適切な運用。 |
| テクノロジー/AI | 学習データに含まれる差別や偏見を排除する「アルゴリズムの倫理設計」と継続的な監査。 |
| メディア・言語 | ステレオタイプを強化するような表現を避け、多角的で多様な表象(表現)を意識する。 |
バイアスをゼロにすることを目標にするのではなく、「誰しもバイアスを持っている」という前提に立ち、それが差別に繋がらないよう仕組みと対話で補正し続ける姿勢が、包摂的な社会づくりの核となります。
8. 人類とAIの共創
人類とAIの共創(Co-creation)について、「概念」「阻害要因」「促進方法」「社会的恩恵」の4つの観点から整理して解説します。
1. 人類とAIの共創とはどのようなものか
共創とは、AIを「単なる自動化ツール」や「人間の代替」ではなく、「知的なパートナー」として互いの強みを掛け合わせ、これまでにない価値を生み出す協働のあり方です。
- 役割の相乗効果:
- AIの強み: 大規模データの高速処理、複雑なパターンの認識、多様な選択肢の網羅的な生成、24時間無休の実行力。
- 人間の強み: 意味の理解、直感や感情、批判的思考、倫理的・道徳的判断、文脈を踏まえた意思決定。
- 対話的なループ: 人間が方向性(目的や問い)を示し、AIが生成・提案したアイデアやデータに対し、人間がフィードバックや修正(キュレーション)を加えてブラッシュアップしていく反復的なアプローチです。
2. 人類とAIの共創を阻んでいる要因
共創をスムーズに進めるうえで、技術・人間・制度の各面でいくつかのハードルが存在します。
- ブラックボックス性と信頼性の不足(可説明性の課題)
- 高度なAIモデルほど「なぜその判断やアウトプットに至ったか」のプロセスが見えにくいため、医療や金融、インフラなどの重要領域で人間が全幅の信頼を置くことが難しくなっています。
- ハルシネーションとバイアス
- 誤った情報を事実のように出力するリスク(ハルシネーション)や、学習データに含まれる偏見(バイアス)が不利益をもたらす懸念があり、チェックの手間が増える原因となっています。
- スキル gap と意識の乖離
- 「AIに仕事を奪われる」という対立的・脅威論的な心理的抵抗感や、AIに適切な指示(プロンプト)を出して出力を評価する能力(AIリテラシー・指示力)が現場に不足しています。
- 法的・権利的な不透明さ
- AIの生成物に対する著作権の取り扱い、AIの誤判断によって損害が生じた際の責任の所在、機密情報・プライバシーの保護規則がまだ発展途上です。
3. 人類とAIの共創を促進する具体的な方法
阻害要因を解消し、共創を加速させるためには、環境整備と人の能力開発の両面が必要です。
- 人間主導(Human-in-the-loop)の組み込み
- 完全に自動化するのではなく、「AIが提示・作成し、人間が評価・確定する」という協働ワークフローをシステム設計の標準とします。
- 説明可能AI(XAI)や根拠表示の強化
- AIの回答に対して裏付けとなる情報源や思考プロセスを明示させ、人間が検証・判断しやすい環境を整えます。
- リテラシーの向上と教育(問いを立てる力の育成)
- 単にAIの操作法を学ぶだけでなく、「課題の本質を見極める力(問いを立てる力)」や「AIの出力を批判的に評価・加工するキュレーション力」を育てる教育プログラムを導入します。
- 安全で透明性の高いガバナンス・ルール構築
- 企業内での機密データの扱い(オプトアウト機能の活用や閉じた環境での構築)や、AI利用に関する明確なガイドライン・著作権ポリシーを策定します。
4. 人類とAIの共創によってもたらされる社会的恩恵
共創が浸透することで、個人の働き方から社会インフラに至るまで大きな進歩が期待されます。
- 科学研究・医療の飛躍的加速
- 新薬の候補開発や新素材の発見において、AIが兆単位の組み合わせをシミュレーションし、研究者が解釈・実験することで、従来数十年間かかっていた研究開発スピードが劇的に短縮されます。
- 個別最適化された社会サービスの実現
- 教育分野では「個人の理解度や興味に完全に最適化されたAI学習パートナー」が実現し、医療・福祉では疾患の超早期発見やパーソナライズされた予防医療が普及します。
- 人間の創造性と生産性の高次元化
- 定型的・労働集約的なタスクから解放されることで、人間は「事業のコンセプト構築」「質の高いコミュニケーション」「共感や情動を伴うクリエイティブな表現」により多くの時間とエネルギーを注げるようになります。
- 複雑な地球規模課題へのアプローチ
- 気候変動シミュレーションやスマートシティにおけるエネルギー最適配分など、人間単独では処理しきれないマルチ変数の課題に対し、最適なソリューションを見出すことが可能になります。
参考文献:
アリストテレス(著)(1971) 高田三郎訳 『ニコマコス倫理学』(岩波文庫(上・下)
馬場雪之 (2023) 2023年度東京大学駒場祭公開講座『人間とAIの協働』発表スライド
James R. Beniger (1986) The Control Revolution: Technological and Economic Origins of the Information Society. Harvard University Press.
Blau, Peter M. (1964) Exchange and Power in Social Life . Routledge, New York. 間場寿一・居安正・塩原勉訳 (1974) 『交換と権力』新曜社
Buss, D. M. (2003). The Evolution of Desire: Strategies of Human Mating. Basic Books.(デイヴィッド・M・バス(著)、長谷川真理子(訳)『欲望の進化』バイオシス社)
カルチュラルエコロジー研究委員会編 (2001)『情報革命の光と影:カルチュラルエコロジーの視点から』NTT出版
Fisher, H., Aron, A., & Brown, L. L. (2005). “Romantic love: an fMRI study of a neural mechanism for mate choice.” Journal of Comparative Neurology, 493(1), 58–62.
エイミー・エドモンドソン『正しい失敗――不確実な世界で成功をつかむための失敗の科学』Erich Fromm (1956), The Art of Loving, Harper & Row.(エーリッヒ・フロム(著)、鈴木晶(訳)『愛するということ』紀伊國屋書店)
Fitz, Charles E. and H.B.Williams (1957) , The Human Beings in Disasters: A Research Perspective, The Annals of the American Academy of Political and Social Science, 309, pp.42-51.
Fritz, Charles E. (1958) , Disasters Compared in Six American Communities, Human Organization, 16, pp.6-9.
Fritz, Charles E. (1961), Disaster, in Robert K. Merton & R.A. Nisbet (eds.), Contemporary Social Problems, pp.651-694.
Giddens, A. (1992). The Transformation of Intimacy: Sexuality, Love and Eroticism in Modern Societies. Polity Press.(アンソニー・ギデンズ(著)、松尾精文ほか(訳)『親密性の変容』而立書房)
Gouldner, Alvin. R. (1960) “The Norm of Reciprocity : A Preliminary Statement.” American Sociological Review, Vol.25, No.2, pp.161 – 178.
Haeckel, Ernst (1866) Generelle Morphologie der Organismen: allgemeine Grundzüge der organischen Formen-Wissenschaft, mechanisch begründet durch die von Charles Darwin reformirte Descendenz-Theorie.(『有機体の一般形態学』)
林雄二郎 (1999) 「文化の文明化と文明の文化化」カルチュラルエコロジー研究委員会事務局編『コミュニケーション革命と文化』pp.101-114.
Hazan, C., & Shaver, P. (1987). “Romantic love conceptualized as an attachment process.” Journal of Personality and Social Psychology, 52(3), 511–524.
Illouz, E. (1997). Consuming the Romantic Utopia: Love and the Cultural Contradictions of Capitalism. University of California Press.
Jankowiak, W. R., & Fischer, E. F. (1992). “A cross-cultural perspective on romantic love.” Ethnology, 31(2), 149–165.
池田謙一「災害時における意思決定」広瀬広忠編 (1981) 『災害への社会科学的アプローチ』新曜社, pp.195-220.
川浦康至 (2023) 『卒業論文のデザイン : 質問紙調査による社会心理学研究』 福村出版
川上善郎編 (2001)『情報行動の社会心理学』「シリーズ21世紀の社会心理学」(北大路書房)
Leibniz, Gottfried Wilhelm (2019) ライプニッツ(著)『モナドロジー 他二篇』谷川多佳子、岡部英男(訳)岩波文庫
Lessig, Lawrence (2006) Code: Version 2.0 . Basic Books
Mauss, Marcel (2014) 『贈与論 他二篇』 森山工訳、岩波書店 (岩波文庫)
三上俊治 (1982)「災害警報の社会過程」, 東京大学新聞研究所編『災害と人間行動』東京大学出版会
三上俊治. (2023) 「生成AI時代の知的生産技術」(https://itsenior.jp/km/category/chiteki-seisan/)
水野博介 (1998)『メディア・コミュニケーションの理論』学文社
中村功著 (2021)『 災害情報と避難 : その理論と実際 』 晃洋書房
プラトン(著)、久保勉(訳)『饗宴』岩波文庫
Putnam, Robert D. (2000) Bowling Alone: The Collapse and Revival of American Community.
Popper , Karl (1960) Conjecture and Refutation : The Growth of Scientific Knowledge. Basic Books: New York.
Quarantelli, E.L. & Russell R. Dynes (1972) Images of Disaster Behavior: Myths and Consequences. Journal of Communication, 22(1), 67–70.
Rawls, John Bordley (1971) A Theory Of Justice.Harvard University Press. 川本隆史・福間聡・神島裕子訳『正義論』紀伊國屋書店、2010年
ジャン・ジャック・ルソー『人間不平等起源論』
Saint-Exupéry, Antoine Marie Jean-Baptiste Roger, vicomte de アントワーヌ・ド・サン=テグジュペリ『星の王子さま』内藤濯(1953年3月)。岩波少年文庫(新版2000年)。岩波文庫(2017年7月)
マシュー・サイド『失敗の科学――失敗から学習する組織、学習できない組織』
Sternberg, R. J. (1986). “A triangular theory of love.” Psychological Review, 93(2), 119–135.
Stuward, J.H. (1955)
Theory of Cultural Ecology : The Methodology of Multi-linear Evolution.
Tansley, Arthur (1935) The Use and Abuse of Vegetational Concepts and Terms
A. Tversky and D. Kahneman (1974) Judgment under Uncertainty: Heuristics and Biases. Science
. 1974 Sep 27;185(4157):1124-31.
山岸俊男 (1998) 『信頼の構造 : こころと社会の進化ゲーム』東京大学出版会
Young, L. J., & Wang, Z. (2004). “The neurobiology of pair bonding.” Nature Neuroscience, 7(10), 1048–1054.
東京大学新聞研究所編 (1980)『地震予知と社会的反応』東京大学出版会
吉井博明 (2001) 「メディアエコロジー」. カルチュラルエコロジー研究委員会編『情報革命の光と影』NTT出版会

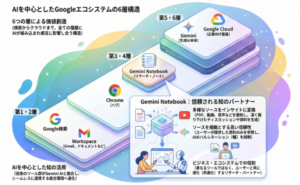
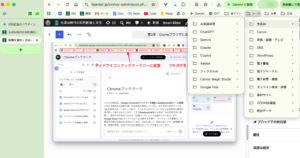
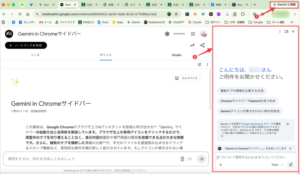
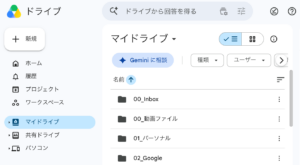
コメント